

Python3爬虫实战:如何正确构建并发送带Header的请求

本文详解Python3爬虫中请求头Header的构建方法。通过浏览器开发者工具Network面板提取User-Agent,结合Request类构造GET或POST请求,并演示使用urlopen发送请求的完整流程,帮助开发者有效伪装浏览器身份。
开发爬虫的第一步是学会配置请求头(Header),这是模拟浏览器行为、规避基础反爬机制的关键。接下来将简要解析在Python3环境下构建爬虫请求头的具体实现方式。
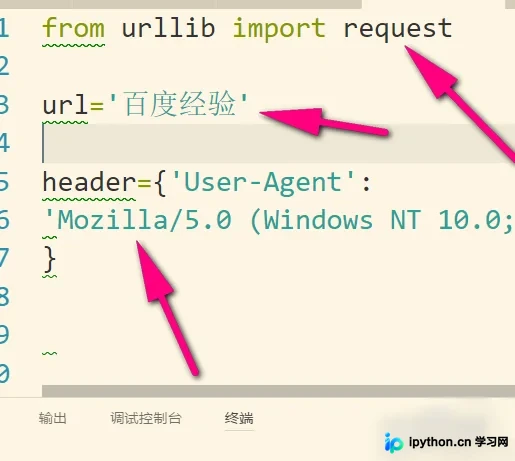
Python3与Python2在库的使用上存在差异,因此首先需要引入相关的请求模块。虽然Python2中可能没有特定的request封装,但在Python3中我们需要明确引入它。随后,将目标网址赋值给变量url,并创建一个字典用于存储Header信息,该字典的具体内容获取方法见后续步骤。
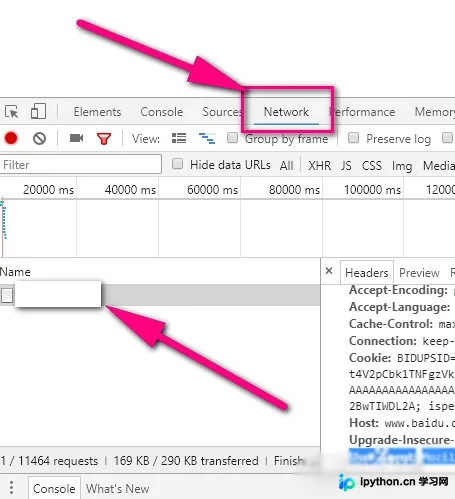
首先,在联网状态下打开任意浏览器页面,按下F12键打开开发者工具,切换到Network(网络)标签页。接着按F5刷新页面,此时列表中会出现“name”列,点击列表中的任意文件资源即可查看其详细信息。
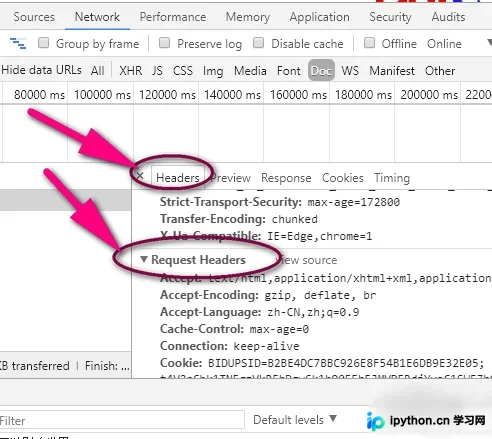
在右侧详情面板中,找到并点击Headers(标头)选项卡,向下滚动至Request Headers(请求标头)区域,这里包含了浏览器发送请求时携带的所有头部信息。
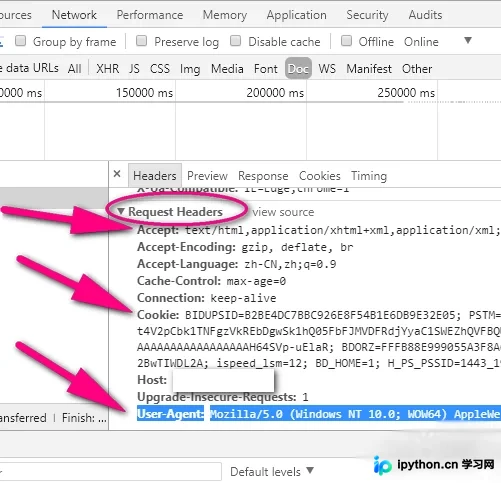
从Request Headers中复制User-Agent字段值。虽然Cookie和Accept等字段也可包含在内,但为了简化操作并主要实现浏览器伪装,此处仅使用User-Agent即可满足基本需求。
随后,利用Request方法将url和headers组合,构建一个基础请求对象。Request函数通常接受三个参数:url、data和headers。若传入data参数,则构成POST请求;若不传data,则为GET请求。在本例中,由于未使用data,必须显式指定headers=header,否则Python可能会将header参数误识别为data参数。
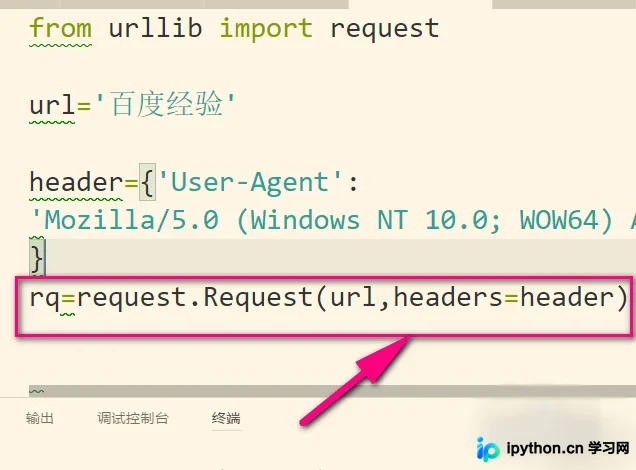
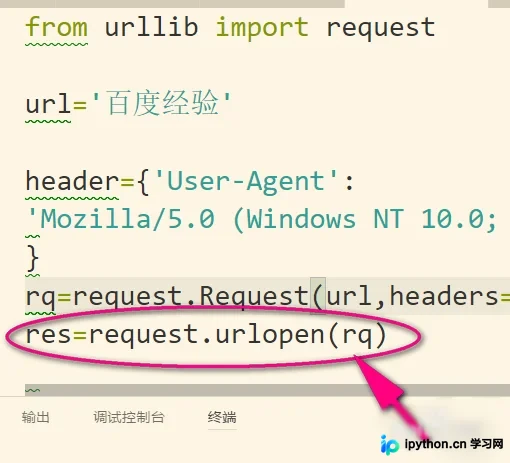
此时,请求对象rq已成功构造。最后,调用urlopen函数发送该请求对象,即可完成简单的请求头设置与数据获取流程。
综上所述,本文介绍了Python3爬虫中构建请求头的核心知识点。感谢阅读,希望本文内容对您有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









