

Python 3.x print函数格式化输出:左右对齐与数值处理详解
本文详解Python 3.x中print函数的格式化输出技巧,涵盖数字与字符串的左右对齐方法。通过%运算符演示右对齐(如%3d、%10.3f)及左对齐(%-3d)的具体用法,解析占位符含义及补零规则,帮助开发者掌握类似C语言printf的格式控制能力,实现精确的输出排版。
2026-10-13
21

本文详解Python 3.x中print函数的格式化输出技巧,涵盖数字与字符串的左右对齐方法。通过%运算符演示右对齐(如%3d、%10.3f)及左对齐(%-3d)的具体用法,解析占位符含义及补零规则,帮助开发者掌握类似C语言printf的格式控制能力,实现精确的输出排版。
本文介绍在Python3中利用csv模块将CSV文件数据读取并转换为字典格式的具体实现方式。通过示例代码展示了如何打开文件、获取字段名以及逐行处理数据生成字典对象,供开发者参考使用。
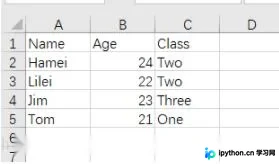
本文介绍如何使用Python将TXT文件内容逐行读取并转换为字典对象。通过按空格分割行数据,利用冒号提取键值对,最终生成包含多个字典的列表。代码特别处理了中文字符的编码问题,确保写入新文件时数据格式正确,适合需要批量处理结构化文本数据的场景。
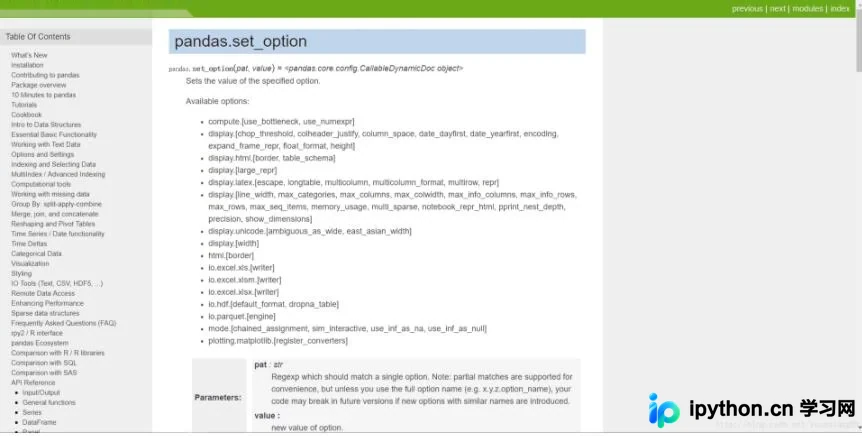
本文介绍在Python中使用Pandas打印Dataframe时,因行数过多导致中间数据显示省略号的问题。通过调用pandas.set_option()函数,配置display.max_rows为None及调整display.width,即可强制输出完整数据,避免信息截断。
本文介绍在Python中实现输入数字反向输出的具体方法。通过示例代码展示如何利用循环和取余操作完成数字反转,适用于初学者理解基础算法逻辑与字符串处理技巧。
本文介绍在 Python 中如何高效处理包含连续空格的字符串。通过结合使用 split() 和 join() 方法,可以自动忽略多余空格并将剩余单词用单个空格连接。例如 'line dd' 经处理后变为 ['line', 'dd'],再拼接即可得到规范化的单空格字符串,适用于数据清洗和文本预处理场景。
本文介绍如何利用Python pandas库进行数据差分运算。通过df.diff()方法,可实现纵向一阶、横向一阶及多阶(如periods=2)差分计算。文章包含完整代码示例,展示如何处理空值及不同轴向的差分结果,适用于时间序列分析与特征工程场景。
本文介绍了使用Python进行文本处理的三个核心步骤:去除HTML标签、提取指定长度的单词以及统计词频。通过DocProcess类封装strip_html、separate_words和get_words_frequency方法,实现从原始文本到词频字典的完整处理流程。代码展示了正则表达式在单词分割中的应用及字典计数逻辑,适用于基础文本分析场景。
本文详细介绍如何在Python中利用shapefile库读取Shp格式文件。通过具体代码示例,演示如何获取几何形状、记录信息及属性字段,包括遍历要素点坐标和解析记录数据,为GIS数据处理提供基础参考。
本文介绍如何利用Python的pandas库读取以竖线'|'作为分隔符的文本文件。通过指定sep参数为'|'并设置dtype为'str',可确保所有列数据均按字符串类型处理,适用于20180201.txt等格式文件的快速解析与预处理。
本文提供使用Python采集微信公众号文章的完整代码方案。通过搜狗微信搜索接口获取文章列表,利用PyQuery解析内容,并将结果存储至MongoDB。代码包含配置模块config.py及主程序采集公众号文章.py,支持关键词搜索、分页抓取及代理池配置,实测可有效运行,适合Python初学者参考学习。
本文介绍在Python文本预处理中,利用re模块的正则表达式功能,将字符串中的连续多个空格合并为单个空格,以及将连续数字替换为特定符号(如num)的方法。通过具体代码示例展示了re.sub函数的实际应用,适用于自然语言处理前的数据清洗场景。