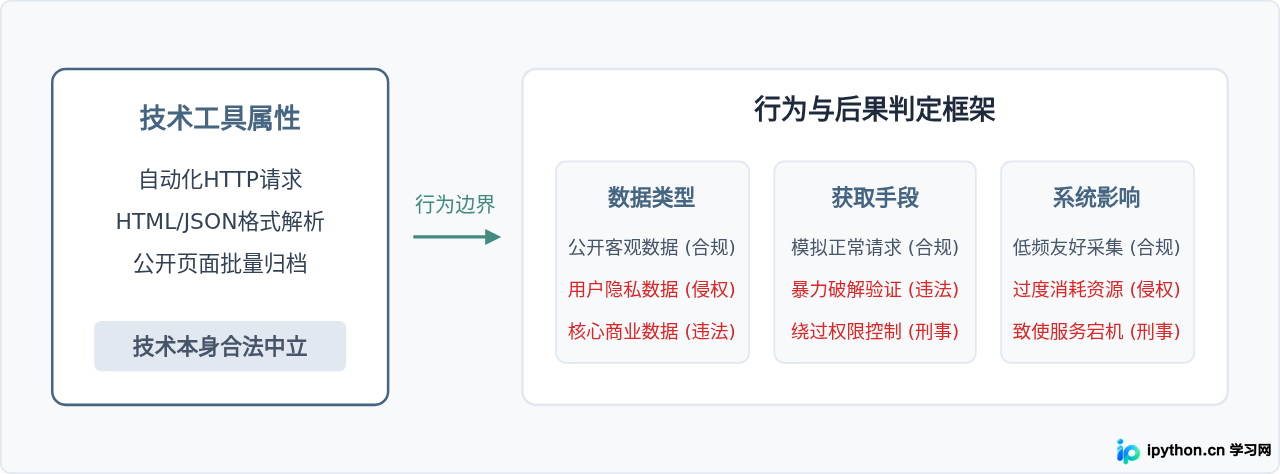
适合练手的Python小项目源码:爬虫、游戏与自动化工具
精选爬虫、游戏与自动化三大方向的Python入门练手项目源码,包含完整的实现逻辑、代码注释、运行验证与踩坑说明,帮助读者快速掌握实际开发技能。
2026-10-10
6

精选爬虫、游戏与自动化三大方向的Python入门练手项目源码,包含完整的实现逻辑、代码注释、运行验证与踩坑说明,帮助读者快速掌握实际开发技能。
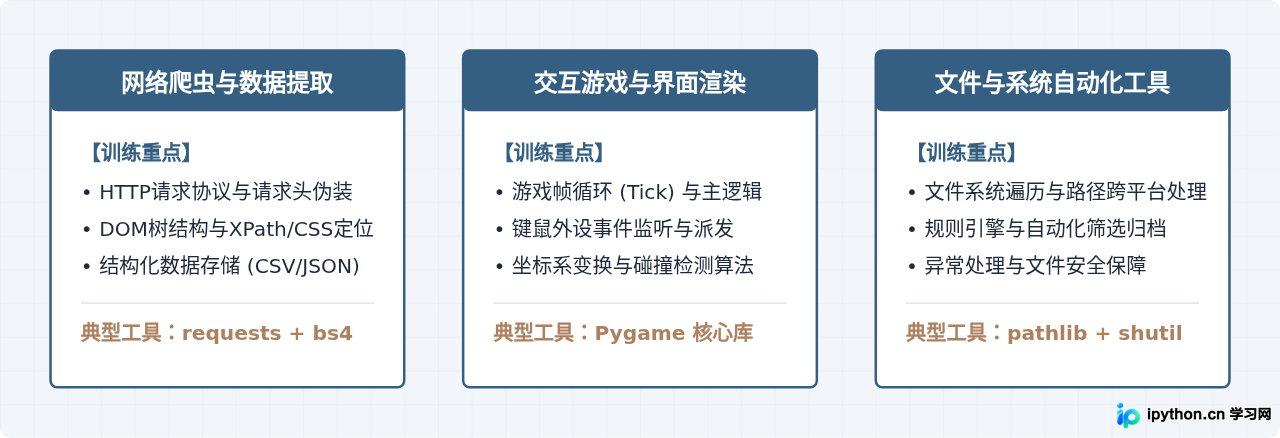
针对自学Python爬虫时买书与看视频的优劣势对比,提供阶段性搭配策略、筛选标准与避坑指南,帮助初学者高效选择适合自己的学习资料。
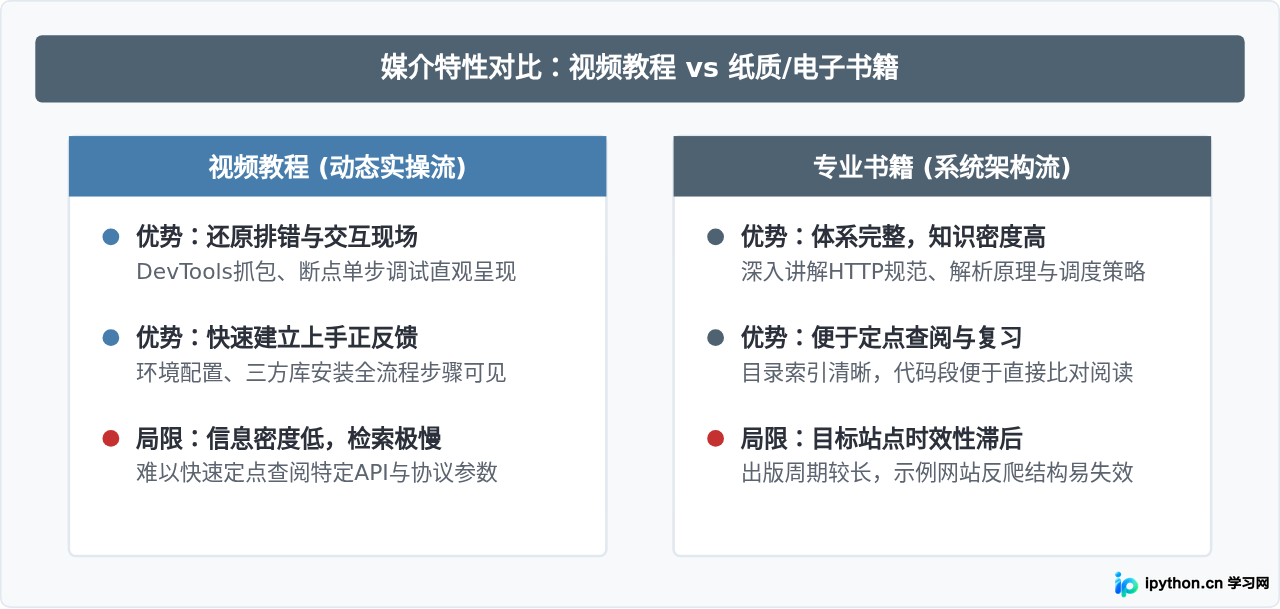
针对Python进阶学习者,提供高质量数据分析与网络爬虫百度网盘课程与配套资源的筛选标准、核心内容构成、实操获取与验证方法,帮助读者避开失效与低质资料。
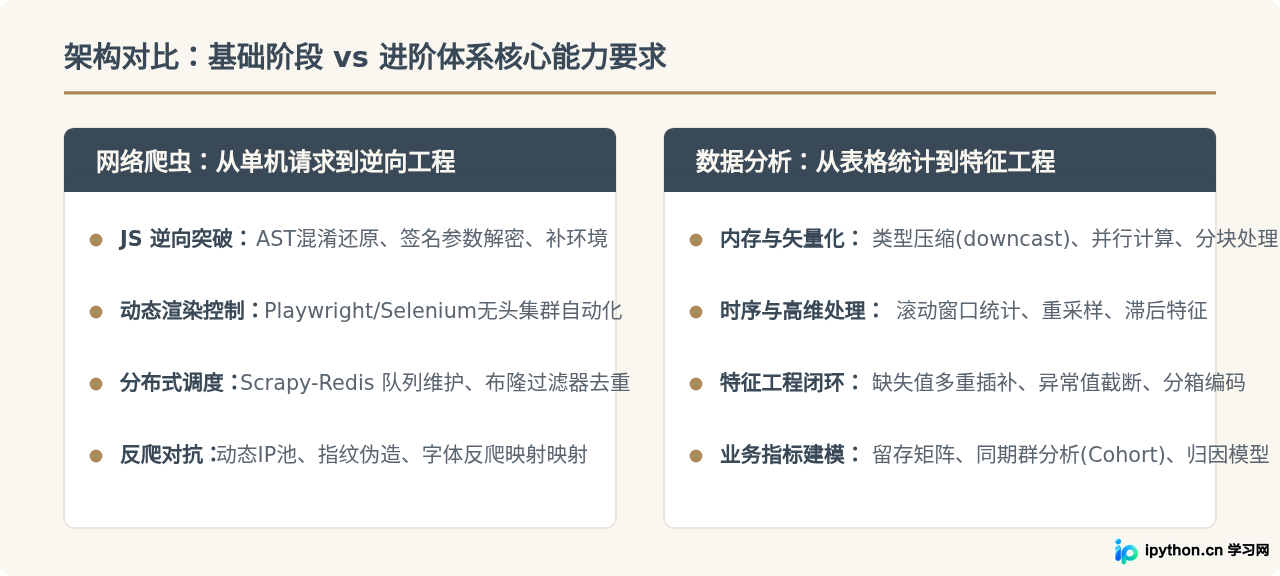
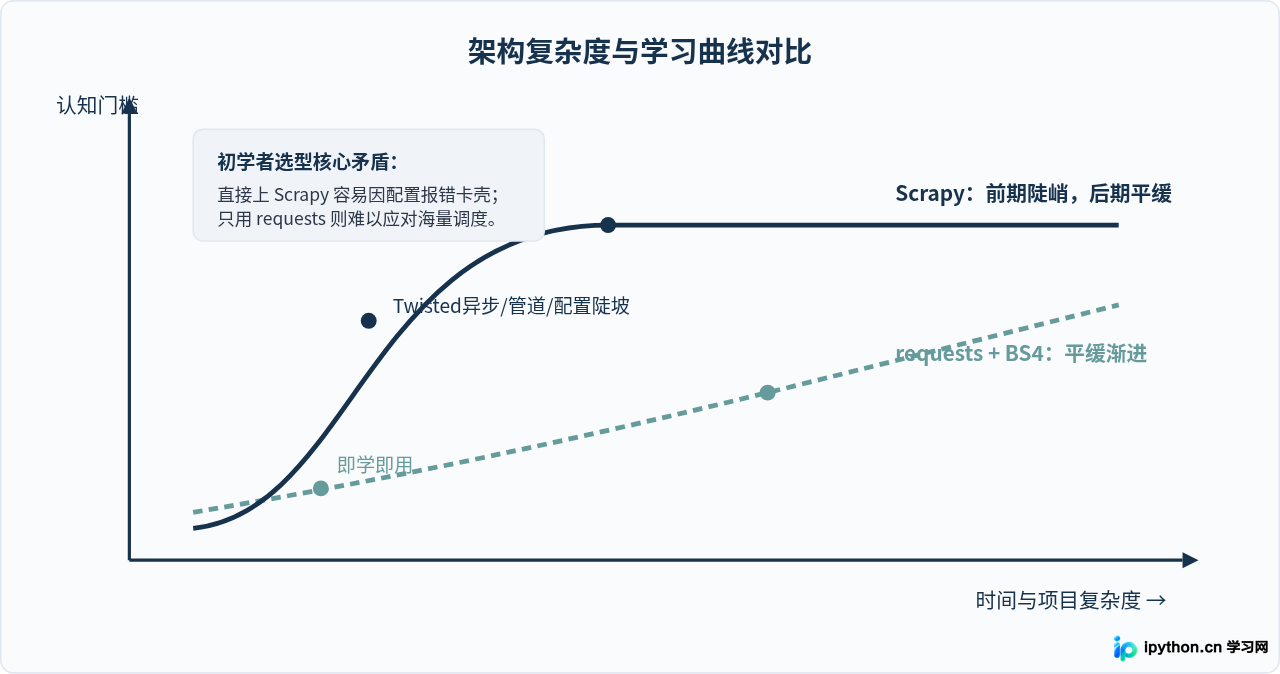
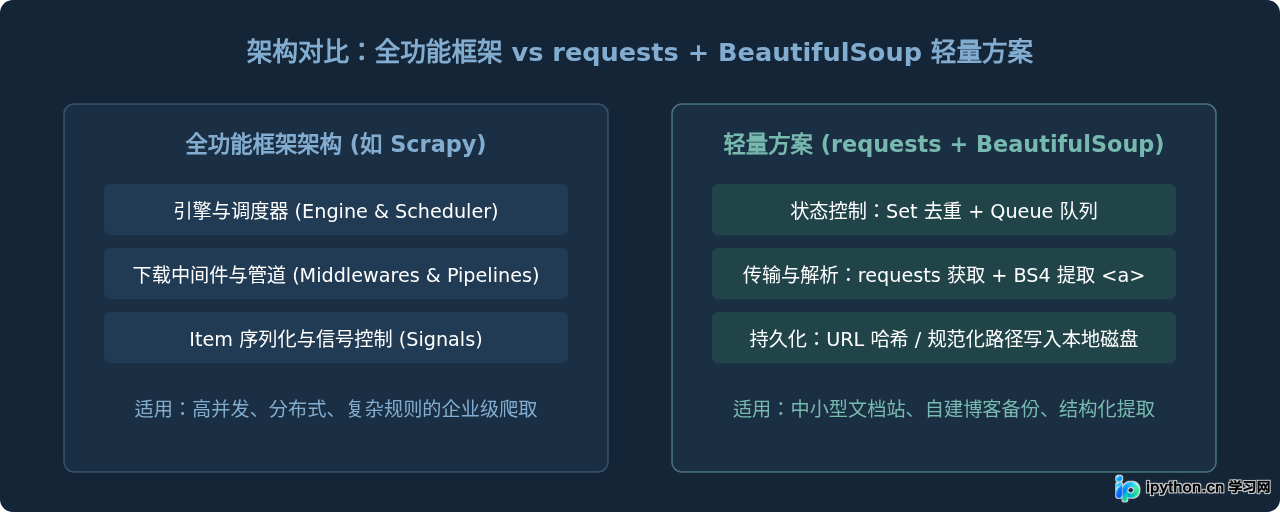
针对Python爬虫初学者在Scrapy与requests+BS4之间的选型困惑,深入对比两者的学习成本、架构复杂度、适用场景与演进路径,提供清晰可执行的决策建议。
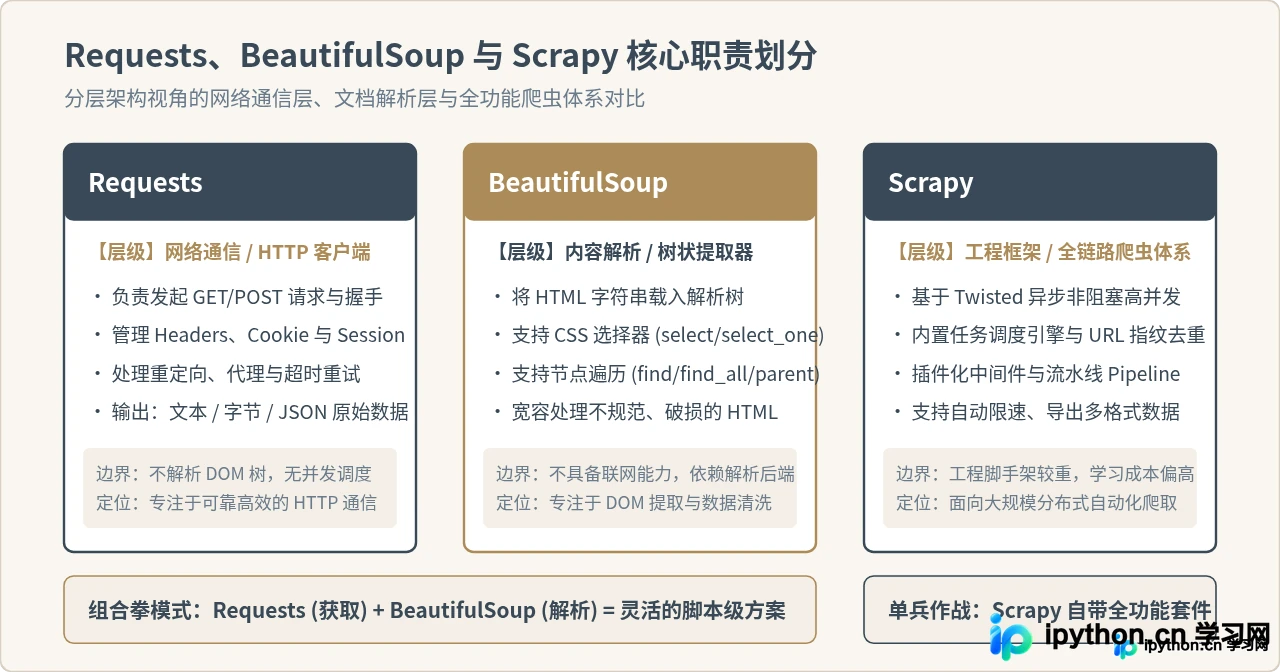
深入对比 Python 爬虫三大主流工具 Requests、BeautifulSoup 与 Scrapy 的定位差异、工作原理与适用场景,提供选型决策树与实践代码。
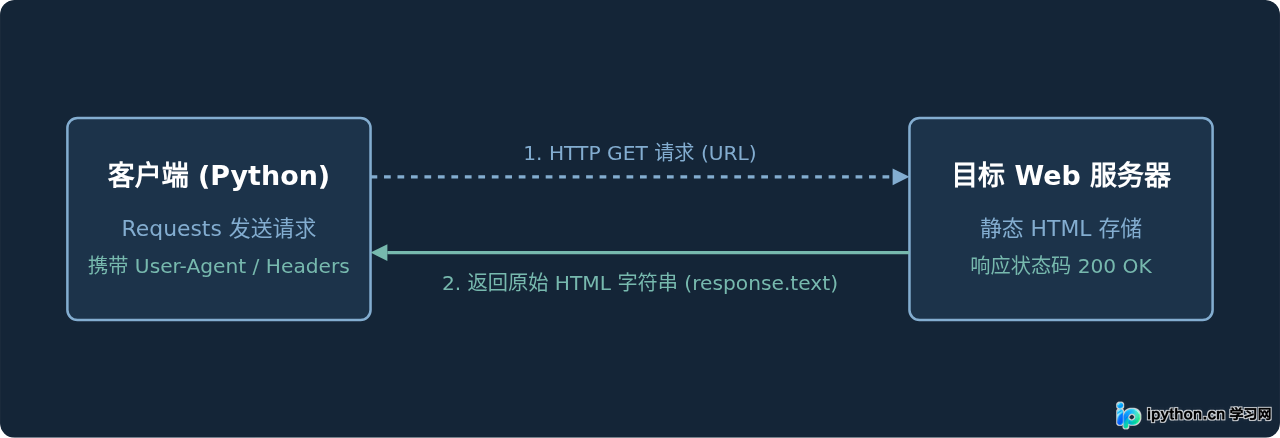
面向初学者的Python静态网页爬虫教程,系统讲解Requests网络请求与BeautifulSoup解析库的配合使用,包含环境安装、选择器提取、完整实战代码与常见问题排查。
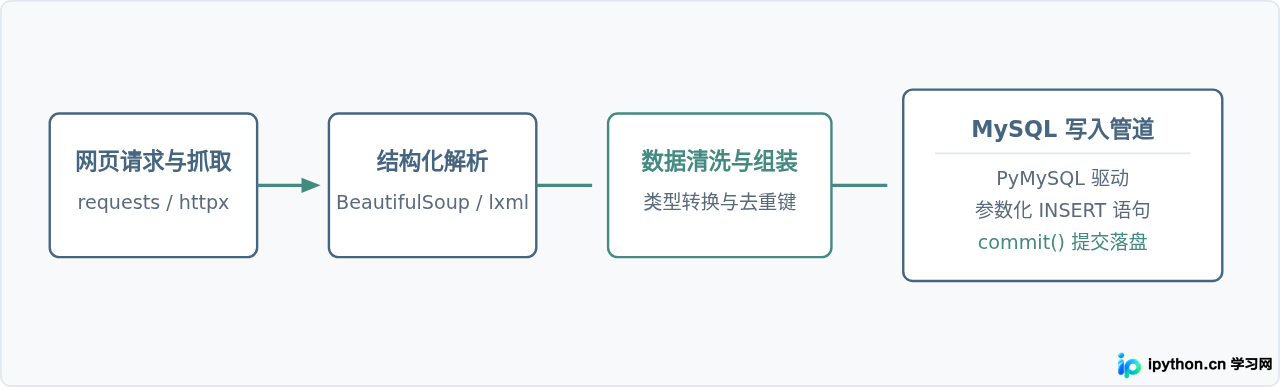
详细讲解Python网络爬虫如何将抓取并清洗后的结构化数据规范写入MySQL数据库,涵盖表结构设计、PyMySQL连接、参数化SQL、批量插入优化及异常重试机制。
本文讲解如何仅使用 Python 标准库配合 requests 与 BeautifulSoup 两个轻量模块,实现从单个入口页出发、递归抓取全站链接并批量将 HTML 页面持久化到本地磁盘的完整方案。
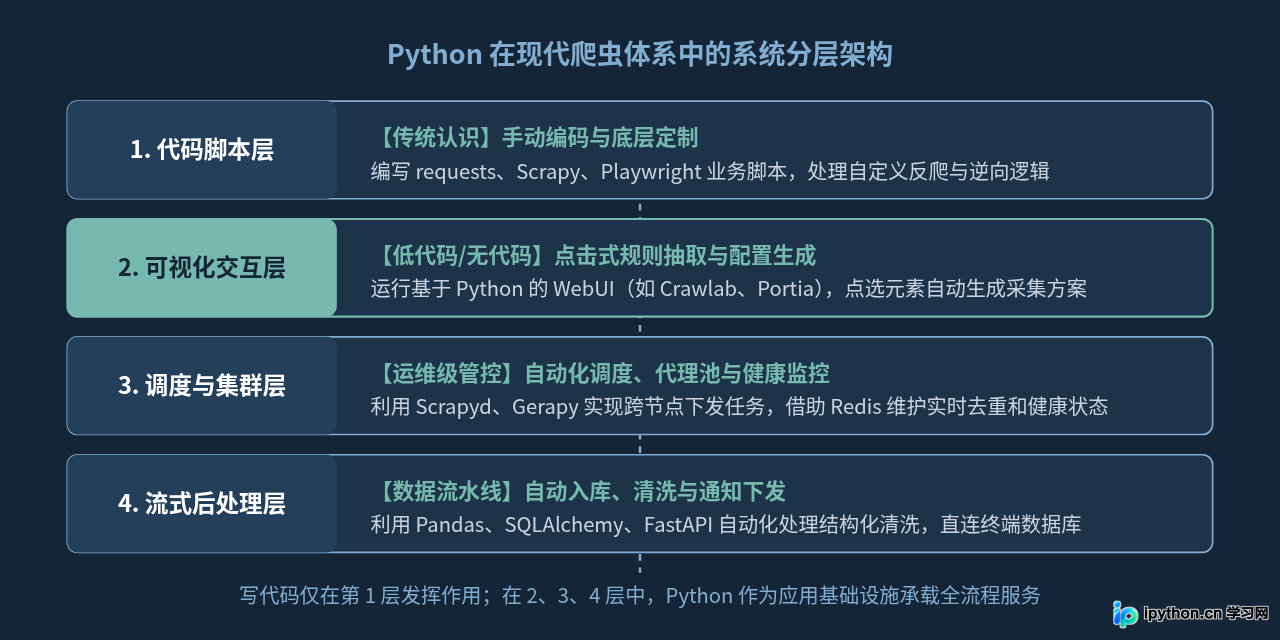
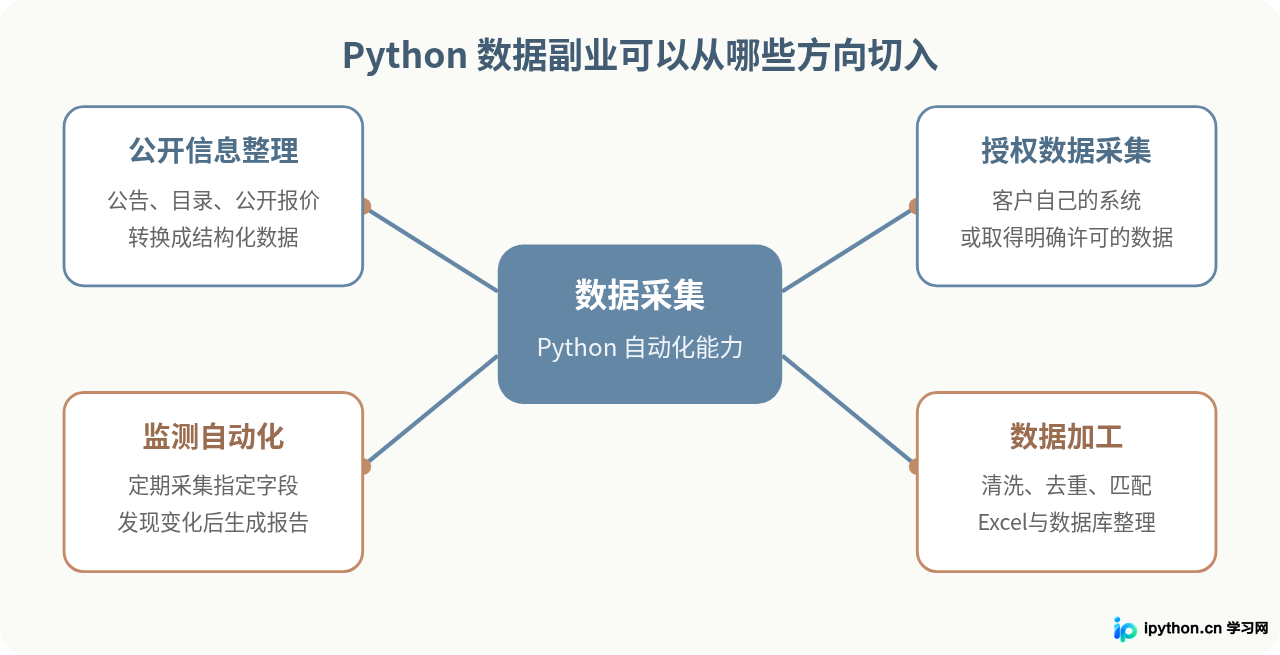
介绍Python爬虫可以承接的数据采集、监测、整理和自动化副业,说明公开数据、个人信息、登录数据、版权内容及反爬机制之间的边界,并给出接单前的合规判断流程和风险控制方法。
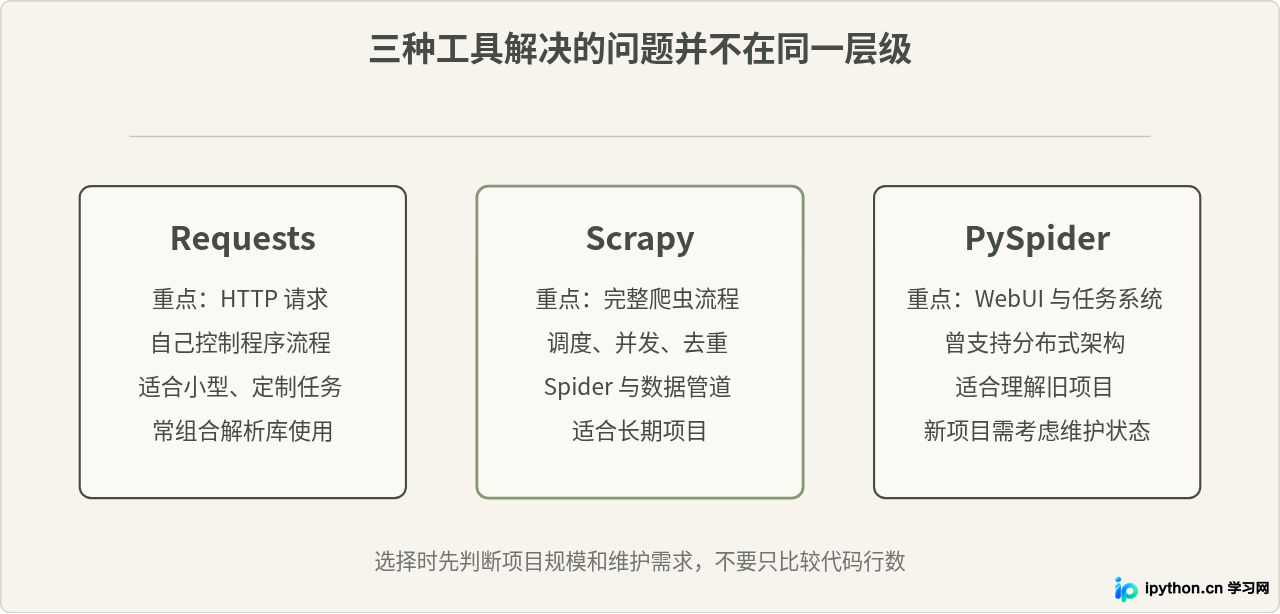
对比Python爬虫常见的Requests、Scrapy与PySpider,从学习成本、并发抓取、任务调度、数据处理、项目维护和适用场景等方面说明区别,并给出不同爬虫项目的选择方法。
详细解答写Python爬虫是否违法,梳理爬虫行为的三大法律红线,并深度解读robots.txt协议的规则语法、法律效力与实际代码解析方法。