Python实现网页抓取与jieba分词处理
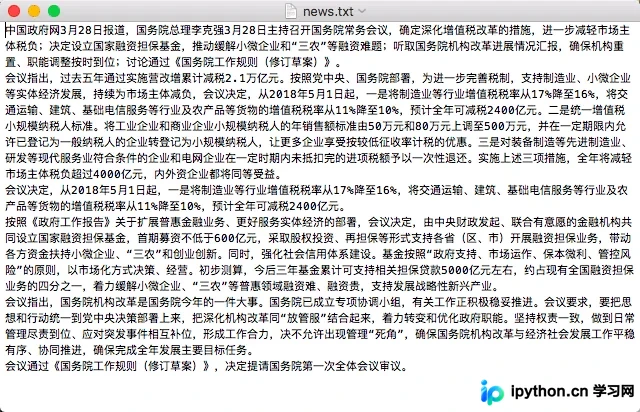
本文介绍如何使用Python的requests和BeautifulSoup库抓取指定网页的正文内容,并利用jieba库对提取的文本进行分词处理。通过具体代码示例,展示了从获取HTML、解析DOM、提取文本到写入文件及分词输出的完整流程,适用于简单的网页内容分析与预处理场景。
2026-10-11
6

本文介绍如何使用Python的requests和BeautifulSoup库抓取指定网页的正文内容,并利用jieba库对提取的文本进行分词处理。通过具体代码示例,展示了从获取HTML、解析DOM、提取文本到写入文件及分词输出的完整流程,适用于简单的网页内容分析与预处理场景。
本文介绍如何使用 Python 第三方库 tomorrow 实现简单的并发爬虫。通过对比串行与并发请求获取电影网站标题的耗时,展示 threads 装饰器的用法。文章包含安装步骤、完整代码示例及性能测试结果,并给出并发数设置的优化建议。
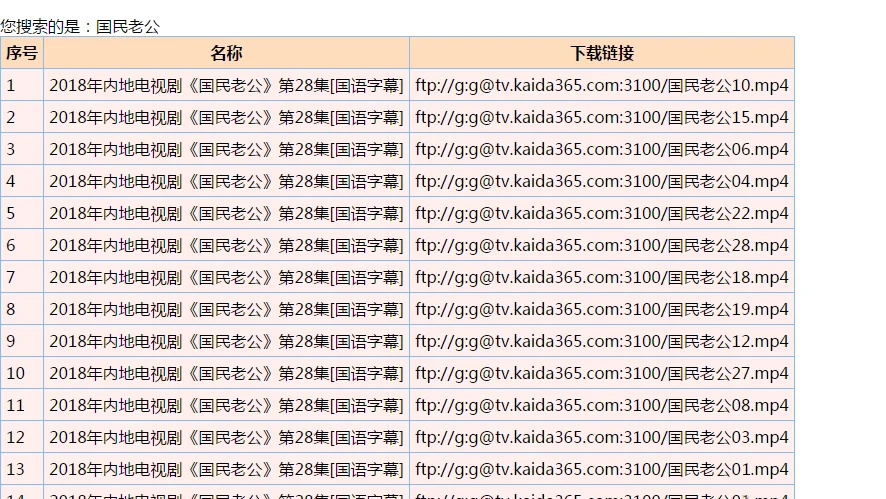
本文介绍如何利用Python3.6结合urllib和BeautifulSoup库,根据电影或电视剧名称自动获取下载链接。通过构建搜索URL、解析HTML页面、提取详情链接及最终下载地址,实现自动化抓取。代码包含处理编码、过滤特定类型内容及模拟浏览器请求等关键步骤,适用于学习网络爬虫基础及数据提取技术。
本文介绍使用Python3通过urllib库抓取微信网页版账单数据的方法。重点解析如何从Fiddler抓包获取exportkey、userroll_encryption及pass_ticket参数,解决SSL证书验证问题,并实现分页数据解析与数据库存储。
本文介绍如何在 Python 循环中定时中断执行某一段程序。通过 threading.Timer 实现定时切换账号,避免使用 sleep 导致进程停止。利用多线程释放 GIL 锁的特性,实现定时切换账号和爬取数据的并行执行。
本文介绍了如何使用 Python 实现带有验证码的网页登录。通过保存验证码图片供人工识别,并利用 Cookie 保持会话状态,分两次向服务器 POST 请求(首次提交账号密码,二次提交验证码)来完成登录流程。
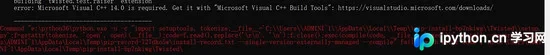
本文详细解析Python Web框架Django与爬虫框架Scrapy的安装流程。内容涵盖Python版本检查、pip工具配置、virtualenv虚拟环境创建,以及解决Scrapy安装中常见的Twisted依赖和Visual C++编译环境报错问题,帮助开发者顺利完成开发环境搭建。
本文详细介绍如何在 Selenium Python 中配置爬虫代理 IP。通过 ChromeOptions 添加 --proxy-server 参数,可解决反爬限制并提升抓取效率。文章涵盖代理类型选择、多线程注意事项及代码实现,帮助开发者高效部署爬虫。
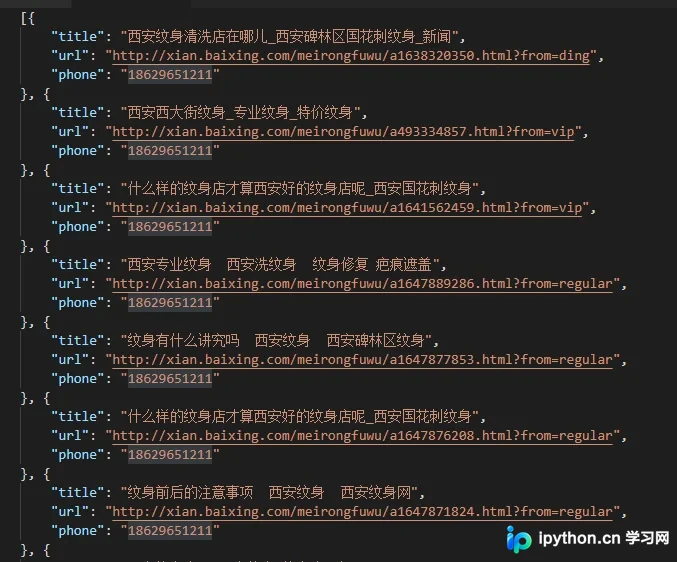
本文介绍如何使用Python3结合requests、lxml和json模块,爬取百姓网列表数据并保存为JSON格式。文章详细讲解了环境准备、代码实现及文件保存步骤,适合初学者参考学习。
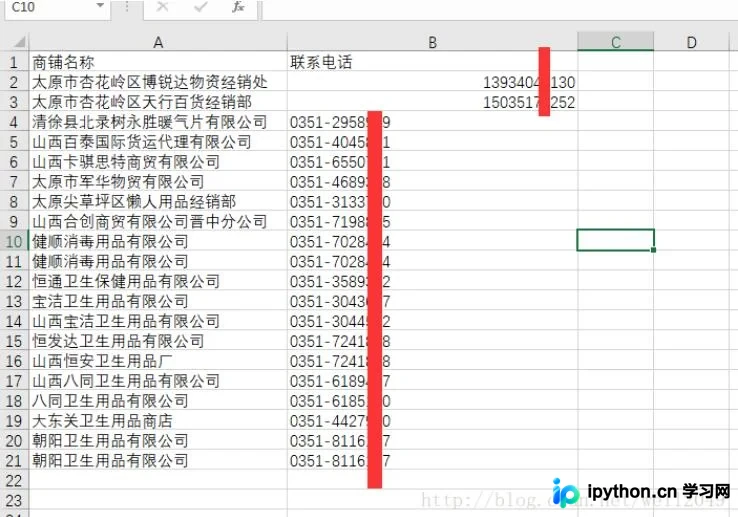
本文介绍如何使用 Python 爬取 114 黄页的商家联系电话及名称。通过 requests 获取页面源码,利用 BeautifulSoup 解析 HTML 结构,提取特定 div 下的列表数据。代码包含翻页逻辑、请求头设置及 CSV 文件写入,适合初学者学习基础爬虫开发。
在使用Python爬虫抓取网页时,若目标URL包含空格,服务器通常会返回400状态码(Bad Request)。这是因为标准HTTP协议要求URL中不能直接包含未编码的空格字符。本文详细解析了该问题的成因,并提供了使用Python标准库对URL进行编码处理的具体代码示例,确保爬虫能正常访问含特殊字符的链接。
本文提供8个基于Python的实用自动化脚本,涵盖网络请求重试、按内容重命名、清理过期文件、拦截高负载进程、操作前自动备份、任务完成系统通知、轻量级数据采集及按后缀归类归档。结合环境配置说明与完整代码,助开发者快速构建稳定高效的工作流。