Python利用lxml和XPath解析HTML详解
本文介绍如何在Python中使用lxml模块结合XPath语法解析HTML文档。通过对比jQuery和正则表达式,演示如何定位特定节点、提取文本及处理嵌套结构,并详细解析XPath基本语法如路径分隔、属性过滤及节点函数,帮助开发者掌握高效的网页数据抓取技巧。
2026-10-12
7

本文介绍如何在Python中使用lxml模块结合XPath语法解析HTML文档。通过对比jQuery和正则表达式,演示如何定位特定节点、提取文本及处理嵌套结构,并详细解析XPath基本语法如路径分隔、属性过滤及节点函数,帮助开发者掌握高效的网页数据抓取技巧。
本文介绍使用Python编写爬虫脚本,自动抓取淘宝和天猫商品页面的主图、SKU颜色展示图以及详情页长图。通过正则表达式解析HTML数据,利用requests库发起请求并保存本地图片,实现一键批量下载功能,适用于电商数据分析与素材收集场景。
本文介绍使用Python语言抓取双色球历史开奖信息的方法。通过urllib2和BeautifulSoup解析网页,获取截至2016年5月15日的1940期数据。代码包含获取总页数、提取开奖号码及日期等逻辑,旨在为后续的技术分析和预测提供数据基础。
本文详细介绍在Python中处理HTML转义字符的五种方法。涵盖Python2的HTMLParser模块、Python3中html.parser的迁移、Python3.4新增的html.unescape推荐用法,以及xml.sax模块的支持方案。文章对比了各版本的兼容性与废弃状态,帮助开发者选择合适的数据清洗工具。
本文详细讲解在Windows 10环境下安装Python 3.6的关键步骤,包括环境变量配置和路径长度限制处理。针对Scrapy和PyQt等常用库的安装报错问题,提供了基于本地whl文件的解决方案。此外,汇总了pip批量安装、版本管理及一键升级的高效命令,帮助开发者快速搭建Python开发环境。
本文详解Python网络爬虫中常见的乱码问题,涵盖中文、日文等多语言编码处理。通过解析HTTP Header、Meta标签及Document定义确定源编码,并介绍使用chardet库自动检测编码的方法。结合Python 2.7实例,演示如何正确进行字符串解码与编码转换,确保数据准确存储。
本文介绍了一种在Python爬虫开发中批量管理后台进程的方法。通过nohup命令在后台运行脚本并将进程ID(PID)追加至文件,随后利用Python读取该文件并执行kill命令,实现一次性终止大量挂起的爬虫任务。文章同时指出了进程复用可能导致误杀的风险,提供了实用的批量进程控制思路。
本文详细介绍如何利用Python的WebSocket库与asyncio异步编程技术,构建一套高效的直播弹幕实时采集系统。通过解析WebSocket消息、设计日志与JSON双格式存储以及使用队列缓存高频数据,实现了从接收、解析到落盘的完整闭环,为后续的情感分析与舆情监测提供稳定数据支持。
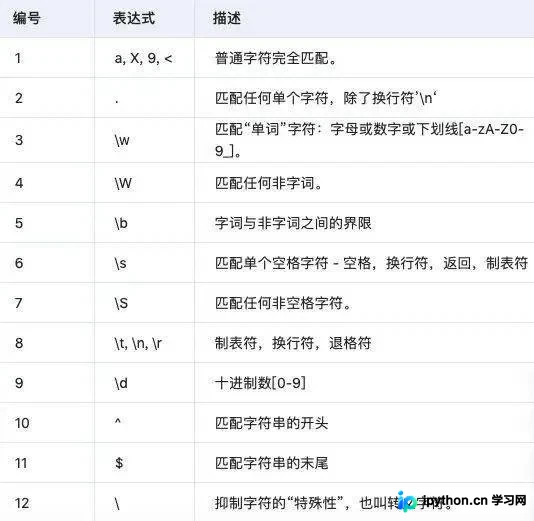
本文深入解析 Python 中 re 模块的核心功能,详细讲解 match、search 和 sub 函数的语法与区别,涵盖字符类、分组、锚点等特殊语法。通过具体代码示例展示如何在爬虫和数据分析中高效处理字符串,帮助开发者掌握正则表达式的实际应用技巧。
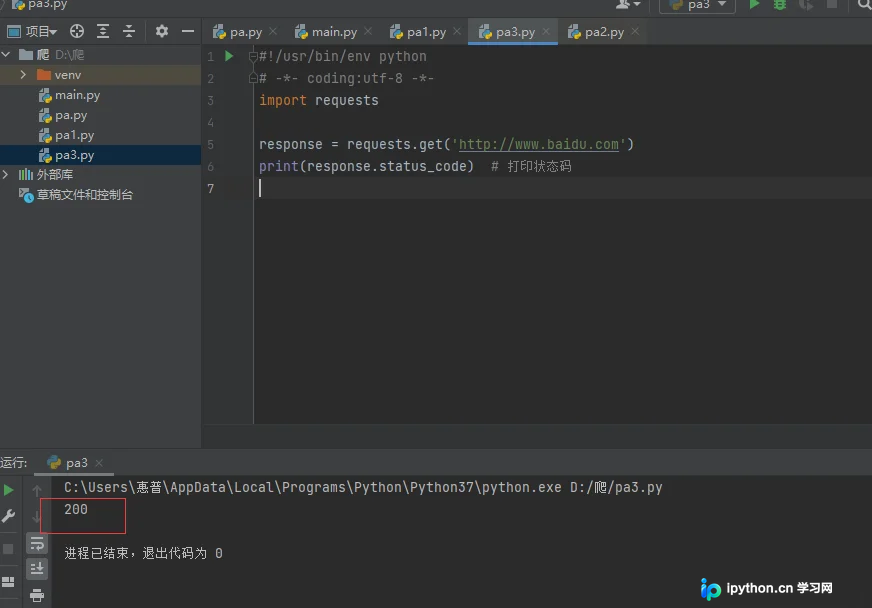
本文详细解析Python中requests库的核心用法,涵盖安装配置、GET与POST请求参数传递、JSON解析、文件保存、Headers与代理设置、Cookie会话维持、证书验证及超时异常捕获等关键操作,帮助开发者高效构建稳定的网络爬虫程序。
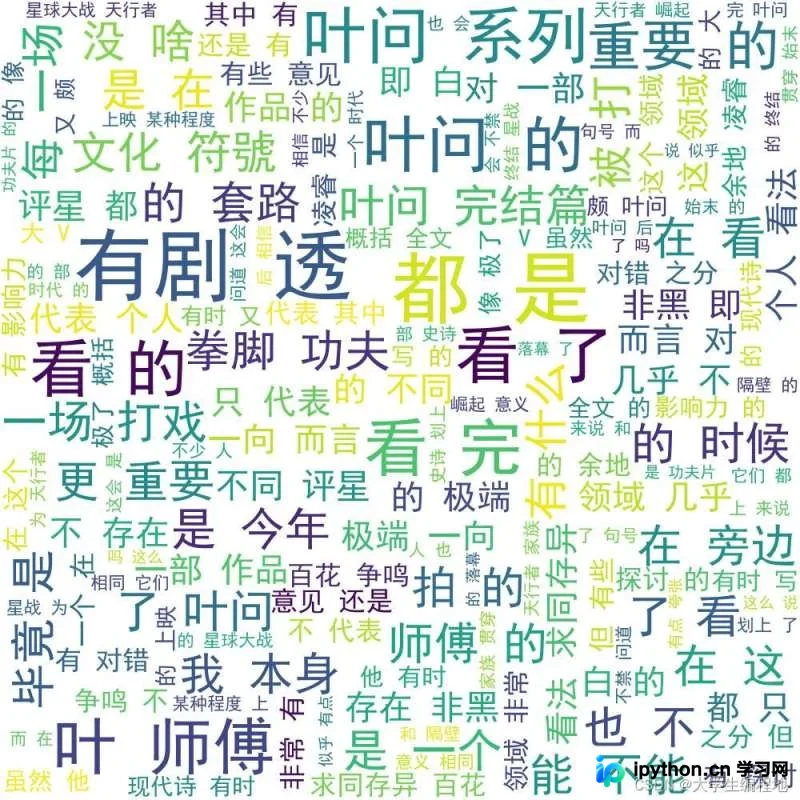
本文详细介绍如何使用Python采集豆瓣电影热评并自动生成词云。流程涵盖通过requests与lxml解析目标页面、批量保存评论至JSON文件,以及利用jieba进行分词去噪后调用wordcloud渲染可视化图表。文章提供完整可执行代码、关键参数配置说明及运行避坑指南,适合希望快速掌握网络数据抓取与文本可视化技术的开发者参考。
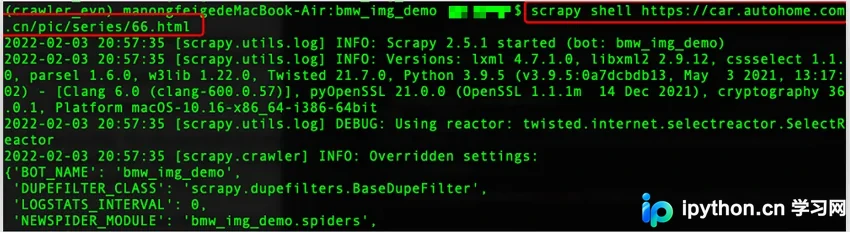
在 Python 爬虫开发中,直接使用 Scrapy 框架验证复杂的 XPath 或 CSS 选择器往往需要运行完整流程,耗时且容易打断工作流。本文详细介绍如何使用 Scrapy shell 交互终端在不启动爬虫的情况下实时抓取页面数据,快速调试提取规则,并提供标准的虚拟环境配置步骤与关键操作命令,大幅提升数据采集逻辑的验证效率。