Python抓取微信公众号最新推送:Selenium与Requests实战
本文介绍如何使用Python抓取指定微信公众号的最新推送文章。针对搜狗微信搜索链接的时效性及动态网页渲染问题,结合Requests与Selenium+PhantomJS技术获取HTML内容,并通过BeautifulSoup提取链接。代码包含处理验证码提示、跨平台文件路径构造及带时间戳的文件保存逻辑,旨在提供一套完整的抓取示例供参考。
2026-10-13
7

本文介绍如何使用Python抓取指定微信公众号的最新推送文章。针对搜狗微信搜索链接的时效性及动态网页渲染问题,结合Requests与Selenium+PhantomJS技术获取HTML内容,并通过BeautifulSoup提取链接。代码包含处理验证码提示、跨平台文件路径构造及带时间戳的文件保存逻辑,旨在提供一套完整的抓取示例供参考。
本文详细讲解如何利用Python的requests和BeautifulSoup库,系统性地爬取安居客郑州地区的二手房源数据。内容涵盖列表页HTML结构分析、房源链接提取、分页逻辑处理(递归调用与下一页判断)以及详情页数据抓取。通过具体代码示例,展示如何构建完整的爬虫流程,包括请求头设置、DOM节点定位及数据清洗,为地理信息分析提供数据支持。
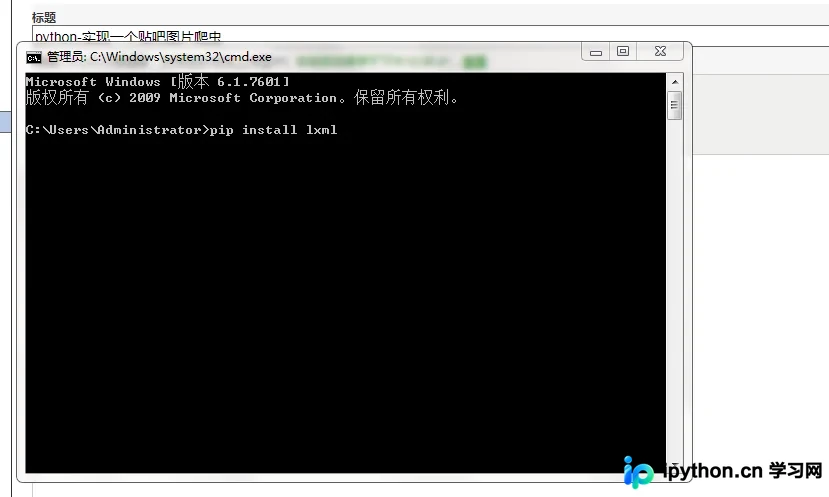
本文详细介绍如何使用Python2编写贴吧图片爬虫。通过安装Lxml库并利用Chrome插件辅助分析HTML结构,利用XPath精准定位图片链接。文章包含完整代码示例及注释,指导开发者从环境搭建到代码运行,实现批量下载指定贴吧的图片资源。
本文详细介绍如何利用Python 3编写图片爬虫,从京东网站批量下载编程类图书封面。通过解析URL分页规律,结合正则表达式对HTML源码进行两次过滤,精准提取商品图片链接,并使用urllib库实现本地存储。文中包含完整代码示例及异常处理逻辑,适用于学习网络爬虫基础与数据抓取技术。
本文针对Windows 10环境下Python 3.6.64位安装Scrapy时遇到的“Microsoft Visual C++ 14.0 is required”错误,提供无需编译的解决方案。通过从UCI LFD网站下载对应版本的Twisted whl文件,并使用pip命令本地安装,可绕过编译工具缺失问题,成功完成Scrapy部署。
本文详解Python爬虫中代理Proxy的配置方法,涵盖urllib和requests两大模块。通过构建ProxyHandler、设置环境变量及Basic Auth语法,实现透明、匿名及高匿代理的灵活调用,助力解决复杂抓取场景。
本文介绍利用Python3.4从HTTP代理网站批量抓取代理IP并进行有效性筛选的方法。通过多线程并发测试目标网站连接速度与响应内容,快速剔除无效代理,提取可用IP列表,解决爬虫IP被封问题。
本文介绍基于Python3.4编写的简易爬虫程序,利用urllib和re模块抓取指定微博用户的头像图片。代码包含设置User-Agent、处理Cookie及正则表达式匹配等关键步骤,适合初学者学习网络请求与数据解析基础。
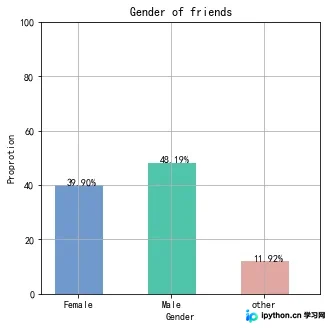
本文介绍如何使用Python的itchat库登录微信并获取好友信息,结合matplotlib库进行数据可视化。通过实例代码展示如何统计好友的性别比例并绘制柱状图与饼图,同时按省份分类排序并生成省份分布图。最后提供将数据保存为CSV文件的方法,供Excel查看。
本文介绍使用Python 2.7结合urllib与BeautifulSoup库,实现从京东网站批量爬取商品图片的方法。通过解析页面DOM结构获取图片链接与商品名称,自动创建目录并按名保存。代码包含URL构造、异常处理及进度显示,适用于学习网页抓取与文件存储操作。
本文介绍使用 Python 的 requests 库和 lxml 解析器,通过保持 Session 状态和处理 CSRF Token,实现登录 Bitbucket 并爬取受保护页面内容的完整流程。代码展示了从获取登录页、提取令牌、提交凭证到抓取目标数据的标准操作步骤,适用于需要身份验证的网页数据抓取场景。
本文介绍Python爬虫基础,详解urllib库的URL组成、请求发起及Response处理。重点讲解HTTPError与URLError的捕获顺序与属性获取,通过百度首页抓取及404错误示例,展示代码实现与调试方法,帮助初学者掌握网络请求与异常处理核心技能。