

Python Scrapy实战:京东商城数据爬取进阶教程
本文深入讲解使用Python Scrapy框架爬取京东商城的进阶技巧。内容涵盖构造奇数页请求、解析首屏数据、处理Ajax异步加载的后半部分商品信息,以及通过Meta传递参数。同时提供断点续爬、下载延迟、随机延迟、忽略Robots协议及并发控制等settings.py配置技巧,帮助开发者高效获取商品详情并避免被封禁。
2026-10-13
9

本文深入讲解使用Python Scrapy框架爬取京东商城的进阶技巧。内容涵盖构造奇数页请求、解析首屏数据、处理Ajax异步加载的后半部分商品信息,以及通过Meta传递参数。同时提供断点续爬、下载延迟、随机延迟、忽略Robots协议及并发控制等settings.py配置技巧,帮助开发者高效获取商品详情并避免被封禁。
本文介绍使用Python正则表达式抓取网易新闻评论的方法。通过抓包工具定位隐藏评论接口,利用urllib2发起请求并获取HTML数据,再经正则处理提取JSON中的评论字段。代码包含分页处理、异常捕获及文件写入逻辑,适合Python初学者参考正则在爬虫中的应用。
本文详细记录了使用Python和WordPress搭建小说站点的完整过程。内容涵盖WordPress主题选择、利用Python进行定向数据采集与MongoDB存储、通过wordpress_xmlrpc及MySQL直接插入实现内容更新,以及基于Flask部署微信公众平台接口。旨在为技术爱好者提供从后端数据抓取到前端展示及微信互动的实战参考方案。
本文详细介绍Python中利用urllib库进行网页抓取的核心方法。涵盖通过urlopen直接保存页面、构建Request对象实现POST与GET请求,以及利用geturl和info处理重定向与元数据。重点解析中文内容的encode与decode编码解码技巧,帮助开发者快速掌握基础爬虫技能。
本文详解如何利用Python的Requests库模拟网站登录并维持Cookie状态。针对nosec.org等需要动态Token的网站,通过解析页面获取authenticity_token,结合用户名密码POST提交,实现自动登录。文章提供完整代码示例,解析Session对象复用机制,帮助开发者解决爬虫登录验证及会话保持问题。
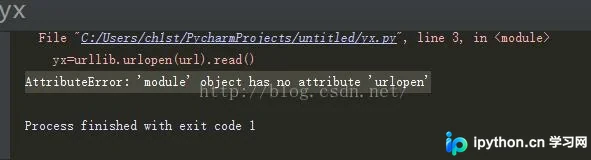
本文针对Python 3版本中urllib库无法直接使用urlopen导致的AttributeError错误提供解决方案。由于Python 3对urllib模块进行了重构,原urllib2等功能已并入urllib.request子模块。文章详细说明了正确的导入方式及代码示例,帮助开发者快速修复爬虫脚本中的模块调用问题。
本文详解使用Python爬取搜狗图片壁纸的全过程。针对网页动态加载特性,通过F12开发者工具分析Network中的XHR请求,定位获取图片列表的真实API接口。利用requests库发送请求并解析JSON数据,结合urllib实现图片的批量下载,提供完整代码示例与调试技巧。
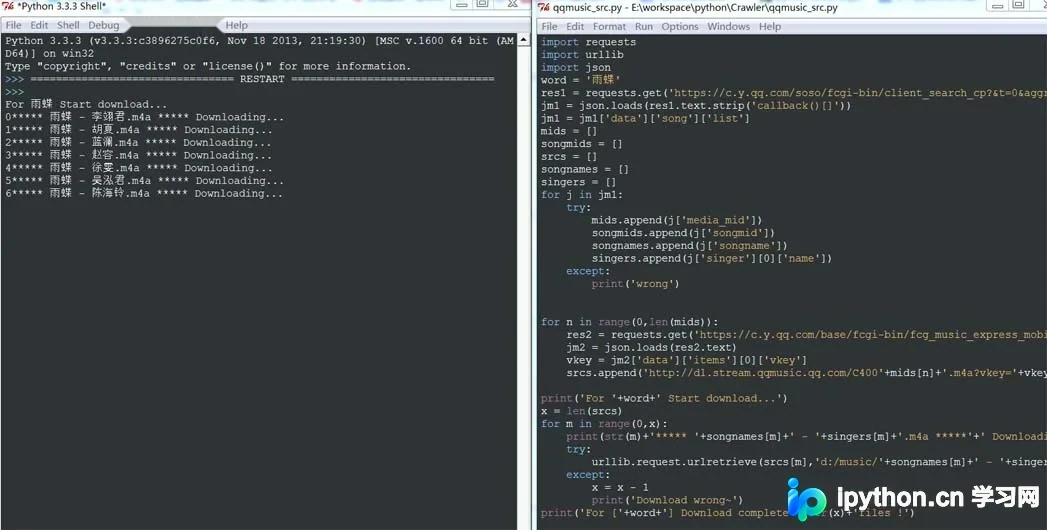
本文详细介绍如何利用Python编写爬虫程序,通过构造特定URL参数获取QQ音乐的播放链接(vkey),并实现批量下载功能。文章涵盖从搜索接口到文件下载的完整流程,提供Python 3.3.3环境下的代码示例与运行效果分析,适合希望自动化获取音乐资源的开发者参考。
本文系统讲解Python函数的基础知识,涵盖内置函数库(字符串、数学、网络、OS)的使用方法,详细演示httplib2第三方库在Windows下的安装步骤及网页爬虫示例,并深入解析自定义函数的定义、返回值处理及参数预设规则,帮助初学者掌握Python编程核心技能。
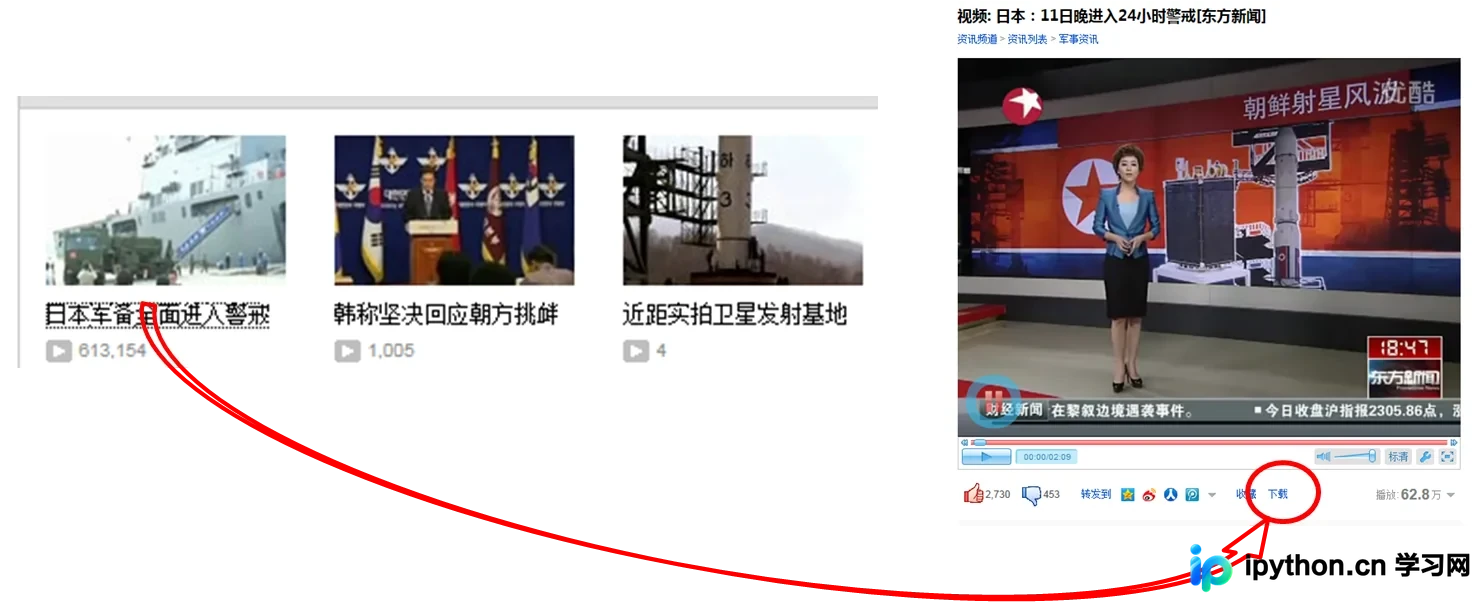
本文介绍使用Python 2.7结合BeautifulSoup3.2.1实现优酷视频批量下载的方法。通过解析网页数据获取播放链接,利用Python的os.system调用iku命令行工具完成下载。文章详细说明了程序逻辑、环境配置及注意事项,旨在提供一种实用且高效的视频数据采集方案。
本文详解Python爬虫中常见的403禁止访问错误原因,介绍通过urllib2模块添加User-Agent、Host和Referer等请求头来伪装浏览器访问的方法,并提供封装好的随机User-Agent选择函数代码,帮助开发者绕过基础反爬限制。
本文介绍使用Python的PIL库识别教务系统验证码的方法。通过增强对比度去除彩色干扰,将图片二值化为黑白字符,再裁剪为单字符小图。利用固定位置特性,将字符转换为01矩阵并与预设模板进行相似度比对,从而实现简单验证码的自动识别与登录。
