Python爬虫实现图片写入Word文档的解决方案
本文介绍了一种将Python爬虫获取的图片写入Word文档的方法。针对直接保存二进制数据导致乱码的问题,提出先本地保存图片、利用python-docx库插入图片后再删除本地文件的思路。通过具体代码示例,展示了如何结合requests和BeautifulSoup解析网页,并使用docx库实现图文混排保存,供爬虫开发者参考。
2026-10-13
7

本文介绍了一种将Python爬虫获取的图片写入Word文档的方法。针对直接保存二进制数据导致乱码的问题,提出先本地保存图片、利用python-docx库插入图片后再删除本地文件的思路。通过具体代码示例,展示了如何结合requests和BeautifulSoup解析网页,并使用docx库实现图文混排保存,供爬虫开发者参考。
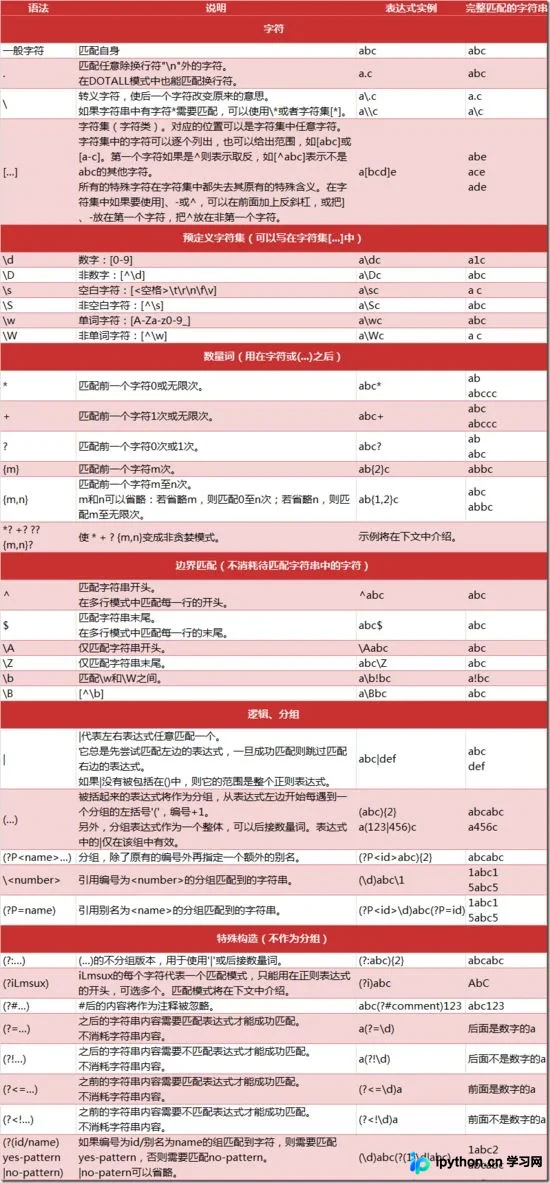
本文详解Python中re模块的核心用法,涵盖match与search的区别、贪婪与非贪婪匹配、分组提取及编译优化。通过HTML解析、字符串替换等实例,演示如何高效利用正则表达式进行数据抓取与处理,助力爬虫开发。
本文深入解析Scrapy框架的数据流向及核心组件。详细阐述引擎、调度器、下载器与Spider间的数据交互过程,并重点剖析DownloaderMiddleware与SpiderMiddleware的作用位置及核心方法,包括process_request、process_response和process_exception的具体行为与返回值处理,帮助开发者掌握Scrapy内部机制。
本文详细介绍Python中BeautifulSoup库的基础使用方法。内容涵盖库的安装命令、HTML文档的引入方式,以及利用find、select等API提取标题、属性、文本及特定标签的实操技巧,帮助开发者快速掌握HTML数据解析核心技能。
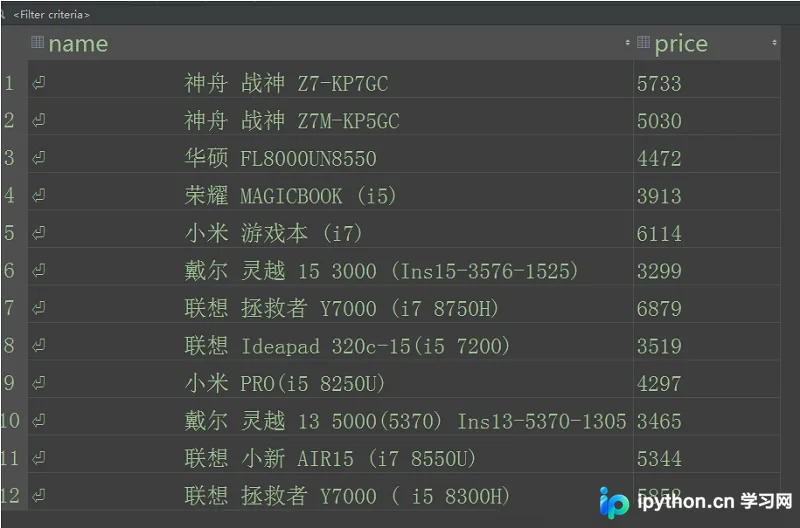
本文介绍如何使用Scrapy框架结合PhantomJS处理动态加载网页数据。通过配置Selenium中间件拦截请求,利用JavaScript渲染页面源码,并在Spider中解析HTML提取商品信息。随后通过Item定义数据结构,利用Pipeline将数据写入SQLite数据库,完整演示从配置到入库的技术流程。
本文详细介绍Python中Proxypool库的安装与配置流程。从GitHub下载源码并解压开始,指导用户修改关键配置文件路径,通过命令行执行依赖安装命令,并对ProxyGetter模块中的部分代码进行注释处理。最后提供简单的测试方法,帮助用户快速搭建可用的代理池环境,适用于爬虫开发场景。
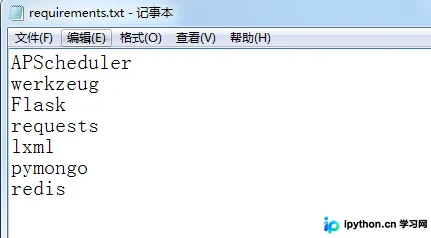
本文详细介绍在Windows系统中手动安装Python爬虫框架Scrapy的全过程。重点解析lxml、parsel、twisted等核心依赖库的安装方法,针对Windows下常见的Twisted编译报错问题,提供通过Gohlke官网下载离线whl文件并手动安装的解决方案,确保读者能顺利搭建开发环境。
本文详细介绍使用Python抓取豆瓣影评数据的两种方法。首先通过PC端网页分析URL参数,利用Requests和BeautifulSoup解析HTML并递归获取评论;随后介绍更高效的移动端模拟策略,通过修改User-Agent直接调用豆瓣移动端API接口获取JSON数据,简化解析流程并提高抓取效率。
本文介绍如何利用 Python 和 Twilio 服务实现自动发送短信功能,适用于爬虫异常通知等场景。通过注册 Twilio 账号获取免费额度,仅需10行代码即可完成配置与发送,包含 account_sid、auth_token 等关键参数设置,帮助开发者快速建立即时通讯机制。
本文介绍了8个适合Python业余项目或快速原型的优秀第三方库。涵盖Dataset用于数据库即时存储、Beautiful Soup处理HTML、Requests简化HTTP交互、Click构建CLI、Python Slugify生成SEO友好链接、Pluggy实现插件系统、DataSette转换CSV为API以及Envparse管理环境变量。这些工具能显著缩短开发周期,提升代码质量与可维护性。
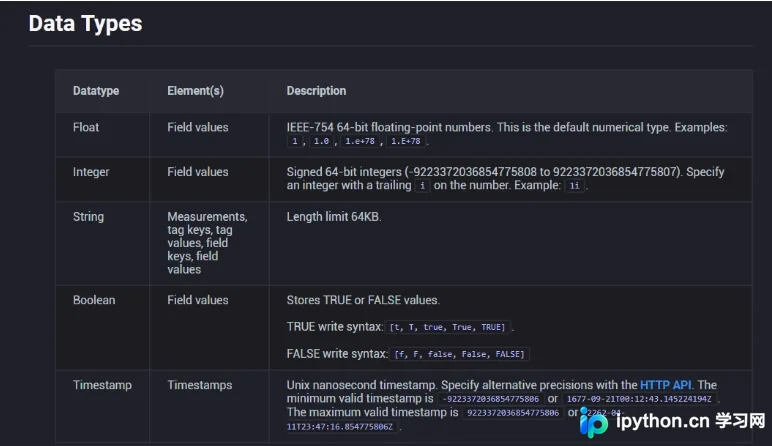
本文详解使用Python脚本将网卡数据写入InfluxDB并通过Grafana可视化的完整流程。重点解析数据采集脚本中字段类型必须为int或float以避免no datapoint错误的核心陷阱,以及10秒采集间隔的常规设置。文章提供基于telegraf数据库的InfluxDBClient配置代码及Grafana SQL图形配置示例,帮助开发者快速搭建稳定的网络监控体系。
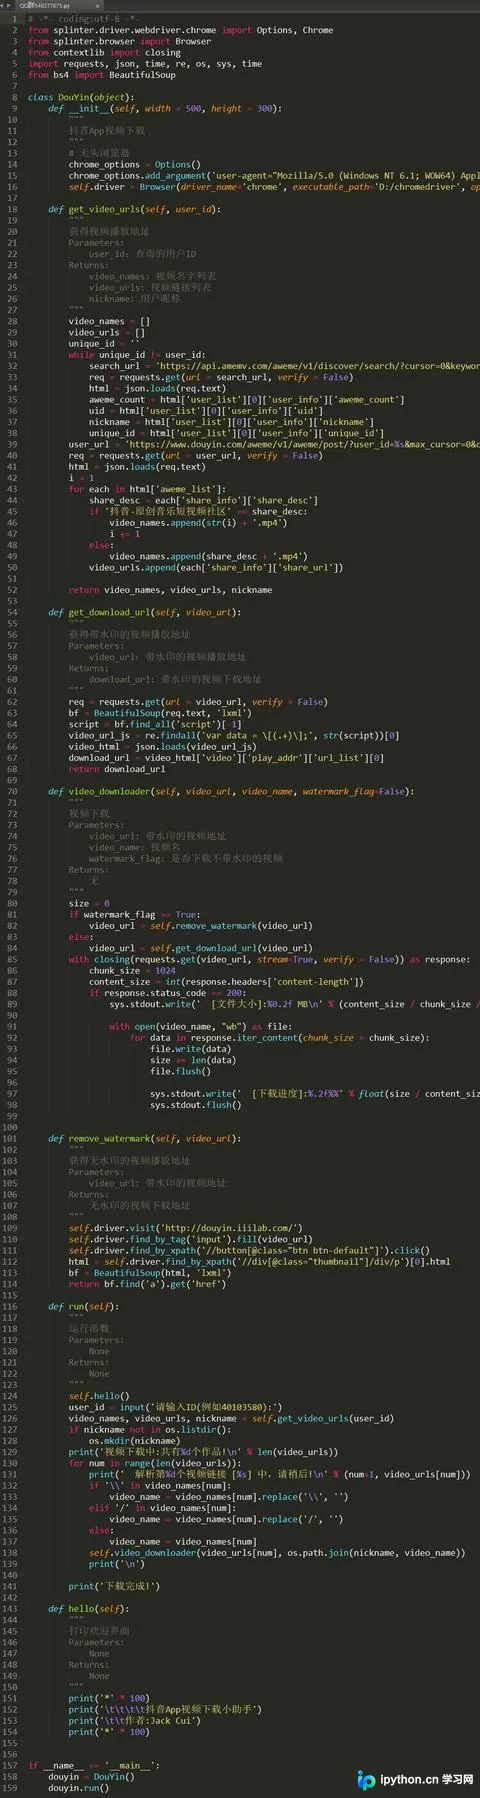
本文介绍两种Python实现抖音无水印视频下载的方法。第一种利用去水印平台接口,通过Splinter无头浏览器模拟操作以绕过付费解析限制;第二种基于URL字符串替换技巧,直接修改播放地址中的特定参数获取无水印源。文章提供了相关代码逻辑与注意事项,旨在帮助开发者快速实现视频抓取功能。