Python爬虫技巧:使用fake-useragent库伪造随机User-Agent
本文介绍如何在Python爬虫中通过fake-useragent库生成随机User-Agent以绕过反爬机制。详细讲解安装方法、调用API获取特定浏览器UA及随机UA的代码示例,并提供手动维护UA列表的替代方案,帮助开发者模拟真实用户行为。
2026-10-13
8

本文介绍如何在Python爬虫中通过fake-useragent库生成随机User-Agent以绕过反爬机制。详细讲解安装方法、调用API获取特定浏览器UA及随机UA的代码示例,并提供手动维护UA列表的替代方案,帮助开发者模拟真实用户行为。
本文详解如何在Python爬虫中利用单例模式高效获取高匿IP代理。针对网站反爬机制,通过复用代理对象避免频繁请求被封禁,结合User-Agent随机切换提升成功率。文章提供基于快代理的完整代码实现,涵盖Python 3.6环境下的代理获取、解析及单例类设计,助开发者稳定运行爬虫任务。
本文分享使用Python爬取微信公众号文章的完整代码示例。通过构建IP代理池、多线程并发抓取页面链接及内容,并存储至MySQL数据库,实现了高效的数据采集方案。代码包含详细的请求处理、异常捕获及线程同步逻辑,供开发者参考学习。
本文介绍基于Python 3.5.2的爬虫实现,通过urllib请求网页并解析HTML获取图片链接。利用正则表达式匹配图片URL,结合urllib.request.urlretrieve将图片保存至指定目录。代码包含异常处理与User-Agent设置,适用于学习网络数据采集基础操作。
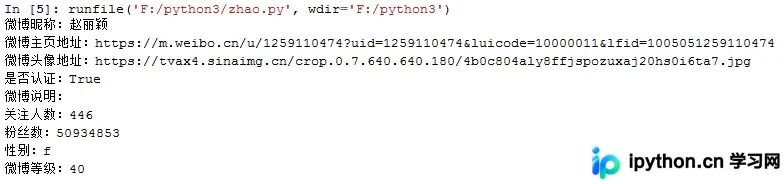
本文详细介绍如何使用Python编写爬虫程序,通过配置代理IP抓取新浪微博移动端(m.weibo.cn)大V的微博内容。文章涵盖前期准备、抓包分析思路及完整可运行代码,演示如何获取containerid并解析微博文本、点赞、评论及转发数据,帮助开发者快速掌握基础爬虫技巧。
本文详细介绍如何利用Python的itchat库实现微信个人号的扫码登录,并通过get_friends函数提取好友备注、昵称、性别及地区等详细信息。代码示例展示了如何遍历好友列表并将结果保存至本地文本文件,为个人数据管理提供参考。
本文介绍在Python爬虫开发中,如何利用jsonpath-rw模块高效提取JSON数据。文章对比了传统字典取值方式的局限性,演示了从requests或scrapy获取响应后转换为JSON对象的过程,并通过具体代码示例展示了jsonpath-rw的基本用法及值提取技巧,帮助开发者更灵活地处理复杂JSON结构。
本文介绍在Python爬虫开发中如何自动创建目标文件夹。通过os.path.exists判断路径存在性,若不存在则使用os.makedirs创建多级目录。同时补充了Python中处理文件名、后缀、目录分割及遍历重命名等常用文件操作技巧,帮助开发者更高效地管理爬虫数据存储。
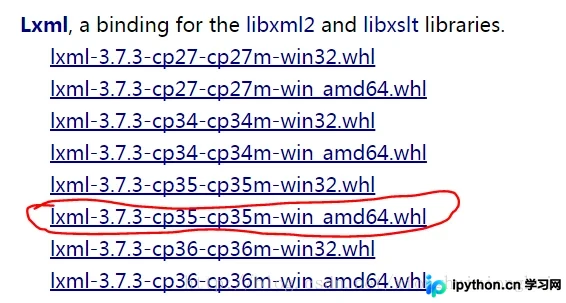
本文介绍在Windows 7系统中使用Python 3.5安装Scrapy时,如何解决“Unable to find vcvarsall.bat”编译错误。通过推荐下载lxml和Twisted的wheel文件并手动安装,避免安装Visual Studio 2015,从而简化部署流程。
本文详细解析使用Python进行网页爬虫的完整流程,涵盖BeautifulSoup库的核心用法、requests库发送带Header的请求、页面元素定位与数据提取,以及本地文件夹创建与图片文件保存的具体实现。通过一个完整的妹子图抓取案例,展示从建立连接到处理多页图片的实际操作,帮助开发者快速掌握基础爬虫技术。
本文介绍在Python中验证代理IP可用性的几种方法。通过urllib2构建代理 opener、使用requests库简化代码,以及利用telnetlib进行端口连通性测试。重点解析如何判断代理是否有效,并将可用IP存入Redis以便后续爬虫调用,帮助解决IP被封问题。
本文介绍如何利用Python分析Ajax请求来抓取今日头条的街拍图集。通过解析返回的JSON数据获取图片列表,并结合多线程与MongoDB存储实现自动化抓取。文章提供了完整的代码示例及关键参数配置说明,帮助开发者掌握动态网页数据抓取技巧。