

Mac系统安装Scrapy报错Operation not permitted的解决方案
本文解决在Mac系统(如OSX 10.11及更高版本)中安装Python爬虫框架Scrapy时遇到的“Operation not permitted”错误。该问题通常由旧版Python(如2.7)与新系统权限机制冲突导致,通过升级Python版本即可有效解决。
2026-10-13
9

本文解决在Mac系统(如OSX 10.11及更高版本)中安装Python爬虫框架Scrapy时遇到的“Operation not permitted”错误。该问题通常由旧版Python(如2.7)与新系统权限机制冲突导致,通过升级Python版本即可有效解决。
本文详细讲解Python爬虫的核心流程,涵盖数据下载、解析与保存三大环节。通过对比urllib、Requests及Selenium等工具,结合淘宝图片抓取实例,演示如何利用正则表达式提取数据,并处理反爬策略与动态网页加载问题,为初学者提供实用的技术参考。
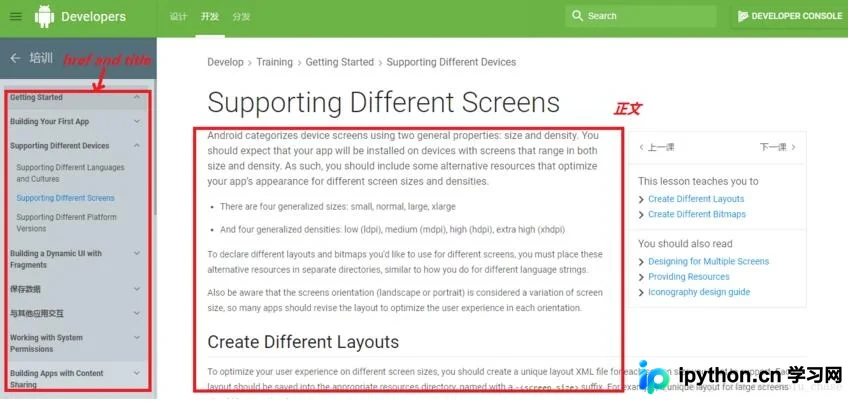
本文介绍如何利用Python编写爬虫程序,从指定网页提取标题、正文及导航链接,并通过BeautifulSoup解析HTML。结合Requests库获取内容,使用wkhtmltopdf工具将生成的HTML文件转换为PDF格式,实现离线阅读与记忆。
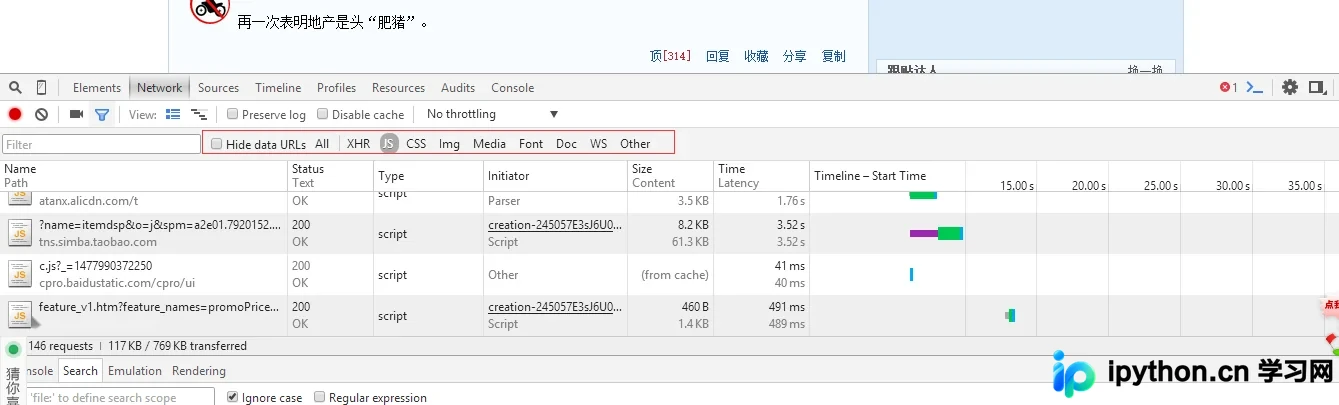
本文介绍使用Python爬取网易新闻评论的方法。针对动态加载的评论数据,通过开发者工具定位API接口,获取JSON格式数据。利用正则表达式剥离回调函数包裹,将JSON转换为Python字典后提取评论信息,并分别抓取热门与最新评论写入文件。
本文介绍如何使用Python的urllib2模块实现简单的网页内容抓取。通过普通抓取和带参数的GET请求两个实例,演示如何构建Request对象、发送请求、处理状态码及读取网页内容,适用于Python初学者学习网络请求基础。
本文详细讲解利用Python进行图像类验证码识别的完整流程。从生成测试验证码入手,依次演示灰度处理、二值化及基于邻域算法的降噪技术,并结合TesserOCR库实现自动识别。文章通过对比不同干扰程度下的识别效果,提供了处理简单至中等复杂度验证码的实用代码与策略。
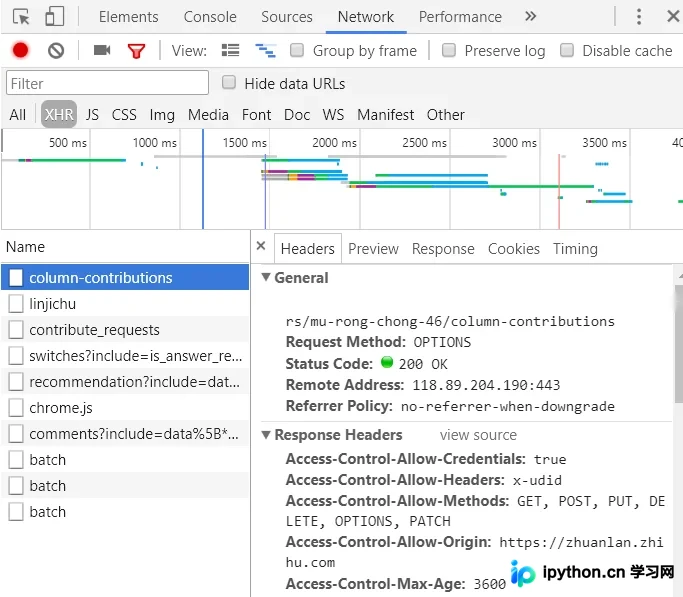
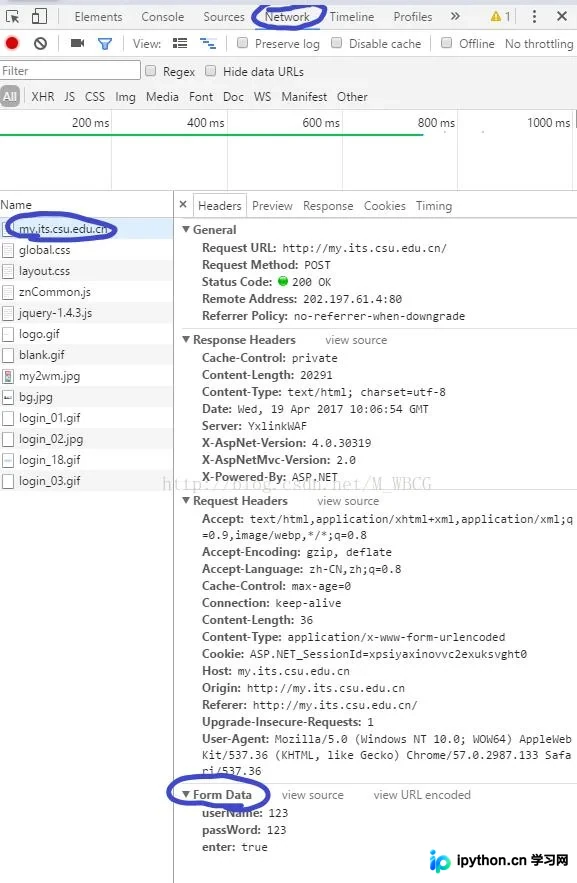
本文详解利用Python进行网站模拟登录的完整流程。通过开发者工具分析Network请求,提取登录所需的隐藏参数,并使用requests库建立Session以维持状态。文章展示了如何获取HTML源码、正则提取数据、提交POST请求以及获取登录后页面内容,提供基础代码参考。
本文介绍使用Python编写爬虫程序,自动抓取煎蛋网(jandan.net)上的图片并保存至本地文件夹。通过解析网页HTML获取图片链接,利用urllib库发起请求并下载图片文件,支持指定页数批量处理。代码包含页面解析、图片地址提取及文件保存逻辑,适合Python初学者学习网络爬虫基础操作。
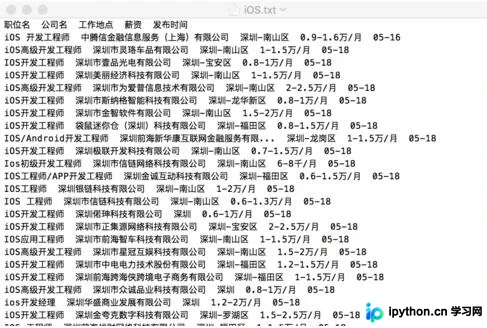
本文分享一个基于Python 2.7编写的简单网络爬虫Demo,旨在帮助初学者理解网页数据抓取流程。代码通过BeautifulSoup解析51job网站,提取职位名、公司、薪资及发布时间等关键信息,并演示了如何将数据写入MySQL数据库。文中包含完整代码及抓取结果展示,适合入门学习参考。
本文提供了一段 Python 爬虫代码,用于从多个代理网站批量获取代理 IP。通过定义不同的代理类型和线路,利用正则表达式提取 IP、端口及地区信息,并模拟浏览器请求以规避基础反爬。代码包含完整的类封装与测试逻辑,适合需要大量代理资源进行网络数据采集的场景参考使用。
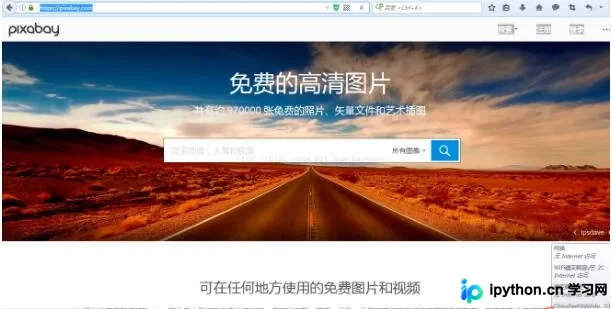
本文详细介绍如何使用Python3编写爬虫程序,从Pixabay网站批量下载图片。通过解析网页源码,利用正则表达式匹配包含cdn.pixabay.com/photo/的.jpg链接,并结合requests与BeautifulSoup库实现自动化下载。代码包含超时处理、文件夹自动创建及异常捕获机制,适合Python初学者参考学习。
本文介绍利用Python标准库urllib2和re模块编写简单爬虫,通过正则表达式匹配网页源码中的图片链接,并使用urlretrieve函数将JPG图片批量下载至本地指定目录的完整代码示例与步骤说明。