

InfluxDB与Grafana集成:Python采集网络数据实战及常见陷阱解析

发布时间:2026-10-13| 2人浏览过
本文详解使用Python脚本将网卡数据写入InfluxDB并通过Grafana可视化的完整流程。重点解析数据采集脚本中字段类型必须为int或float以避免no datapoint错误的核心陷阱,以及10秒采集间隔的常规设置。文章提供基于telegraf数据库的InfluxDBClient配置代码及Grafana SQL图形配置示例,帮助开发者快速搭建稳定的网络监控体系。
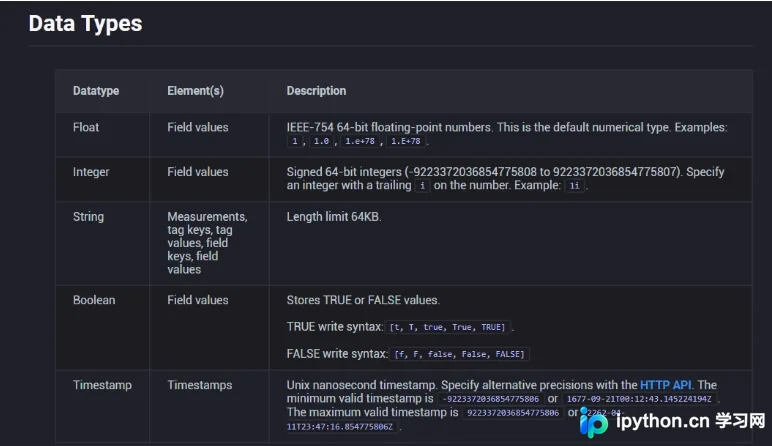
首先介绍用于采集网卡数据的Python脚本,这是整个流程中最大的坑点所在。如果数据类型处理不当,极易引发no datapoint错误,令人头疼。需要特别注意,写入InfluxDB时,fields中的某些key值必须严格指定为int或float类型;若误写为string类型,将导致数据无法入库。相比之下,tags中的值保持为string类型即可。
此外,数据采集的时间间隔通常设定为10秒,这已是业界通用的潜规则,大家对此心照不宣。
以下是实际运行效果的图示验证。
#! /usr/bin/env python
#-*- coding:utf-8 -*-

import os
import arrow
import time
from time import sleep
from influxdb import InfluxDBClient

client = InfluxDBClient('localhost', 8086, 'root', '', 'telegraf')

while True:
  if int(time.time())%10 == 0:
    cmd = 'cat /proc/net/dev|grep "ens4"'
    rawline = os.popen(cmd).read().strip()
    rxbytes = int(rawline.split()[1])
    txbytes = int(rawline.split()[9])
    rxpks = int(rawline.split()[2])
    txpks = int(rawline.split()[10])
    now = str(arrow.now()).split('.')[0] + 'Z'

    print time.time(), rxbytes,txbytes,rxpks,txpks

    json_body = [
      {
        "measurement": "network",
        "tags": {
          "host": "gc-u16",
          "nio": "ens4"
        },
        #"time": now,
        "fields": {
          "rxbytes": rxbytes,
          "txbytes": txbytes,
          "rxpks": rxpks,
          "txpks": txpks
        }
      }
    ]

    client.write_points(json_body)
  sleep(1)
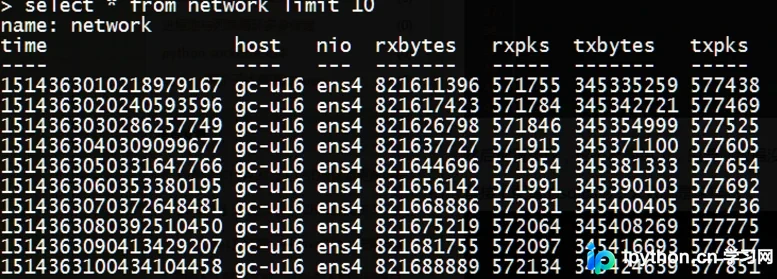
执行上述脚本后,即可在InfluxDB中查看到写入的数据。至于是否采用后台进程或独立线程等方式运行脚本,可根据具体场景灵活选择,此处不作统一规定。
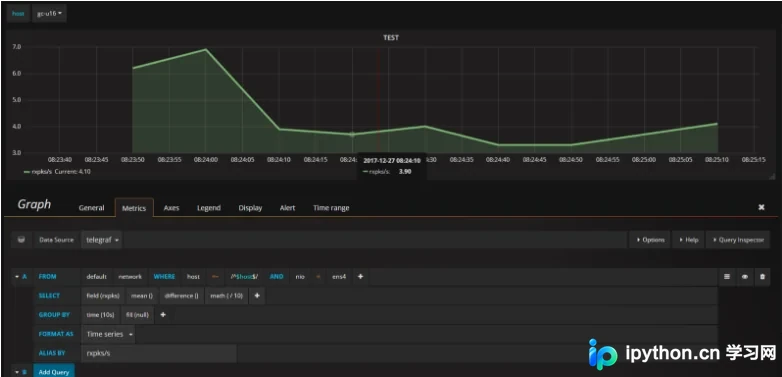
接下来进行Grafana图形配置,这一步相对简单。只要数据写入无误,Grafana通常都能正常采集。此处省略创建数据源、Dashboard及表格等基础设置步骤,直接展示用于生成图形的SQL配置逻辑,大致配置如下。
总结 以上即为本文的全部内容,希望这些经验对大家的开发或运维工作有所参考。感谢支持。如需了解更多相关信息,请参阅相关链接。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









