

Python爬虫实战:采集猫眼电影《无名之辈》两万条影评并可视化分析
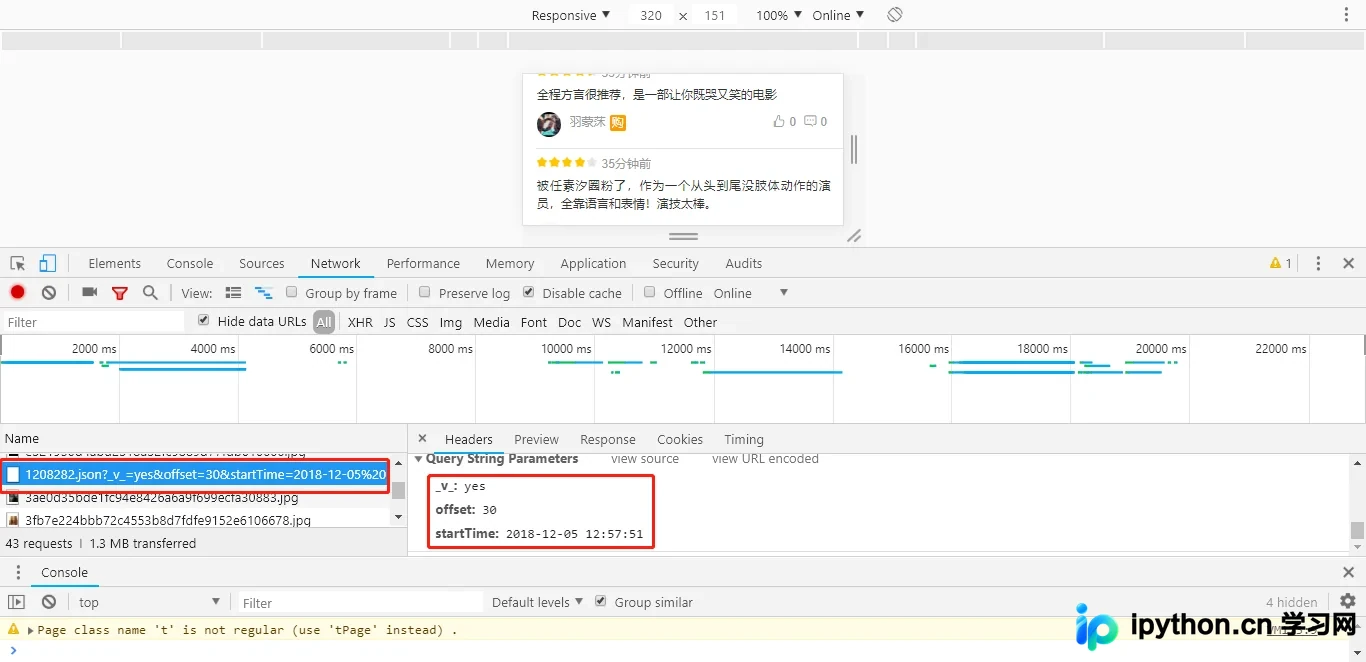
本文详细介绍使用Python采集猫眼电影《无名之辈》近两万条用户评论的全过程。通过移动端接口获取数据,利用jieba进行分词,结合pyecharts和matplotlib制作观众城市分布热点图、TOP20来源柱状图及评论词云。文中还包含对pyecharts源码的修改以解决城市简称匹配问题,提供完整代码供学习参考。
2026-10-13
6

本文详细介绍使用Python采集猫眼电影《无名之辈》近两万条用户评论的全过程。通过移动端接口获取数据,利用jieba进行分词,结合pyecharts和matplotlib制作观众城市分布热点图、TOP20来源柱状图及评论词云。文中还包含对pyecharts源码的修改以解决城市简称匹配问题,提供完整代码供学习参考。
本文介绍如何利用Python构建微信自动提醒系统。通过Selenium模拟登录石墨文档获取待办事项,结合APScheduler设置每日定时任务,并利用Server酱API将筛选后的当日任务推送到微信。方案包含登录模拟、数据解析、消息推送及运行监测完整流程,适用于个人效率管理。
本文详细介绍如何使用Python3结合Requests和BeautifulSoup模块爬取赶集网列表数据。文章涵盖环境配置、模块安装及核心代码实现,通过构造请求头模拟浏览器访问,解析HTML并提取标题信息,帮助开发者快速掌握基础爬虫技巧。
本文介绍在Python中为数字字符串左侧补零的两种实用方法。第一种通过设定足够大的基数进行加法运算后截取指定子串;第二种通过计算当前字符串长度与预期长度的差值,动态生成前导零。这两种方法均可有效解决URL中日期格式需补零的问题,适用于新闻爬虫等场景。
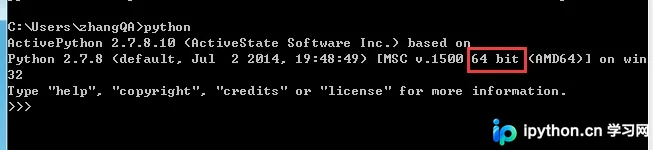
本文详细介绍在Windows 7系统下搭建Python Scrapy爬虫环境的具体步骤。重点讲解64位环境下需预先安装pywin32、pyOpenSSL、lxml及VCForPython27等依赖组件,以避免pip安装scrapy时出错。同时涵盖32位系统的配置差异及安装验证方法,确保环境正确运行。
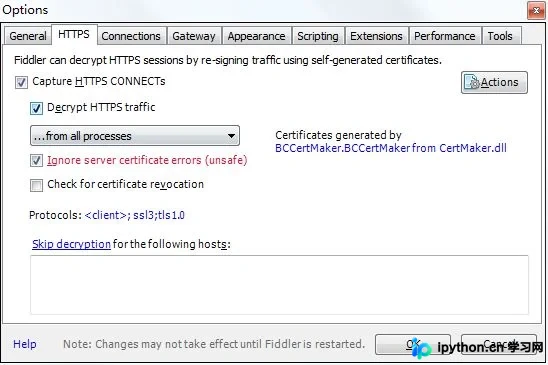
本文详细讲解如何使用Python3配合Fiddler工具抓取手机APP接口数据。内容涵盖Fiddler安装配置、手机代理设置、证书信任及抓包测试,并以王者荣耀盒子APP为例,演示如何解析英雄与装备接口数据,最终提供完整的Python爬取代码供参考。
本文介绍如何利用Python编写脚本爬取淘宝商品销量信息。通过指定关键词和分页参数,程序可自动获取商品列表并计算总销量。支持在代码中通过特定标记约束作者、时期等属性,适用于电商数据分析场景。
本文提供一段Python代码,演示如何抓取网易云音乐歌曲的热评。通过构造请求头与参数,利用requests库获取数据,并解析JSON提取用户昵称及评论内容,最终保存至本地文本文件。
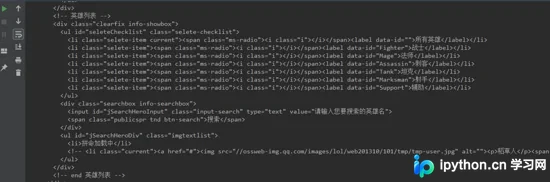
本文详细解析了使用Python3抓取英雄联盟英雄皮肤大图的技术路径。通过分析网页源码中的JavaScript文件,定位英雄列表及皮肤URL拼接规则,利用requests和json模块实现自动化下载。文章提供了完整的Python3.6运行环境配置、依赖模块说明及GitHub源码链接,帮助开发者掌握前端数据提取与后端爬虫结合的实现方法。
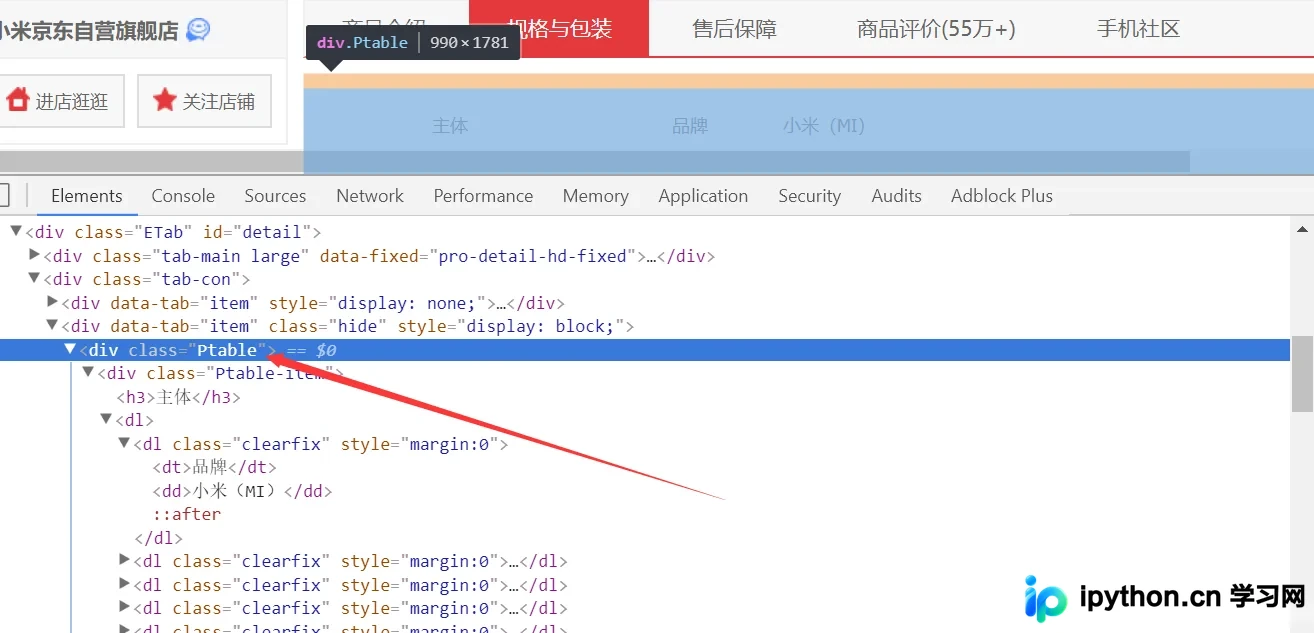
本文演示如何使用Python的requests库获取京东商品页面源码,并结合BeautifulSoup解析HTML结构。通过定位特定class的div容器,提取dl、dt和dd标签中的键值对数据,最终使用pandas构建DataFrame存储商品参数信息。
本文介绍如何利用Python的requests、lxml及xlsxwriter库,通过构造高德地图API接口批量抓取水果店等POI数据。教程涵盖环境配置、请求参数构造、分页循环逻辑及Excel表格写入实现,帮助开发者快速掌握地图数据抓取与本地存储技巧。
本文分析Python多线程爬虫中因多个线程同时读写全局变量导致的文件名覆盖问题。通过引入锁机制保护全局变量操作,确保每个线程获取唯一的文件编号,从而解决文件被重复覆盖的bug,保障多线程环境下的数据完整性。