

Python使用广度优先搜索爬取网站内外链完整代码示例

本文详细介绍如何使用Python结合广度优先搜索(BFS)算法,编写代码以获取指定网站的所有内链与外链。文章涵盖队列类的定义、urllib库解析URL的方法、请求头设置以及完整的爬虫实现逻辑,并提供百度图片站点的爬取结果示例,适合Python初学者参考学习。
项目介绍
本方案采用广度优先搜索(BFS)策略,旨在遍历并收集一个网站内的所有外部链接。具体流程为:首先访问起始网页,提取该页面包含的所有内部链接和外部链接;随后,依次进入每一个内部链接页面,重复执行提取内链和外链的操作,直至所有可达的内部链接页面均被访问完毕。
代码大纲
1、定义一个队列类,遵循先进先出(FIFO)原则,支持队尾入队和队头出队操作; 2、构建四个核心函数:分别用于爬取网页外链、爬取网页内链、递归进入内链处理以及主程序调用; 3、以百度图片(https://image.baidu.com/)为目标站点,初始化两个队列和两个数组,分别用于存储待处理的内链和外链。程序启动时,先抓取当前页面的内链和外链,将其加入队列,并检查数组中是否已存在该链接,若不存在则添加至数组; 4、调用deepLinks()函数进入循环处理。当内链队列非空时,从队列中取出一个内链,进入该页面并再次调用爬取内链和外链的函数。通过判断链接是否重复,将新的内链和外链分别加入对应队列,持续迭代直至队列为空; 5、遍历网页中所有的内部链接,从中提取所有外部链接并存储于队列中,最终输出结果。
网站详情
代码详情
队列
队列是一种特殊的线性表,单向队列仅允许在一端插入数据(队尾),在另一端删除数据(队头); 与栈类似,队列也是一种操作受限的线性数据结构; 执行插入操作的端点称为队尾,执行删除操作的端点称为队头; 队列中存储的数据项被称为元素,不含任何元素的队列称为空队列。
由于队列仅允许一端插入或删除,因此必须遵循最先进入队列的元素最先被删除的原则,故被称为先进先出(FIFO—first in first out)线性表。 在此示例中,我们使用class类定义一个队列,实现先进先出、队尾入队、队头出队的功能。该队列类需具备以下方法:出队、入队、判断队列是否为空、获取队列长度以及返回队头元素。
class Queue(object):
    #初始化队列
    def __init__(self):
        self.items = []

    #入队
    def enqueue(self, item):
        self.items.append(item)

    #出队
    def dequeue(self):
        if self.is_Empty():
            print("当前队列为空!!")
        else:
            return self.items.pop(0)

    #判断是否为空
    def is_Empty(self):
        return self.items == []

    #队列长度
    def size(self):
        return len(self.items)

    #返回队头元素,如果队列为空的话,返回None
    def front(self):
        if self.is_Empty():
            print("当前队列为空!!")
        else:
            return self.items[len(self.items) - 1]
内链外链
内链与外链的区别如下: 内链:指同一网站域名下不同内容页面之间的相互链接。 外链:指从其他网站导入到自己网站的链接,例如友情链接、外链建设等。 通俗而言,内链即域名相同的链接,而外链的域名则与当前网站不同。
讨论内链与外链时,必然涉及urllib库的使用。首先需导入该库。
from urllib.parse import urlparse使用urlparse模块解析URL链接,urlparse()函数将URL拆分为以下6个部分:
scheme (协议)

netloc (域名)

path (路径)

params (可选参数)

query (连接键值对)

fragment (特殊锚)
url='https://image.baidu.com/'
a, b = urlparse(url).scheme, urlparse(url).netloc
print(a)
print(b)

#-----------------输出结果---------------------#
https
image.baidu.com
请求头
Header来源:使用浏览器打开目标网页,按F12键打开开发者工具,点击Network标签,按Ctrl+R刷新页面,点击Name列选择网站域名,在右侧面板中找到Headers部分,定位至Request Headers,复制其中的User-Agent字段内容。
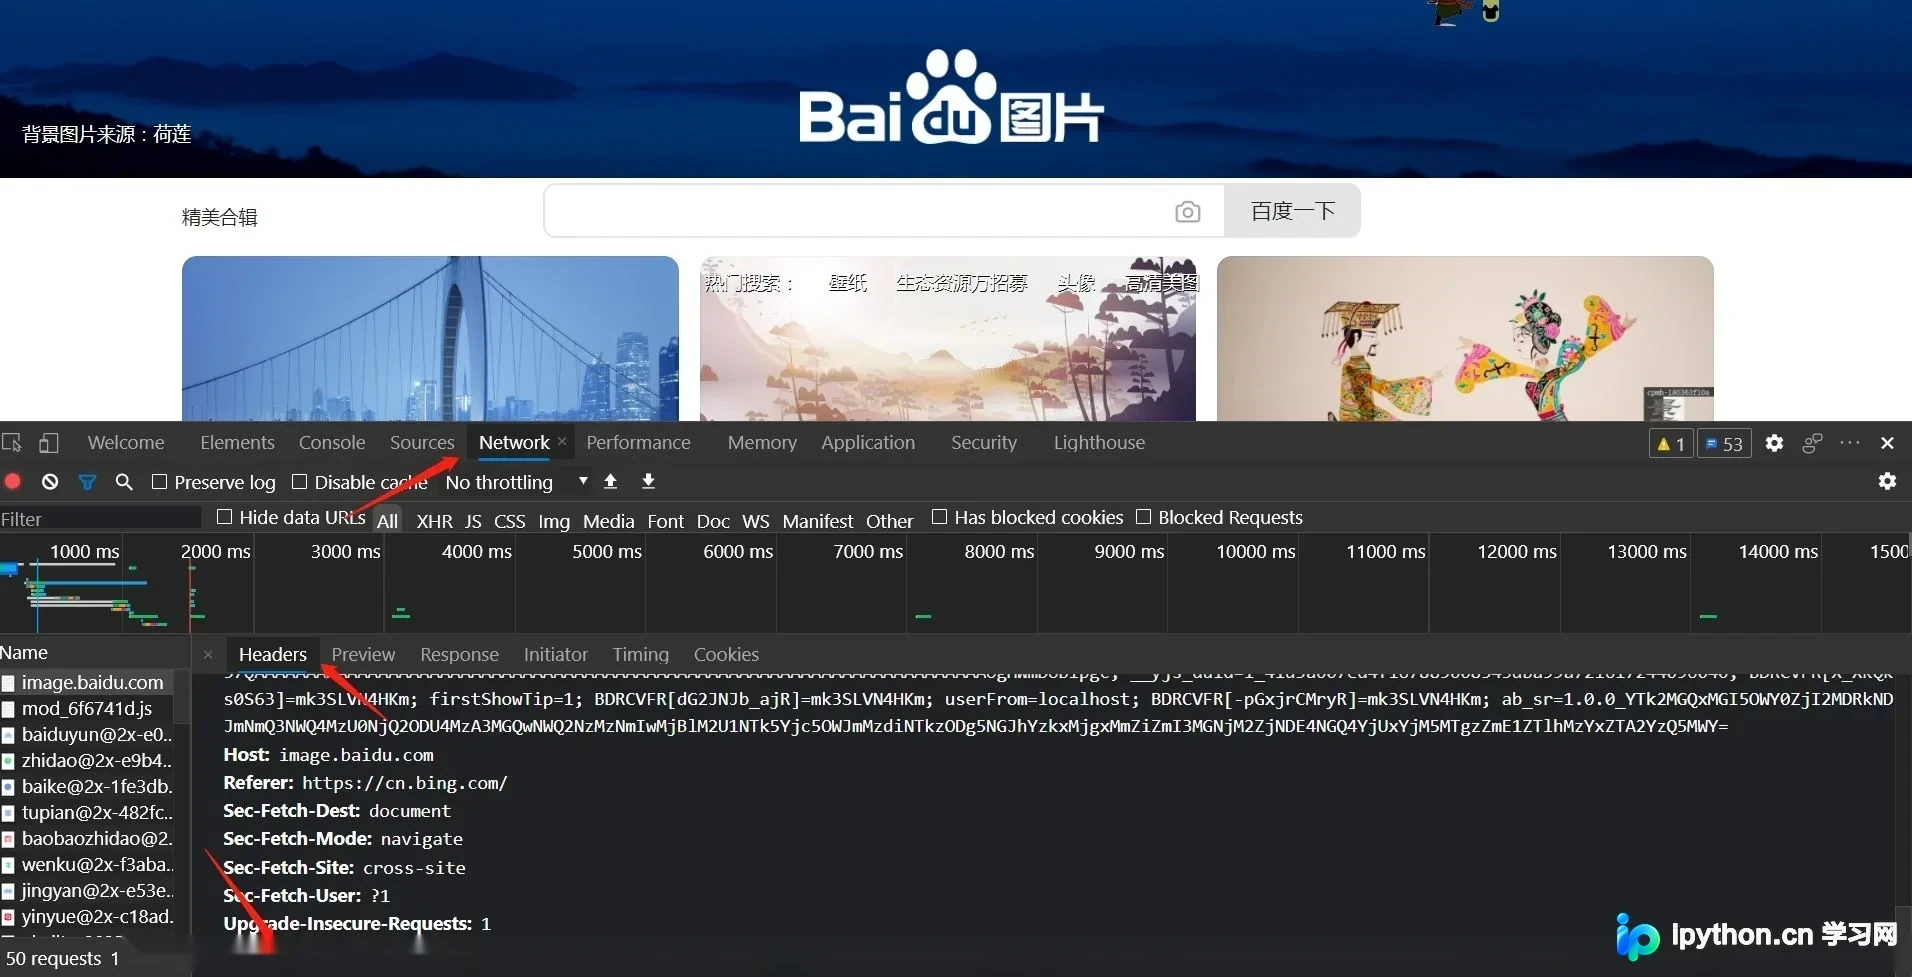
示例中的请求头配置如下:
headers_={'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.114 Safari/537.36 Edg/89.0.774.68'}
html = requests.get(url,headers=headers_)
完整代码
class Queue(object):
    #初始化队列
    def __init__(self):
        self.items = []

    #入队
    def enqueue(self, item):
        self.items.append(item)

    #出队
    def dequeue(self):
        if self.is_Empty():
            print("当前队列为空!!")
        else:
            return self.items.pop(0)

    #判断是否为空
    def is_Empty(self):
        return self.items == []

    #队列长度
    def size(self):
        return len(self.items)

    #返回队头元素,如果队列为空的话,返回None
    def front(self):
        if self.is_Empty():
            print("当前队列为空!!")
        else:
            return self.items[len(self.items) - 1]


#导入库
from urllib.request import urlopen
from urllib.parse import urlparse
from bs4 import BeautifulSoup
import requests
import re
import urllib.parse
import time
import random


queueInt = Queue()   #存储内链的队列
queueExt = Queue()   #存储外链的队列

externalLinks = []
internalLinks = []

#获取页面中所有外链的列表
def getExterLinks(bs, exterurl):

    #找出所有以www或http开头且不包含当前URL的链接
    for link in bs.find_all('a', href = re.compile
                            ('^(http|www)((?!'+urlparse(exterurl).netloc+').)*$')):
        #按照标准,URL只允许一部分ASCII字符,其他字符(如汉字)是不符合标准的,
        #我们的链接网址可能存在汉字的情况,此时就要进行编码。
        link.attrs['href'] = urllib.parse.quote(link.attrs['href'],safe='?=&:/')
        if link.attrs['href'] is not None:
            if link.attrs['href'] not in externalLinks:
                queueExt.enqueue(link.attrs['href'])
                externalLinks.append(link.attrs['href'])
                print(link.attrs['href'])
#     return externalLinks

#获取页面中所以内链的列表
def getInterLinks(bs, interurl):
    interurl = '{}://{}'.format(urlparse(interurl).scheme,
                                urlparse(interurl).netloc)

    #找出所有以“/”开头的内部链接
    for link in bs.find_all('a', href = re.compile
                            ('^(/|.*'+urlparse(interurl).netloc+')')):
        link.attrs['href'] = urllib.parse.quote(link.attrs['href'],safe='?=&:/')
        if link.attrs['href'] is not None:
            if link.attrs['href'] not in internalLinks:
        #startsWith()方法用来判断当前字符串是否是以另外一个给定的子字符串“开头”的
                if(link.attrs['href'].startswith('//')):
                    if interurl+link.attrs['href'] not in internalLinks:
                        queueInt.enqueue(interurl+link.attrs['href'])
                        internalLinks.append(interurl+link.attrs['href'])
                elif(link.attrs['href'].startswith('/')):
                    if interurl+link.attrs['href'] not in internalLinks:
                        queueInt.enqueue(interurl+link.attrs['href'])
                        internalLinks.append(interurl+link.attrs['href'])
                else:
                    queueInt.enqueue(link.attrs['href'])
                    internalLinks.append(link.attrs['href'])
#     return internalLinks

def deepLinks():
    num = queueInt.size()
    while num > 1:
        i = queueInt.dequeue()
        if i is None:
            break
        else:
            print('访问的内链')
            print(i)
            print('找到的新外链')
    #         html = urlopen(i)
            html=requests.get(i,headers=headers_)
            time.sleep(random.random()*3)
            domain1 = '{}://{}'.format(urlparse(i).scheme, urlparse(i).netloc)
            bs = BeautifulSoup(html.content, 'html.parser')
            getExterLinks(bs, domain1)
            getInterLinks(bs, domain1)


def getAllLinks(url):
    global num
#     html = urlopen(url)
    headers_={'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/89.0.4389.114 Safari/537.36 Edg/89.0.774.68'}
    html = requests.get(url,headers=headers_)
    time.sleep(random.random()*3) #模拟人类行为,间隔随机的时间
    domain = '{}://{}'.format(urlparse(url).scheme, urlparse(url).netloc)
    bs = BeautifulSoup(html.content, 'html.parser')

    getInterLinks(bs, domain)
    getExterLinks(bs, domain)
    deepLinks()

getAllLinks('https://image.baidu.com/')
爬取结果
此处仅截取部分结果展示:
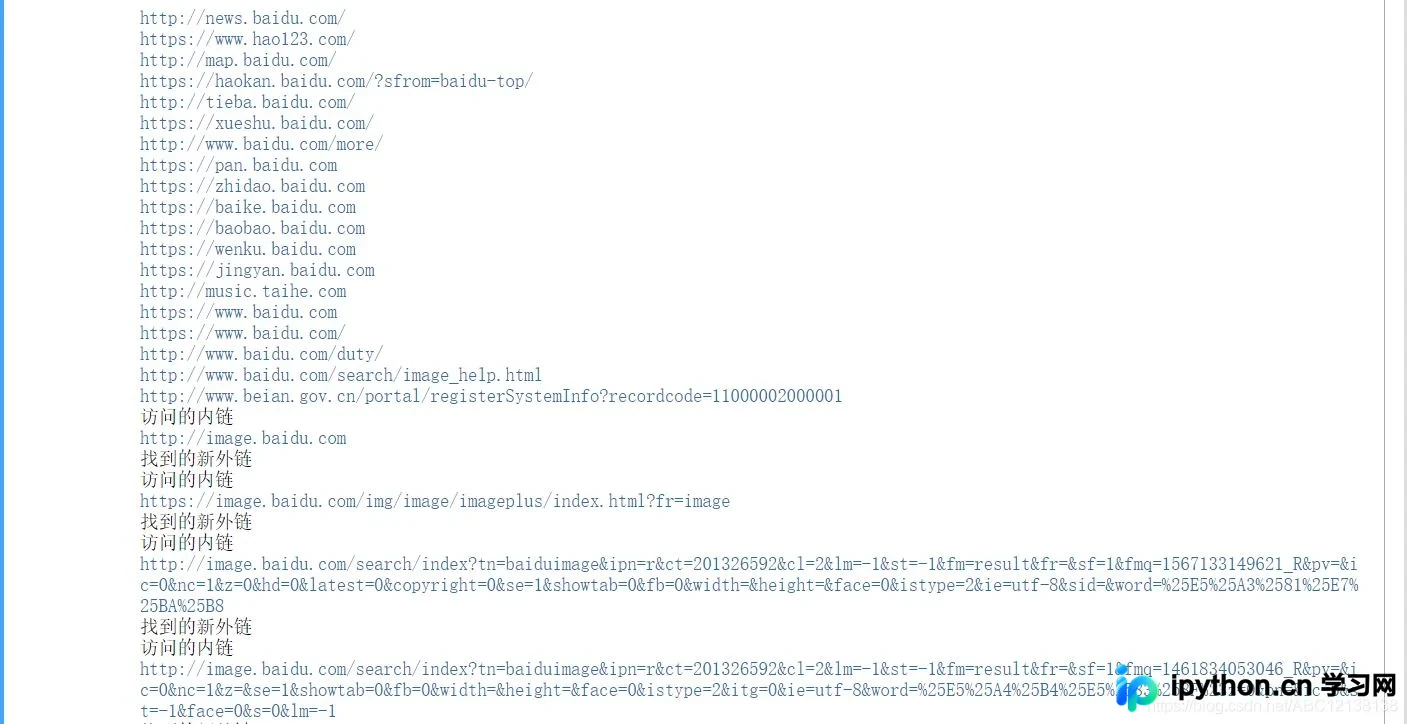
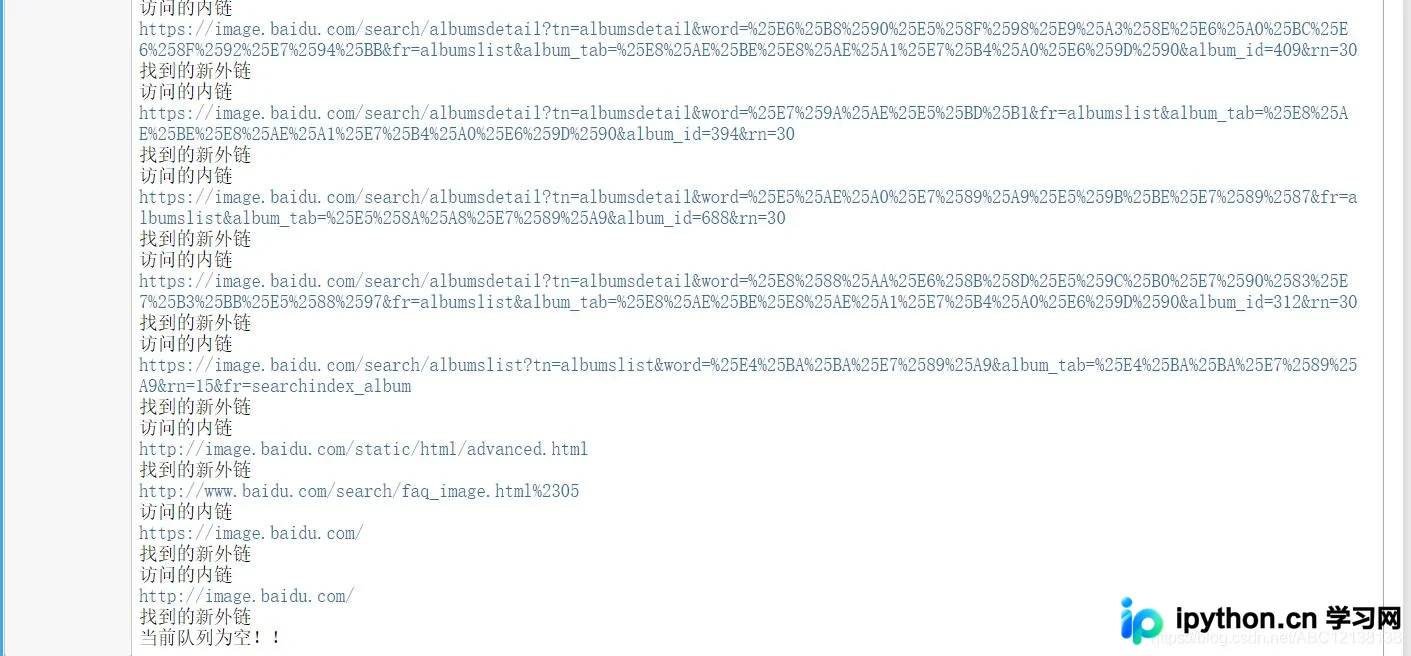
数组中存储的所有内链列表
internalLinks
-------------输出内容------------------
['http://image.baidu.com',
'https://image.baidu.com/img/image/imageplus/index.html?fr=image',
'http://image.baidu.com/search/index?tn=baiduimage&ipn=r&ct=201326592&cl=2&lm=-1&st=-1&fm=result&fr=&sf=1&fmq=1567133149621_R&pv=&ic=0&nc=1&z=0&hd=0&latest=0©right=0&se=1&showtab=0&fb=0&width=&height=&face=0&istype=2&ie=utf-8&sid=&word=%25E5%25A3%2581%25E7%25BA%25B8',
'http://image.baidu.com/search/index?tn=baiduimage&ipn=r&ct=201326592&cl=2&lm=-1&st=-1&fm=result&fr=&sf=1&fmq=1461834053046_R&pv=&ic=0&nc=1&z=&se=1&showtab=0&fb=0&width=&height=&face=0&istype=2&itg=0&ie=utf-8&word=%25E5%25A4%25B4%25E5%2583%258F%23z=0&pn=&ic=0&st=-1&face=0&s=0&lm=-1',
'https://image.baidu.com/search/albumslist?tn=albumslist&word=%25E8%25AE%25BE%25E8%25AE%25A1%25E7%25B4%25A0%25E6%259D%2590&album_tab=%25E8%25AE%25BE%25E8%25AE%25A1%25E7%25B4%25A0%25E6%259D%2590&rn=15&fr=searchindex',
'https://image.baidu.com/search/albumsdetail?tn=albumsdetail&word=%25E5%259F%258E%25E5%25B8%2582%25E5%25BB%25BA%25E7%25AD%2591%25E6%2591%2584%25E5%25BD%25B1%25E4%25B8%2593%25E9%25A2%2598&fr=searchindex_album%2520&album_tab=%25E5%25BB%25BA%25E7%25AD%2591&album_id=7&rn=30',
'https://image.baidu.com/search/albumsdetail?tn=albumsdetail&word=%25E6%25B8%2590%25E5%258F%2598%25E9%25A3%258E%25E6%25A0%25BC%25E6%258F%2592%25E7%2594%25BB&fr=albumslist&album_tab=%25E8%25AE%25BE%25E8%25AE%25A1%25E7%25B4%25A0%25E6%259D%2590&album_id=409&rn=30',
'https://image.baidu.com/search/albumsdetail?tn=albumsdetail&word=%25E7%259A%25AE%25E5%25BD%25B1&fr=albumslist&album_tab=%25E8%25AE%25BE%25E8%25AE%25A1%25E7%25B4%25A0%25E6%259D%2590&album_id=394&rn=30',
'https://image.baidu.com/search/albumsdetail?tn=albumsdetail&word=%25E5%25AE%25A0%25E7%2589%25A9%25E5%259B%25BE%25E7%2589%2587&fr=albumslist&album_tab=%25E5%258A%25A8%25E7%2589%25A9&album_id=688&rn=30',
'https://image.baidu.com/search/albumsdetail?tn=albumsdetail&word=%25E8%2588%25AA%25E6%258B%258D%25E5%259C%25B0%25E7%2590%2583%25E7%25B3%25BB%25E5%2588%2597&fr=albumslist&album_tab=%25E8%25AE%25BE%25E8%25AE%25A1%25E7%25B4%25A0%25E6%259D%2590&album_id=312&rn=30',
'https://image.baidu.com/search/albumslist?tn=albumslist&word=%25E4%25BA%25BA%25E7%2589%25A9&album_tab=%25E4%25BA%25BA%25E7%2589%25A9&rn=15&fr=searchindex_album',
'http://image.baidu.com/static/html/advanced.html',
'https://image.baidu.com/',
'http://image.baidu.com/']数组中存储的所有外链列表
externalLinks

-------------输出内容------------------

['http://news.baidu.com/',
 'https://www.hao123.com/',
 'http://map.baidu.com/',
 'https://haokan.baidu.com/?sfrom=baidu-top/',
 'http://tieba.baidu.com/',
 'https://xueshu.baidu.com/',
 'http://www.baidu.com/more/',
 'https://pan.baidu.com',
 'https://zhidao.baidu.com',
 'https://baike.baidu.com',
 'https://baobao.baidu.com',
 'https://wenku.baidu.com',
 'https://jingyan.baidu.com',
 'http://music.taihe.com',
 'https://www.baidu.com',
 'https://www.baidu.com/',
 'http://www.baidu.com/duty/',
 'http://www.baidu.com/search/image_help.html',
 'http://www.beian.gov.cn/portal/registerSystemInfo?recordcode=11000002000001',
 'http://help.baidu.com/question',
 'http://www.baidu.com/search/jubao.html',
 'http://www.baidu.com/search/faq_image.html%2305']
至此,关于Python爬取网页所有内外链的文章介绍完毕。如需了解更多Python爬取网页内外链的相关内容,请查阅本站历史文章或继续浏览后续文章。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









