Python实现B站实时弹幕抓取与词云可视化教程
本文详细介绍如何利用Python爬虫技术自动化获取B站视频实时弹幕数据。通过结合jieba分词库进行文本清洗与停用词过滤,最终使用wordcloud库生成可视化词云。教程涵盖从环境配置、数据抓取到文本处理的全流程,帮助开发者快速掌握弹幕数据分析的核心方法。
2026-10-14
6

本文详细介绍如何利用Python爬虫技术自动化获取B站视频实时弹幕数据。通过结合jieba分词库进行文本清洗与停用词过滤,最终使用wordcloud库生成可视化词云。教程涵盖从环境配置、数据抓取到文本处理的全流程,帮助开发者快速掌握弹幕数据分析的核心方法。
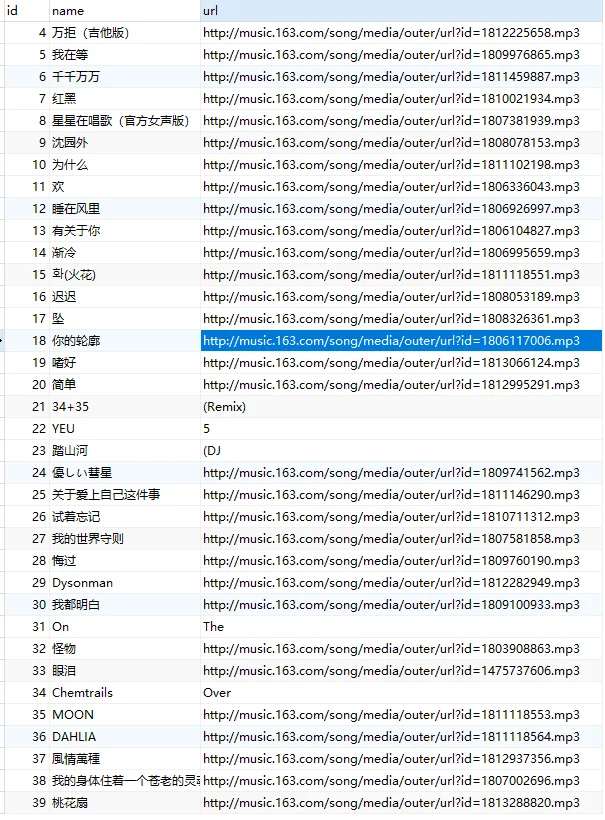
本文介绍如何利用Python爬虫技术抓取网易云音乐榜单数据,并通过Django框架封装为RESTful API接口。通过解析HTML获取歌曲名称与URL,存入MySQL数据库,最终提供简单的数据查询接口,适用于微信小程序等场景的测试需求。
本文详细解析如何利用Python结合mitmproxy进行流量抓包,以及使用Appium模拟Android手机操作来抓取抖音视频。通过启动Appium服务、创建Session驱动抖音App,并配合Python脚本处理请求,实现视频文件的自动下载与保存。
本文介绍在Python爬虫开发中,如何获取HTTP重定向后的最终URL。通过urllib库的urlopen方法和requests库的get方法,分别展示了两种获取重定向地址的代码实现。重点解析了如何从响应对象中提取最终跳转后的网址,并提供了包含User-Agent请求头设置的示例,帮助开发者解决爬虫追踪真实链接的问题。
本文介绍如何使用Python和Selenium实现携带Cookies模拟登录微博。首先通过手机扫码获取斗鱼Cookies并保存,随后加载该Cookies文件登录微博,实现高效模拟登录。
本文介绍使用Python进行图片爬取的简单实现方法。通过导入正则表达式模块和requests库,定义spider函数解析网页HTML并提取图片URL。代码包含异常处理、超时设置及文件保存逻辑,展示了从请求到本地存储的完整流程,适合初学者参考。
本文详解在Python中使用Scrapy框架实现定时爬虫的多种方案。通过Timer类、os.system调用及sched模块,可灵活设定抓取周期。文章提供了具体代码示例,涵盖单次执行与周期性任务,帮助开发者根据需求配置定时策略,适用于数据挖掘、监测及自动化测试场景。
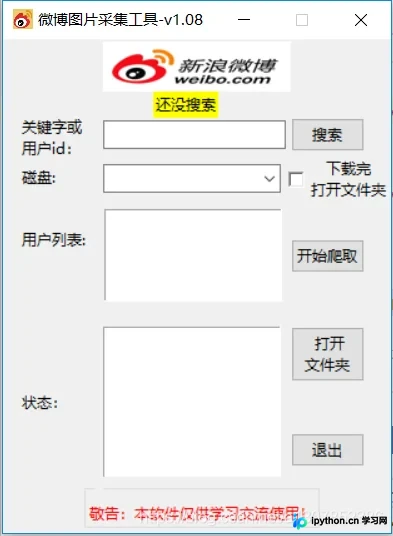
本文分享一款基于Python Tkinter开发的微博图片批量下载工具。文章详细解析了从环境依赖、界面设计到核心逻辑的实现过程,重点介绍了使用多线程解决UI卡顿问题及后台线程管理技巧。包含完整源代码、流程图解析及四大功能亮点,提供网盘下载链接,适合Python初学者学习GUI编程与网络爬虫实战。
本文详解Scrapy框架实现翻页爬取的核心机制。通过Spider的parse方法生成新Request并控制dont_filter参数,结合Pipeline中的set对象实现Item去重,配合settings.py配置开启管道,即可高效完成多页数据抓取与清洗。
本文详细介绍如何使用 Python 的 requests 模块实现网页图片的批量爬取与本地保存。通过解析网页 HTML 结构提取图片 URL,结合二进制流写入方式,将网络图片数据保存为 JPG 或 PNG 格式文件。文章包含从单图下载到批量处理的完整代码示例,涵盖 URL 拼接、文件命名及异常处理等关键步骤,适合初学者学习网络数据采集基础。
本文介绍使用Python爬取免费代理IP网站数据并生成JSON文件的方法。通过lxml模块提取IP和端口,利用requests库向百度发起请求以验证代理可用性,并将有效IP及耗时写入文件。代码包含分页抓取、延时处理及异常捕获,旨在为小型爬虫项目提供低成本的动态IP解决方案。
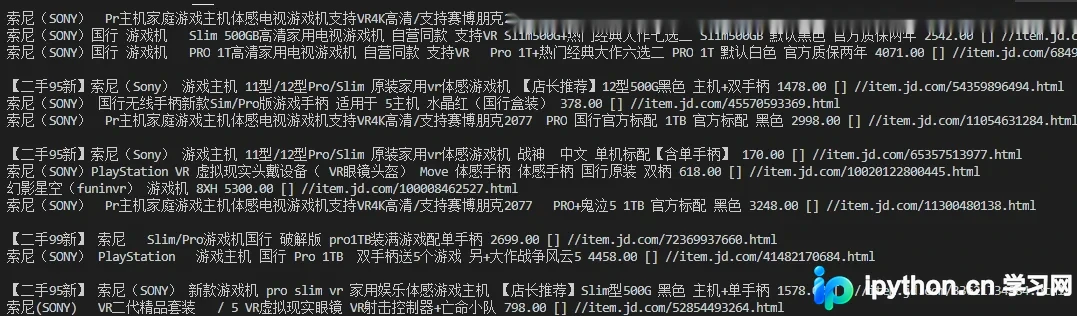
本文介绍使用 Python 编写爬虫程序,通过 requests 发送请求并配合 lxml 解析 HTML 结构,从京东搜索页面提取 PS4 商品名称、价格、评论数及链接等关键信息。代码包含完整的请求头设置与数据清洗逻辑,适用于电商数据抓取学习。