利用Python爬虫离线构建Excel VBA本地帮助文档
针对办公环境网络隔离导致VBA开发不便的问题,本文介绍如何利用Python结合Selenium与Requests库,从微软官方文档网站抓取VBA API数据。通过遍历导航树获取链接,下载主体页面内容,并基于jstree构建本地离线查询工具,实现无网环境下的VBA参考查阅。
2026-10-15
8

针对办公环境网络隔离导致VBA开发不便的问题,本文介绍如何利用Python结合Selenium与Requests库,从微软官方文档网站抓取VBA API数据。通过遍历导航树获取链接,下载主体页面内容,并基于jstree构建本地离线查询工具,实现无网环境下的VBA参考查阅。
本文通过Python 3.7环境,演示如何使用Requests发起HTTP请求并处理GBK编码,结合BeautifulSoup解析HTML结构以提取51job职位列表。文章详细讲解了数据获取、解析及保存至JSON文件的完整流程,并探讨了多线程、动态渲染及数据库存储等进阶优化方向。
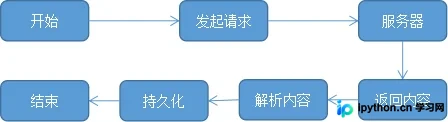
本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
本文详细解析使用Python Scrapy框架进行多页数据爬取的实现过程。通过定义通用URL模板,在parse方法中利用递归逻辑手动发送后续页码的请求,从而实现对多页内容的自动抓取与解析。
本文详解如何利用Python抓取微博移动端指定关键词的搜索结果。通过获取Cookie并分析XHR接口,构造请求参数获取数据。重点讲解使用正则表达式提取标题、评论及点赞数,并解决Unicode编码转换问题,提供完整代码示例供学习参考。
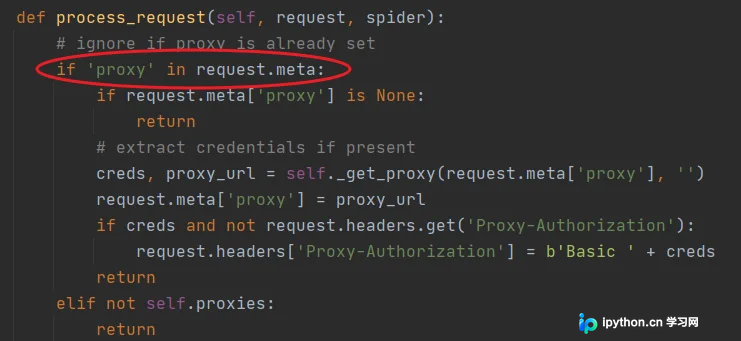
本文详细介绍Scrapy框架中代理中间件的使用与自定义方法。涵盖HttpProxyMiddleware的默认配置、通过Request meta参数设置代理、抓取快代理IP并验证可用性,以及继承HttpProxyMiddleware和直接编写中间件类两种自定义实现方案,帮助开发者解决IP被封或访问受限问题。
本文详解如何在Python Scrapy框架中集成browsercookie库,通过读取本地Firefox浏览器的Cookie实现免登录爬取。重点讲解如何替换默认的CookiesMiddleware,处理Chrome 80版本后的加密差异,并演示如何构造POST请求完成自动化点赞操作,为需要登录态的爬虫提供实用方案。
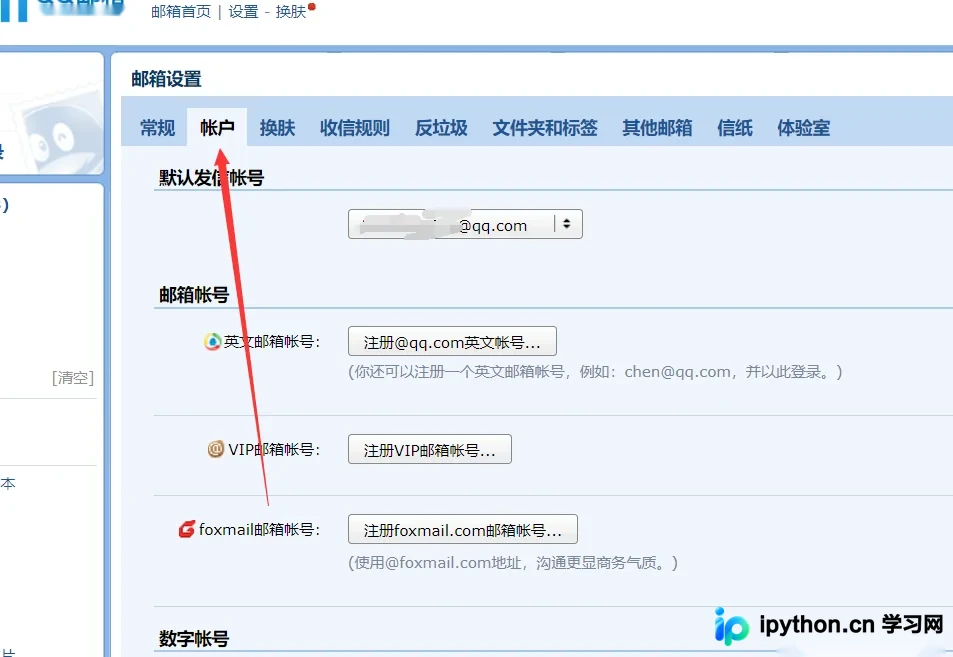
本文详细介绍如何使用Python自动发送QQ邮箱,涵盖从开启SMTP服务、获取授权码到编写发送脚本的完整流程。通过具体代码示例,演示如何发送纯文本及包含附件的邮件,并探讨结合爬虫实现自动化数据上报的进阶应用。
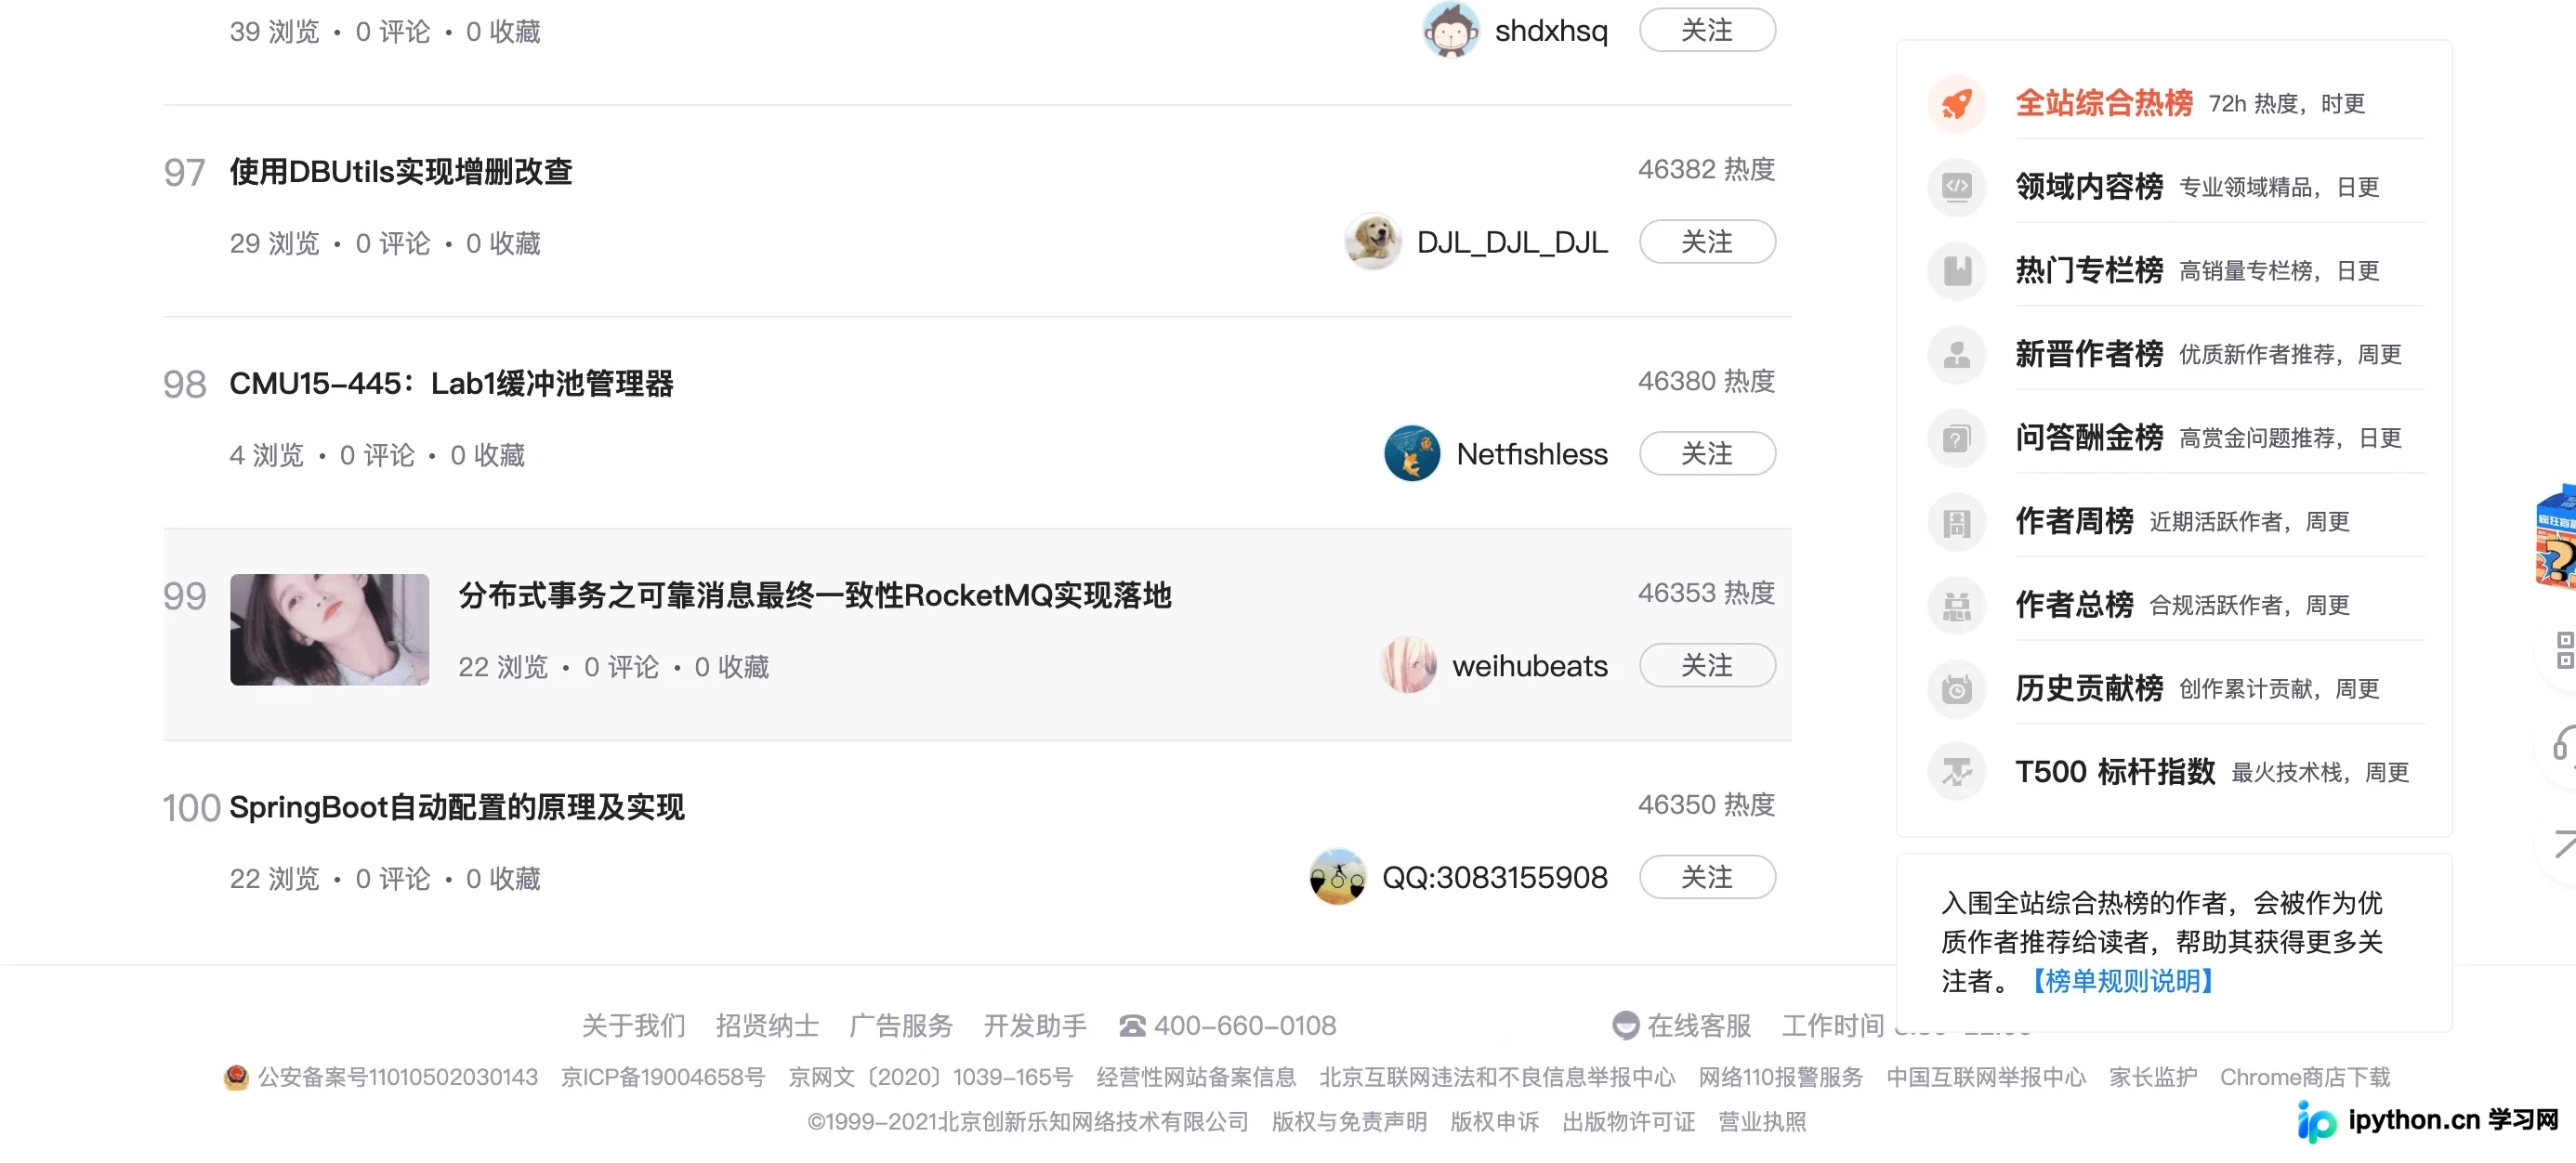
本文详细介绍如何使用Python爬取CSDN全站综合热榜的100个文章标题,并通过Jieba库进行分词与词频统计。教程涵盖使用Selenium模拟浏览器滚动加载动态页面、提取HTML源码、利用Lxml解析标题以及统计高频关键词的完整流程,旨在帮助开发者掌握动态网页抓取与数据处理技巧。
本文详细总结Python爬虫突破反爬虫机制的核心技术。内容涵盖构建合理的HTTP请求头、Cookie管理、访问延迟控制及代理IP使用。深入解析验证码(简单识别与人工打码)、IP封禁、滑动验证、防盗链关联上下文、JS运算及WebFont等常见反爬策略的应对方案,帮助开发者提升数据采集成功率。
本文详解如何利用Python从www.weather.com.cn批量爬取指定数量的图片。通过对比单线程与多线程两种实现方式,展示请求头构造、HTML解析、正则提取图片链接及本地保存的完整流程。重点解析多线程模块threading的使用及异常处理,帮助开发者提升数据抓取效率。
本文通过实测对比单线程、多线程、多进程及aiohttp协程四种方式在Python爬虫中的表现。结果显示,处理十万级页面时,aiohttp协程方案比单线程快90倍,多线程提升68倍,多进程提升7倍。文章提供了各方案的代码实现与耗时数据,为提升爬虫并发效率提供实用参考。