

Python爬取CSDN全站热榜标题并统计关键词词频实战

本文详细介绍如何使用Python爬取CSDN全站综合热榜的100个文章标题,并通过Jieba库进行分词与词频统计。教程涵盖使用Selenium模拟浏览器滚动加载动态页面、提取HTML源码、利用Lxml解析标题以及统计高频关键词的完整流程,旨在帮助开发者掌握动态网页抓取与数据处理技巧。
前言
近期出差期间,因住宿环境出现蟑螂,为排解无聊,我编写了一些爬虫代码。本文将演示如何爬取CSDN全站综合热榜的前100条标题,提取其中的关键词,并统计各关键词出现的频率。
此方法对其他博主具有参考价值,可辅助分析哪些标题更容易登上热榜。同时,文中将分享解决相关技术问题的具体方法。
环境
开发使用的集成开发环境为Spyder。若对界面风格感到不适,请予以包容,这不影响核心功能。
页面数据获取采用chromedriver驱动,具体原因将在后文说明。
中文分词工具选用Jieba库。
目标爬取页面地址为:https://blog.csdn.net/rank/list
爬虫代码
此处解释为何未直接使用Requests库获取页面源码。原因在于该页面采用动态加载机制,直接请求无法获取完整源码,必须将页面滚动至底部才能加载全部100条排名文章。
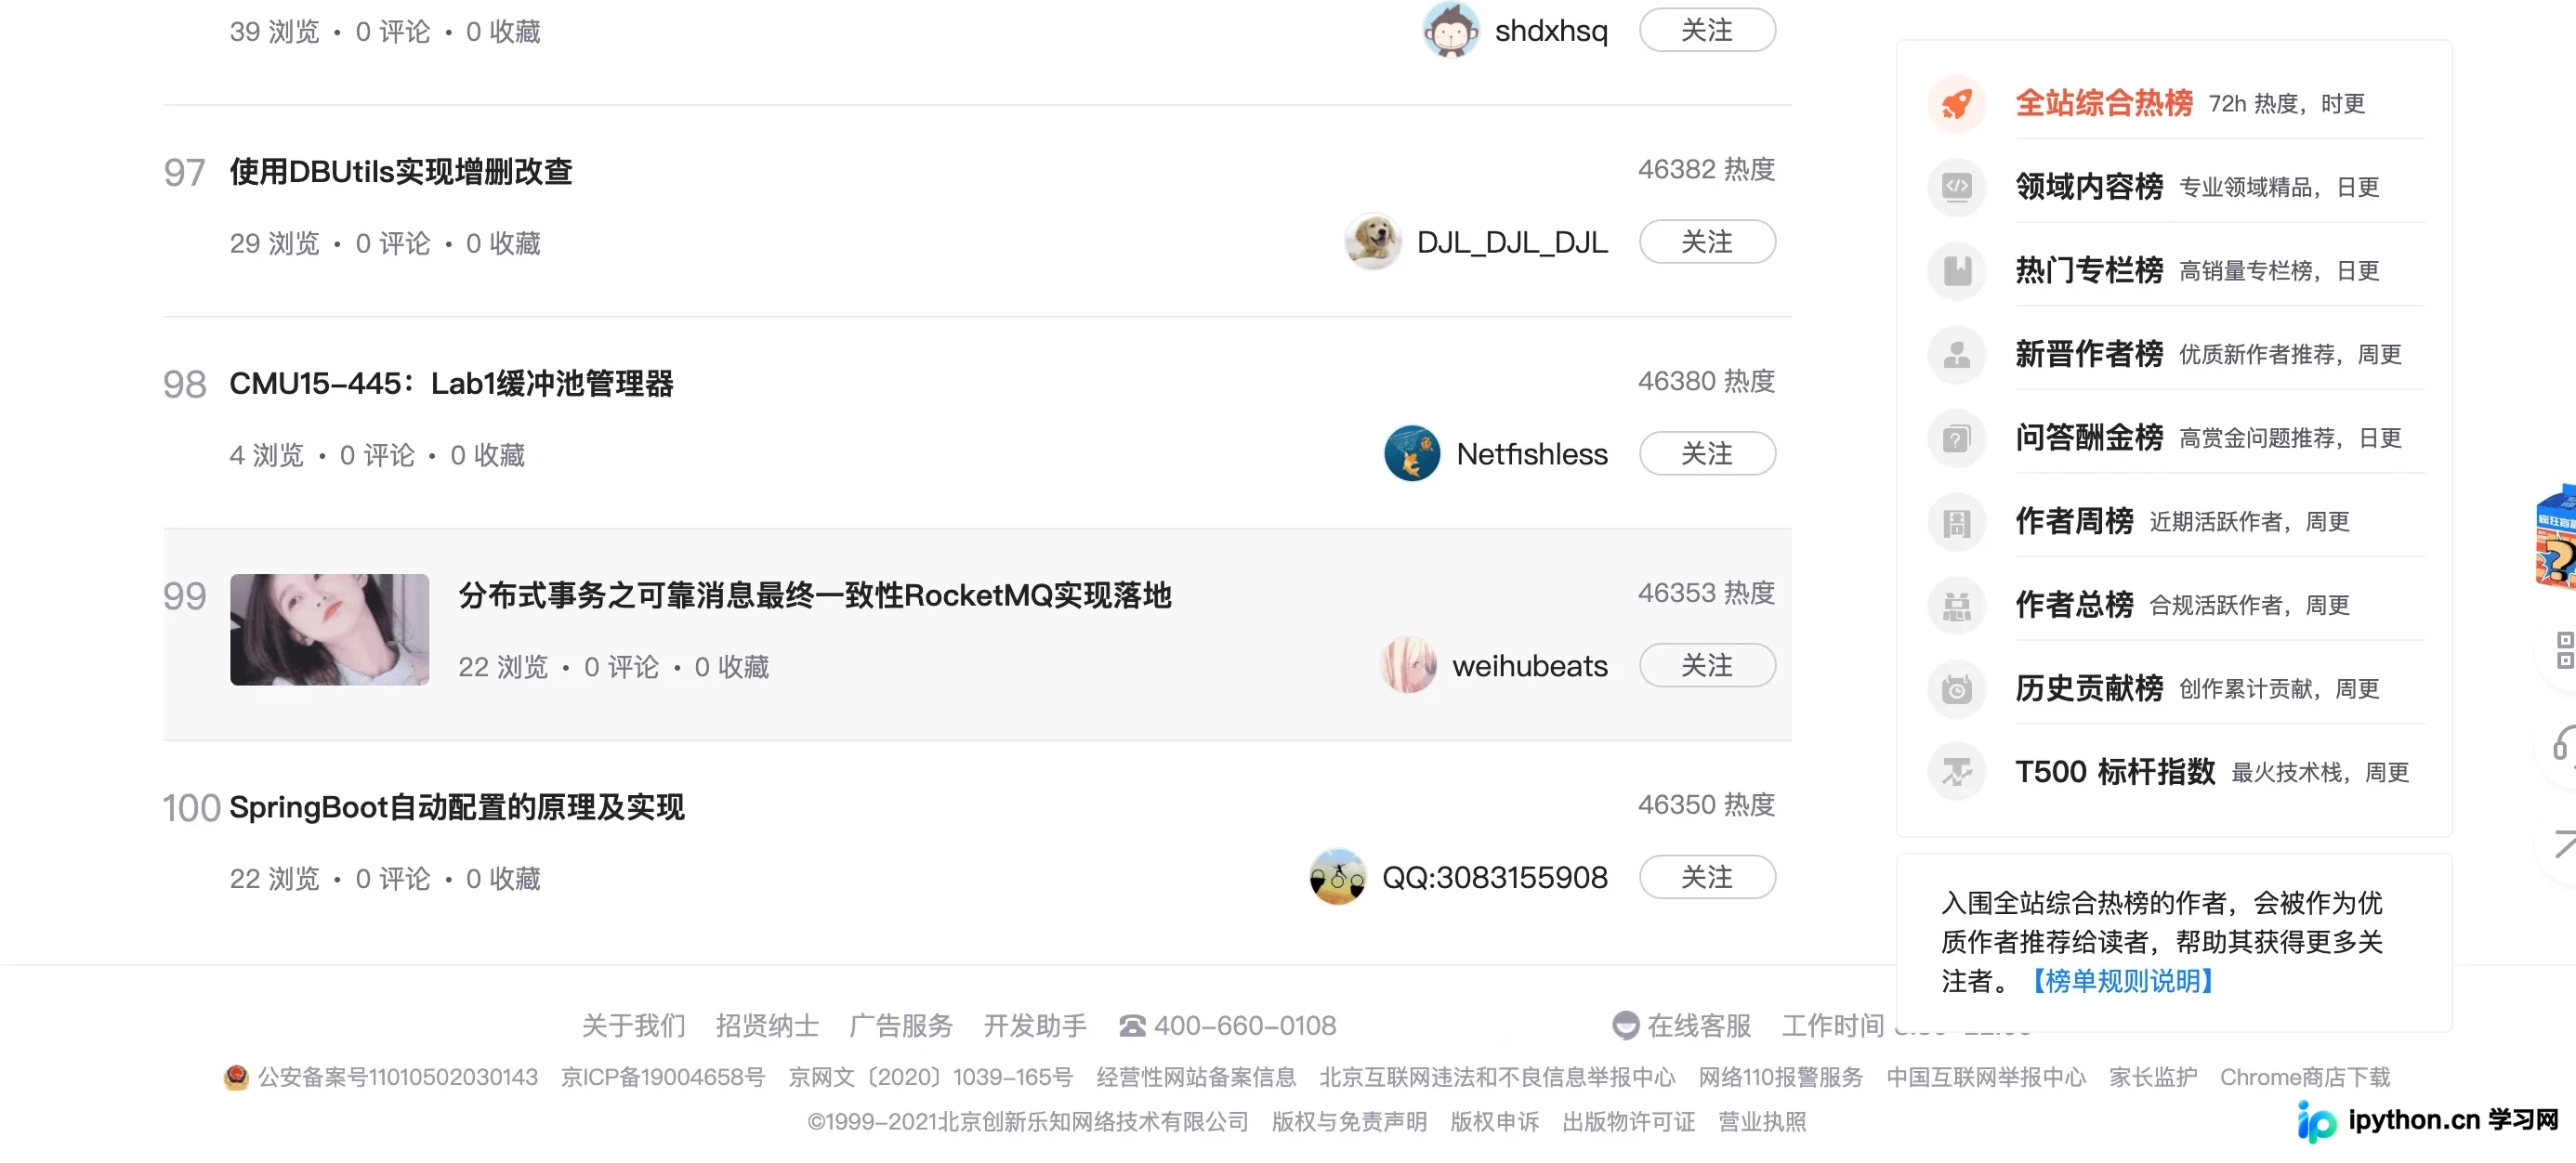
因此,我的解决方案是使用chromedriver驱动浏览器,并通过执行JavaScript代码实现页面滚动至底部。
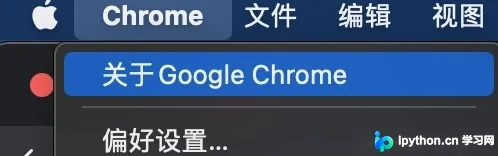
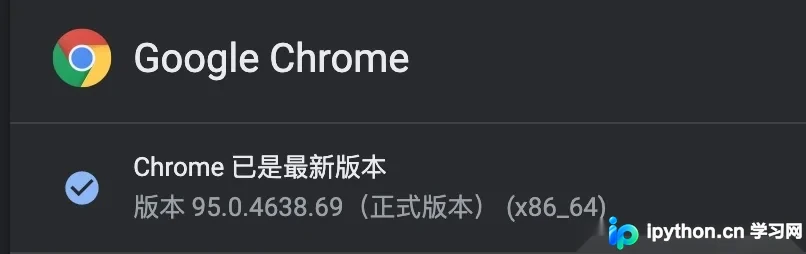
关于chromedriver的下载,需确保其版本与本地Google Chrome浏览器版本一致。以Mac系统为例,可点击左上角Chrome菜单,选择“关于Google Chrome”查看当前版本号。
提供chromedriver官方下载地址:google chrome driver下载地址
简要说明driver的工作原理:它模拟浏览器打开URL的操作,类似于人工点击行为。具体底层原理后续可另行探讨。
直接展示爬虫工具代码。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Created on Thu Nov  4 17:15:06 2021
@author: huyi
"""

from selenium import webdriver
import time

# =============================================================================
# 爬取动态下滑加载网页
# =============================================================================
def pa(url):
    driver = webdriver.Chrome('/usr/local/bin/chromedriver')
    driver.get(url)
    js = '''
                let height = 0
        let interval = setInterval(() => {
            window.scrollTo({
                top: height,
                behavior: "smooth"
            });
            height += 500
        }, 500);
        setTimeout(() => {
            clearInterval(interval)
        }, 20000);
    '''
    driver.execute_script(js)
    time.sleep(20)
    source = driver.page_source
    driver.close()
    return source
代码说明
1、该代码封装为一个工具方法,主要功能是使用driver启动浏览器,并通过JavaScript代码模拟向下滚动的操作。
2、代码中包含超时时间设置,可根据实际网络状况进行调整。若网络较慢,需适当增加超时时间,以免页面未完全滚动加载完毕程序即结束。由于宾馆网络状况较差,此处设置了较大的超时值。
3、方法最终返回页面源码,以便后续进行XPath解析。
验证一下
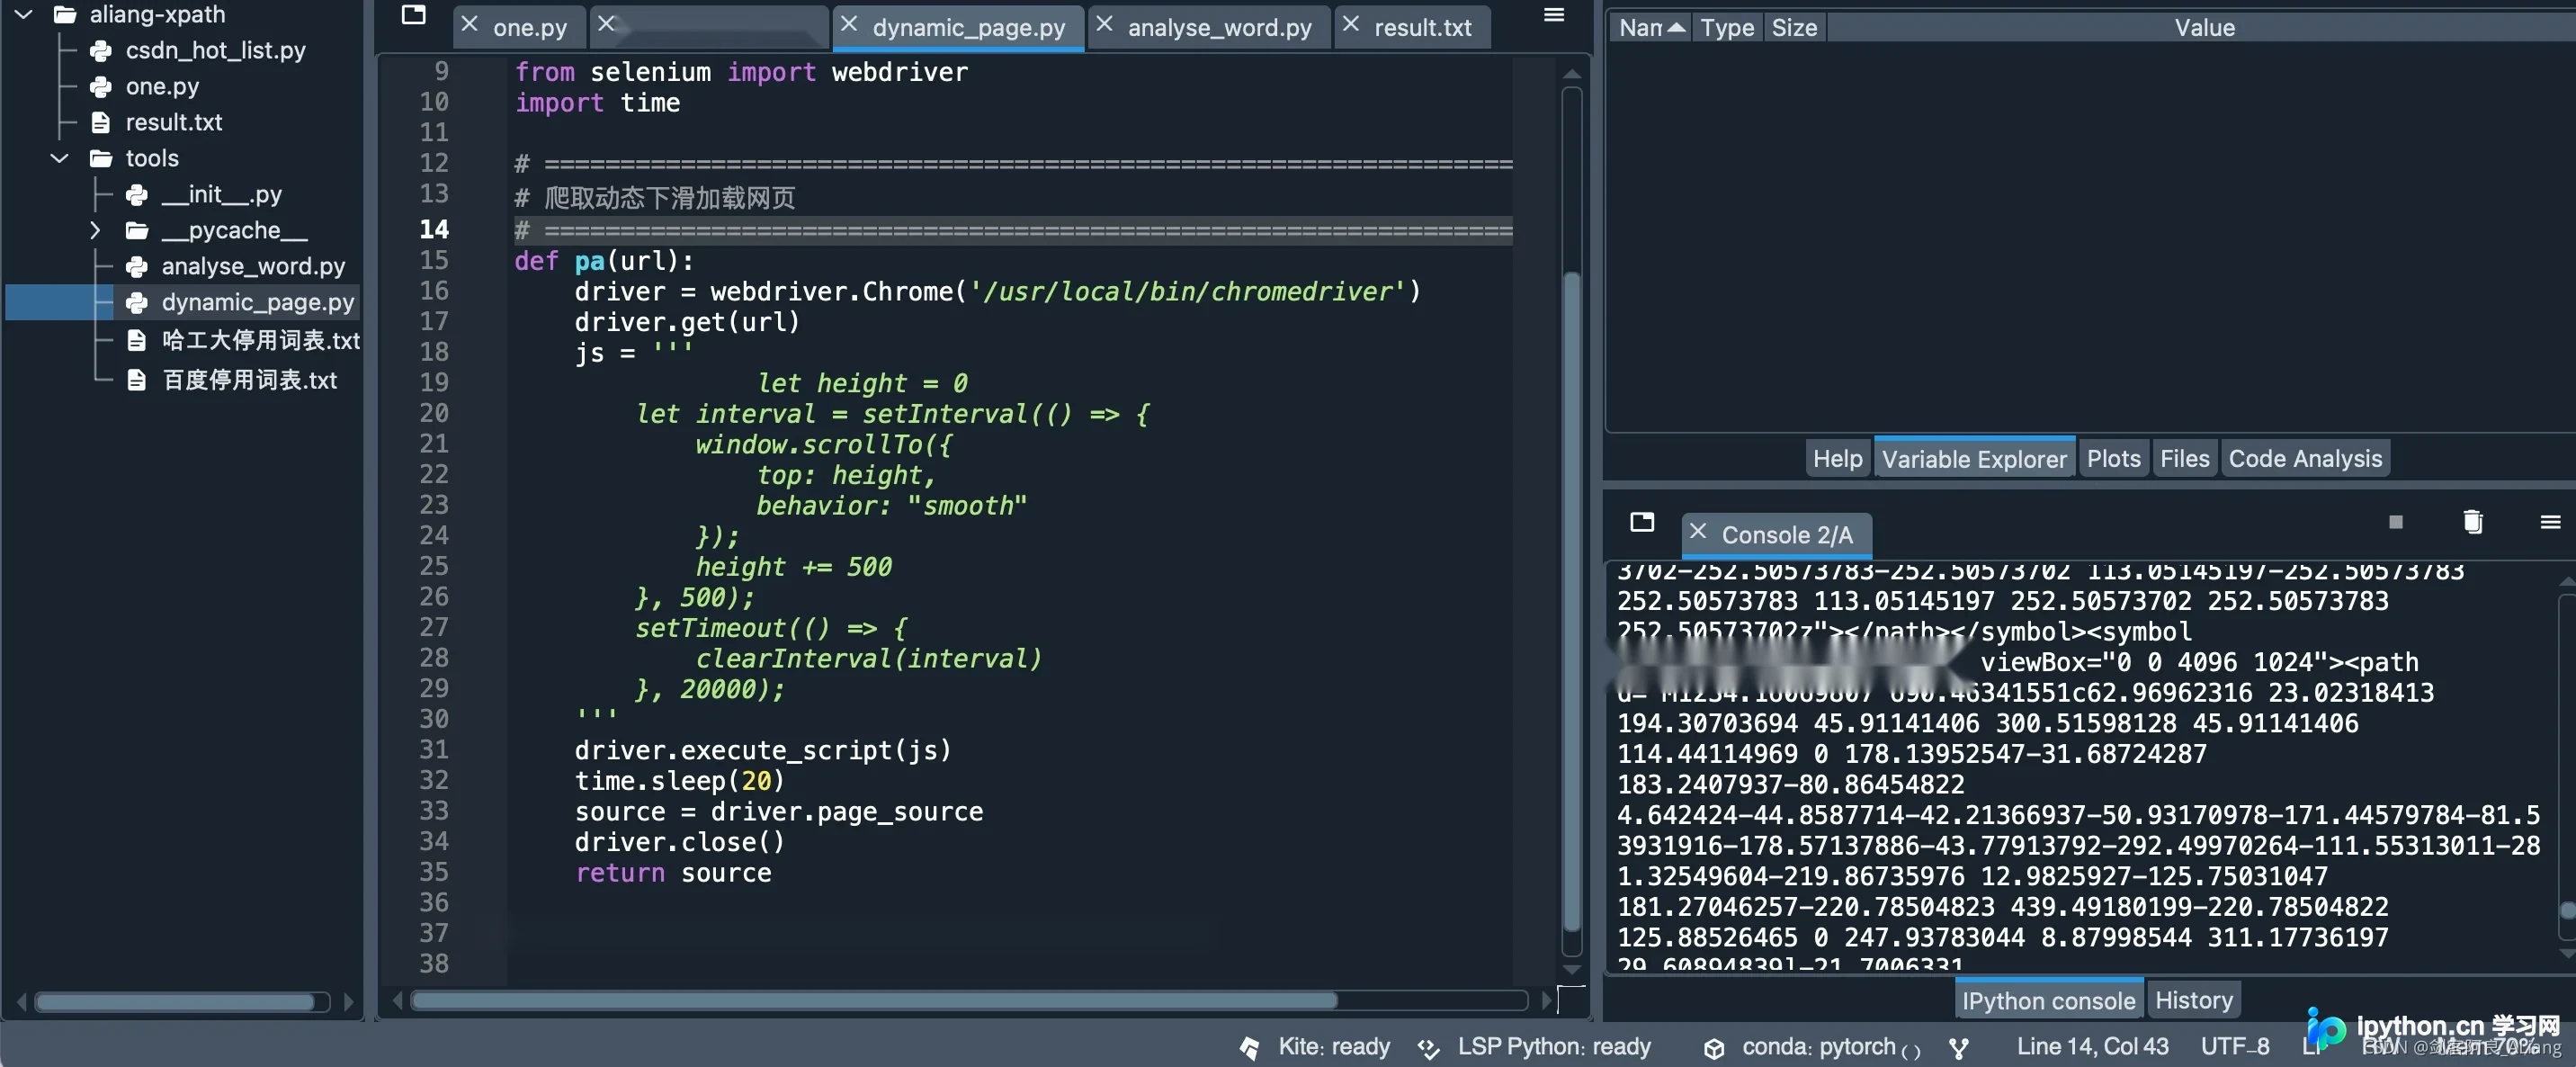
确认已成功获取页面源码。
关键词提取代码
接下来准备关键词提取的方法,直接展示代码。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Created on Thu Nov  4 21:53:22 2021
@author: huyi
"""


import jieba.analyse


def get_key_word(sentence):
    result_dic = {}
    words_lis = jieba.analyse.extract_tags(
        sentence, topK=3, withWeight=True, allowPOS=())
    for word, flag in words_lis:
        if word in result_dic:
            result_dic[word] += 1
        else:
            result_dic[word] = 1
    return result_dic
代码说明
1、该方法提取权重最高的3个词,具体数量可根据需求自行调整。
2、对提取出的相同词汇进行计数,以便后续统计100个标题中的关键词词频。
主程序代码
主程序的主要逻辑是:利用Lxml从页面源码中提取标题元素,获取标题文本后,进行词频统计并输出结果文本。
直接展示主程序代码。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Created on Thu Nov  4 14:01:38 2021
@author: huyi
"""
from lxml import etree
from tools.dynamic_page import pa
from tools.analyse_word import get_key_word


csdn_url = 'https://blog.csdn.net/rank/list'
source = etree.HTML(pa(csdn_url))

titles = source.xpath("//div[@class='hosetitem-title']/a/text()")
key_word_dic = {}
for x in titles:
    if x:
        for k, v in get_key_word(x).items():
            if k.lower() in key_word_dic:
                key_word_dic[k.lower()] += v
            else:
                key_word_dic[k.lower()] = v

word_count_sort = sorted(key_word_dic.items(),
                         key=lambda x: x[1], reverse=True)

with open('result.txt', mode='w', encoding='utf-8') as f:
    for y in word_count_sort:
        f.write('{},{}\n'.format(y[0], y[1]))
代码说明
1、关于XPath的使用:虽然Google浏览器支持右键直接复制XPath,但仍建议了解XPath相关语法以便灵活应用。
2、将所有英文单词统一转换为小写,以避免因大小写不同导致的重复统计。
3、结果按词频倒序排列,出现次数最多的关键词排在前面。
验证结果
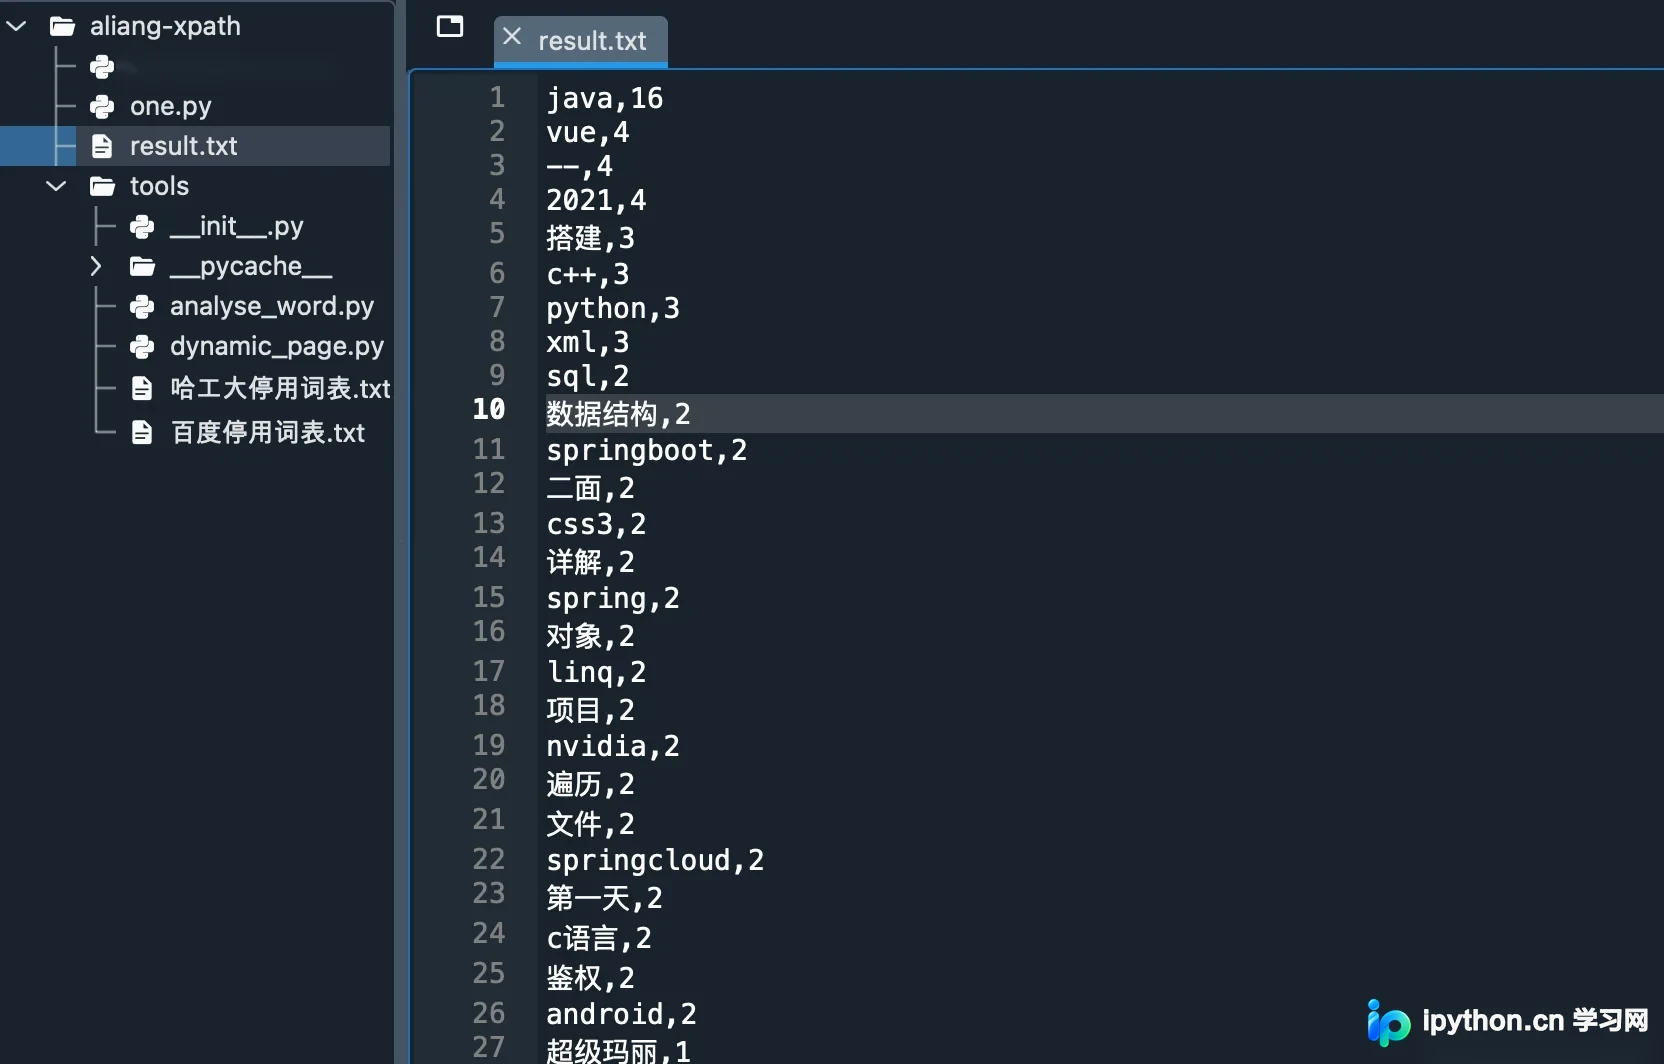
结果符合预期,Java依然是热度最高的关键词(yyds)。
总结
观察最终统计结果,其中包含部分符号。可通过Jieba停用词表进行过滤,具体筛选策略可根据实际需求调整。
郑重声明:本文案例仅用于技术研究与探索,绝非用于恶意攻击。
若本文内容对您有所帮助,请不吝赐赞,谢谢支持。
以上就是Python 详解爬取并统计CSDN全站热榜标题关键词词频流程的详细内容,更多关于Python 爬取CSDN的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









