

Python批量下载网络图片的多种实现方案与反爬应对

本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
Python下载网络图片方法概述
本文汇总了使用Python下载网络图片的几种常见方法,包括直接通过图片URL下载、利用正则表达式或BeautifulSoup解析HTML页面获取图片链接,以及针对动态网页内容的处理技巧。
已知URL的直接下载方案
通过单个或批量图片URL进行下载
当已知图片的URL格式(例如 http://xyz.com/series-*(1,2..N).jpg,共N张)且链接规律固定时,可以通过简单的循环结构,直接使用 `f.write(requests.get(url).content)` 将图片以二进制形式写入本地文件。
直接下载代码示例
import os
import requests

def download(file_path, picture_url):
	headers = {
		"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 			(KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 QIHU 360SE",
		}
	r = requests.get(picture_url, headers=headers)
	with open(file_path, 'wb') as f:
		f.write(r.content)

def main():
	os.makedirs('./pic/', exist_ok=True) # 输出目录

	prefix_url = 'http://xyz.com/series-' # 同一类目下的图片url前缀
	n = 6 # 该类目下的图片总数

	tmp = prefix_url.split('/')[-1]
	for i in range(1, n + 1):
		file_path = './pic/' + tmp + str(i) + '.jpg'
		picture_url = prefix_url + str(i) + '.jpg'
		download(file_path, picture_url)


if __name__ == '__main__':
	main()
基于正则表达式的图片解析与下载
利用正则表达式re解析HTML获取图片URL后下载
在实际场景中,图片URL往往不按顺序排列,用户通常只知道网页地址。此时需要解析当前网页的HTML内容,从中提取包含图片URL的代码。常用的方法包括使用正则表达式匹配或借助BeautifulSoup等库进行解析。
正则解析的思路如下:首先通过 `requests.get(url).text` 获取页面HTML源码;接着使用正则表达式匹配图片URL,例如 `re.compile(r'[a-zA-z]+://[^\s]*\.jpg')` 通常匹配以.jpg结尾的链接,但其他网站可能使用.png或.webp等格式,甚至需要更复杂的正则规则。因此,读者需具备一定的正则表达式知识,推荐参考《正则表达式30分钟入门教程》。最后,将匹配到的图片URL加入列表并执行下载。
正则解析代码示例
import os
import re
import requests

def get_html(url):
  headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/83.0.4103.97 Safari/537.36 ",
    }
  html = requests.get(url, headers=headers).text

  return html

def parse_html(html_text):
  picre = re.compile(r'[a-zA-z]+://[^\s]*\.jpg') # 本正则式得到.jpg结尾的url
  pic_list = re.findall(picre, html_text)

  return pic_list

def download(file_path, pic_url):
  headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/83.0.4103.97 Safari/537.36 ",
    }
  r = requests.get(pic_url, headers=headers)
  with open(file_path, 'wb') as f:
    f.write(r.content)

def main():
  # 使用时修改url即可
  url = 'http://xyz.com/series'
  html_text = get_html(url)
  pic_list = parse_html(html_text)

  os.makedirs('./pic/', exist_ok=True) # 输出目录
  for pic_url in pic_list:
    file_name = pic_url.split('/')[-1]
    file_path = './pic/' + file_name

    download(file_path, pic_url)
if __name__ == '__main__':
  main()
基于BeautifulSoup的图片解析与下载
通过bs4库获取图片URL
与正则匹配思路类似,此处通过Beautiful Soup解析HTML以获取图片URL列表,随后依次下载。由于不同网站的HTML结构存在差异,用户需根据实际情况对代码进行适当调整。以下代码示例展示了如何下载豆瓣图片。
BS4解析代码示例
import os
import time
import requests
from bs4 import BeautifulSoup

def get_html(url):
  headers = {
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 			(KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36',
  }
  html = requests.get(url, headers=headers).text

  return html

def parse_html(html_text):
  soup = BeautifulSoup(html_text, 'html.parser')
  li = soup.find_all('div', attrs={'class':'cover'})

  pic_list = []
  for link in li:
    pic_url = link.find('img').get('src')
    pic_url = pic_url.replace('/m/', '/l/')
    pic_list.append(pic_url)

  return pic_list

def download(file_path, pic_url):
  headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/83.0.4103.97 Safari/537.36 ",
    }
  r = requests.get(pic_url, headers=headers)
  with open(file_path, 'wb') as f:
    f.write(r.content)

def main():
  '从豆瓣下载石原里美图片,观察发现每页包含30张图片,其url按30递增,如下所示'
  pic_list = []
  for i in range(10):
    url = 'https://movie.douban.com/celebrity/1016930/photos/?type=C&start=' + str(30*i) + '&sortby=like&size=a&subtype=a'
    html_text = get_html(url)
    pic_list += parse_html(html_text)

  os.makedirs('./pic/', exist_ok=True) # 输出目录

  for i, pic_url in enumerate(pic_list):
    if i%30 == 0:
      print('正在下载第%s页'%(i/30+1))
    file_name = pic_url.split('/')[-1].split('.')[0] + '.jpg'
    file_path = './pic/' + file_name

    download(file_path, pic_url)

if __name__ == '__main__':
  main()
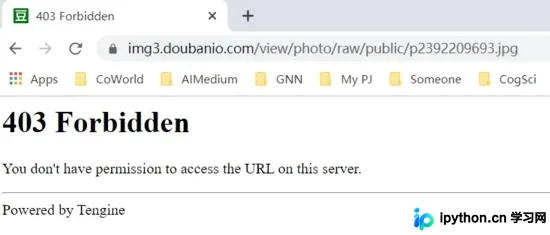
在下载过程中发现,虽然可以直接访问图片的缩略图URL进行下载,但由于豆瓣的反爬策略,直接访问原图URL会被服务器拒绝(见下图)。具体解决方法见下一部分。
应对网站反爬虫机制的策略
可能遇到的问题
网站反爬虫机制
- User-Agent:模拟浏览器访问,添加该头部后,服务器会将其视为正常的浏览器请求。一般涉及网页操作的访问都应添加此字段。
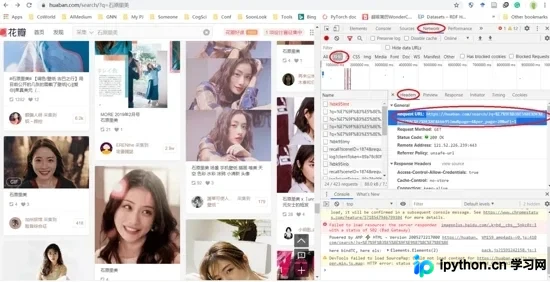
- Referer:浏览器利用该字段判断请求来源网页。例如在上述豆瓣图片下载示例中,直接输入网址会被拒绝,但在网站内逐步点击却能在同一地址获取内容,这是因为逐步访问时存在前序跳转地址。该地址可通过“F12”开发者工具在Header中查看,若找不到,可尝试根目录地址“movie.douban.com/”或前几步的访问地址……详见GitHub仓库 'adv_bs4_url.py' 文件。
- IP伪装:构建IP池以分散请求来源。
- Cookie伪装:Cookie用于服务器识别用户状态,每次向服务器请求时,Cookie都会随之更新。
- 常用正则式匹配
动态网页与异步加载数据的处理
网页数据采用异步加载,如JS渲染的页面或通过AJAX加载的数据,通过常规GET请求无法获取完整页面源码。
一种方案是所谓的动态爬虫,即采用第三方工具模拟浏览器行为加载数据,如Selenium、PhantomJS等。网络上已有较多相关文章,因较为繁琐此处未详细展开,后续如有需求再行补充,不过其他方法通常已足够使用。
另一种方法是通过分析页面找到请求接口,进而加载页面。其核心在于跟踪页面交互行为,分析JS触发的调度逻辑,找出有价值、有意义的核心调用(通常是通过JS发起的HTTP请求),然后使用Python直接访问逆向得到的链接以获取数据。通过“F12”进行分析,例如对于花瓣网,可获得其链接为“huaban.com/search/?q=石…”。使用 `request.urlopen(url).read()` 读取网页内容。
Pyautogui模拟点击方案
Pyautogui:模拟鼠标点击的“傻瓜式”流程
此方法仅适用于重复性工作,效率相对较低,但完全没有被反爬虫策略屏蔽的风险。其核心思想与Word中的“宏”类似,即告诉计算机在一次循环中鼠标如何操作,然后让其自动循环执行。代码简单明了。
Pyautogui模拟点击代码示例
import pyautogui
import time

pyautogui.FAILSAFE = True

def get_mouse_positon():
  time.sleep(3) # 此间将鼠标移动到初始位置
  x1, y1 = pyautogui.position()
  print(x1, y1)
  pyautogui.click(x=x1, y=y1, button='right') # 模拟鼠标右键点击,呼出菜单
  time.sleep(5) # 此间将鼠标移动到“save image as...”选项中央
  x2, y2 = pyautogui.position()
  print(x2, y2)
  pyautogui.click(x=x2, y=y2) # 模拟鼠标左键点击,点中“save image as...”
  time.sleep(10) # 此间弹出保存文件弹窗,自行选择保存位置,并将鼠标移至“保存(S)”按钮中央
  x3, y3 = pyautogui.position()
  pyautogui.click(x=x3, y=y3)
  print(x3, y3)


def click_download(N):
  for i in range(N): # 拟下载图片数量
    pyautogui.click(x=517, y=557, duration=0.25, button='right') # 呼出菜单,自行将x/y设置为x1/y1
    time.sleep(1)
    pyautogui.click(x=664, y=773, duration=0.25) # 下载,x/y为x2/y2
    time.sleep(1)
    pyautogui.click(x=745, y=559, duration=0.25) # 保存,x/y为x3/y3
    time.sleep(1)
    pyautogui.click(x=517, y=557, duration=0.25) # 进入下一张图片
    time.sleep(2) # 取决于网络加载速度,自行设置
 if __name__ == "__main__":
  # get_mouse_positon() # 一开始只运行此命令,获取屏幕坐标,后续注释掉该句
  click_download(10)
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









