

Python实战:利用Scrapy与browsercookie获取浏览器Cookie进行博客爬取

本文详解如何在Python Scrapy框架中集成browsercookie库,通过读取本地Firefox浏览器的Cookie实现免登录爬取。重点讲解如何替换默认的CookiesMiddleware,处理Chrome 80版本后的加密差异,并演示如何构造POST请求完成自动化点赞操作,为需要登录态的爬虫提供实用方案。
browsercookie 知识铺垫
首先需要掌握的关键技术点是利用 browsercookie 库提取浏览器中存储的 Cookie。该库可以通过执行 pip install browsercookie 命令进行安装,这是后续操作的基础环境准备。
在获取 firefox 浏览器的 Cookie 时,我们特意避开了 chrome 谷歌浏览器。这是因为在 80 版本之后,Chrome 对 Cookie 的加密机制进行了调整,导致直接使用 browsercookie 模块处理 Chrome Cookie 时会抛出如下错误信息。
win32crypt must be available to decrypt Chrome cookie on Windows
获取 Cookie 的具体代码实现如下所示:
import browsercookie

firefox_cookiejar = browsercookie.firefox()

for c in firefox_cookiejar:
    print(c)
执行上述代码后,终端将输出如下格式的内容,展示提取到的 Cookie 数据。
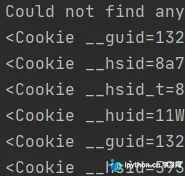
成功获取 Cookies 后,即可访问那些需要登录权限才能查看的页面。需要注意的是,这一操作的前提是用户必须在对应的火狐浏览器中已经成功登录过一次目标网站。
以某管理中心为例,在火狐浏览器完成登录后,利用 browsercookie 提取出的 Cookie 可以直接用于访问后台接口,无需再次手动输入账号密码。
import browsercookie
import requests

firefox_cookiejar = browsercookie.firefox()

# for c in firefox_cookiejar:
#     print(c)

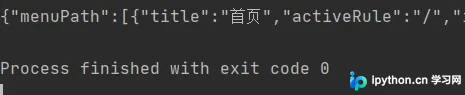
res = requests.get("https://img-home.csdnimg.cn/data_json/jsconfig/menu_path.json", cookies=firefox_cookiejar)
print(res.text)
通过这种方式,程序可以直接获取到后台菜单列表等受保护资源。
使用 browsercookie 实现 自动化点赞
在 Scrapy 框架中,系统已经内置了一个 CookiesMiddleware 中间件用于处理 Cookie 逻辑。本次实战中,我们将通过继承 CookiesMiddleware 类,并结合 browsercookie 库来开发一个点赞器。这是一个测试案例,并未启用并发处理以提高调试效率。
打开 middlewares.py 文件,在其中编写自定义的中间件类:
from scrapy.downloadermiddlewares.cookies import CookiesMiddleware
import browsercookie
class BrowserCookiesDownloaderMiddleware(CookiesMiddleware):
    def __init__(self, debug=False):
        super().__init__(debug)
        self.load_browser_cookies()

    def load_browser_cookies(self):
        # 注意这个地方的名字叫做 firefox
        jar = self.jars['firefox']
        firefox_cookiejar = browsercookie.firefox()
        for cookie in firefox_cookiejar:
            jar.set_cookie(cookie)
上述自定义类的核心逻辑在于调用 browsercookie 模块来提取浏览器的 Cookie,并将其存储到 CookieJar 类型的字典 jars 中。在后续发起网络请求时,程序会从该字典中读取并调用相应的 Cookie 信息。
同时,需要在 settings.py 配置文件中禁用默认的 CookiesMiddleware 中间件,并启用我们刚才自定义的新类,以确保 Scrapy 使用我们定制的 Cookie 处理逻辑。
DOWNLOADER_MIDDLEWARES = {
    'scrapy.downloadermiddlewares.cookies.CookiesMiddleware': None,
    'csdn.middlewares.BrowserCookiesDownloaderMiddleware': 543,
}
在编写爬虫的核心函数时,重点是将 Request 请求修改为 POST 请求,并携带必要的参数,同时通过 meta={'cookiejar':COOKIEJAR} 指定使用的 CookieJar。具体代码如下所示:
import scrapy
class ClikeSpider(scrapy.Spider):
    name = 'clike'
    allowed_domains = ['csdn.net']
    like_url = 'https://blog.csdn.net/phoenix/web/v1/article/like'
    def start_requests(self):
        data = {
            "articleId": "120845464",
        }
        yield scrapy.FormRequest(url=self.like_url, formdata=data, meta={'cookiejar': 'firefox'})
    def parse(self, response):
        print(response.json())
运行爬虫程序后,观察日志输出可以发现点赞操作已成功执行。

以上就是 Python 实战 Scrapy 操作 Cookie 爬取博客涉及 browsercookie 的详细内容,更多关于 Scrapy 操作 Cookie 爬取博客的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









