Python 使用 Selenium 和 Requests 爬取西瓜视频完整教程
本文详细介绍如何利用 Python 的 Selenium 和 Requests 库爬取西瓜视频。通过构建 embedUrl 获取 group_id,使用无头浏览器模拟访问提取视频真实地址,最后拼接 http 协议并下载二进制数据保存为 mp4 文件。
2026-10-15
6

本文详细介绍如何利用 Python 的 Selenium 和 Requests 库爬取西瓜视频。通过构建 embedUrl 获取 group_id,使用无头浏览器模拟访问提取视频真实地址,最后拼接 http 协议并下载二进制数据保存为 mp4 文件。
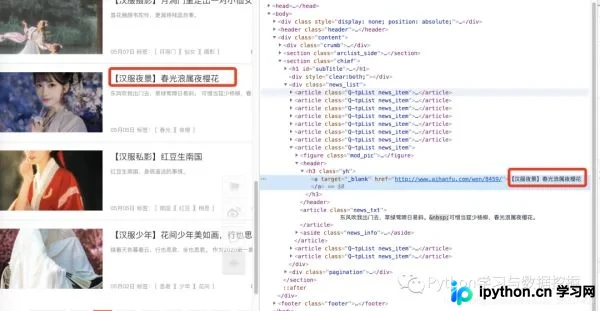
本文介绍如何使用Python编写百行代码,通过XPath定位元素,自动遍历汉服资讯网站分页,提取文章标题与图片链接,并批量下载高清图片至本地文件夹。
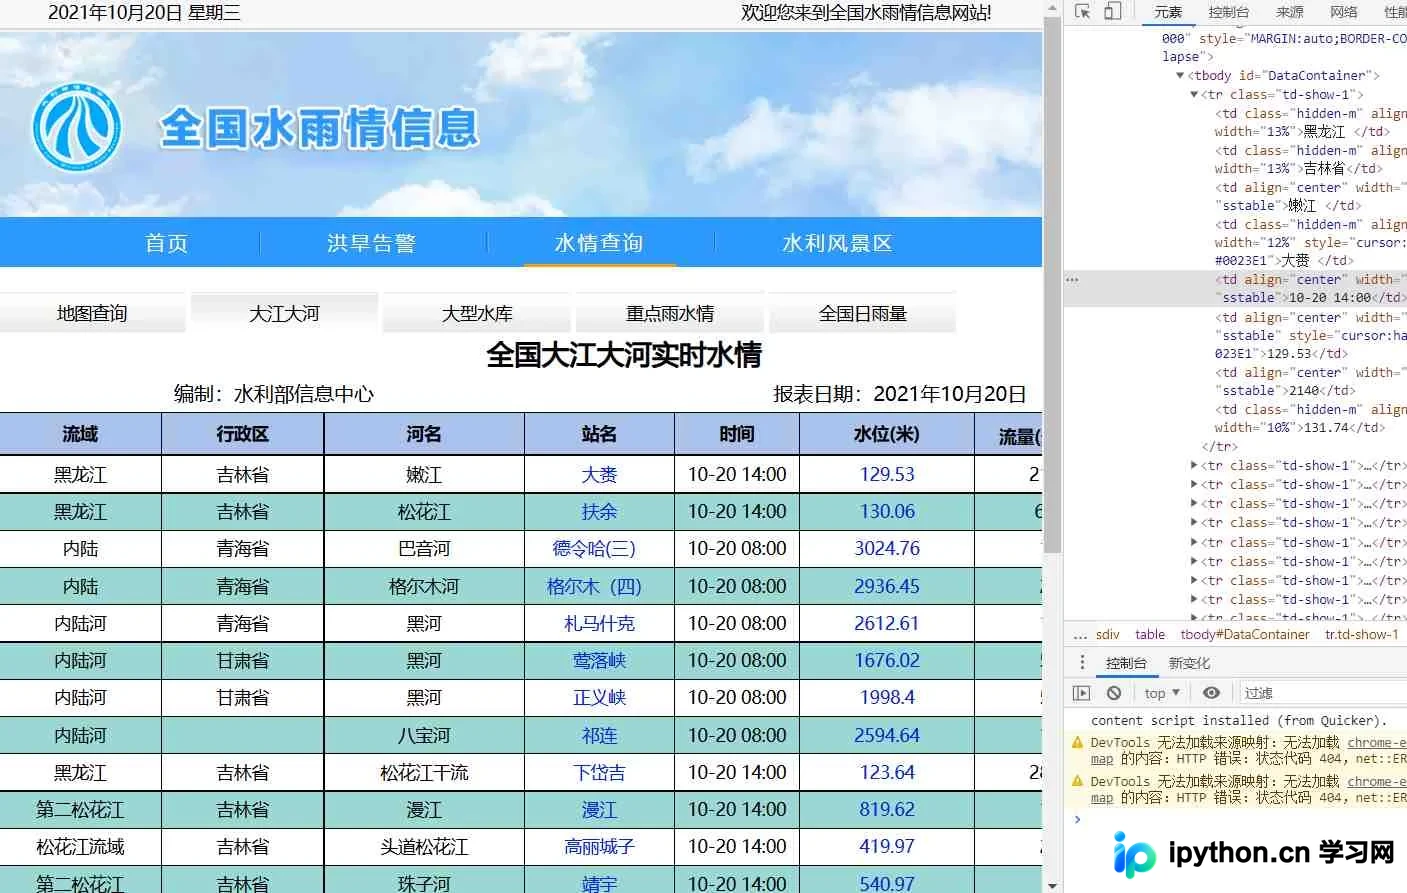
本文详细解析如何使用Python结合Selenium库爬取全国水雨情信息。针对无直接接口的情况,通过模拟浏览器行为获取页面数据,并利用pandas进行清洗与存储。文章涵盖代码实现、结果展示及常见问题分析,包括时间处理、代码优化建议,为相关数据采集提供完整参考。
本文介绍如何使用Python编写一个简单的新闻爬虫程序。通过requests获取网页HTML,利用bs4解析提取标题与正文,并结合Tkinter构建图形界面。最后使用PyInstaller将脚本编译为独立的exe文件,实现无需Python环境即可运行的新闻查看工具。
本文介绍基于Python3和Windows环境的爬虫开发基础,涵盖Anaconda与Jupyter工具使用。详细解析Robots协议规范、动态页面处理及反爬策略。同时展望Python在数据分析、人工智能、运维自动化及Web开发领域的核心应用与实战价值。
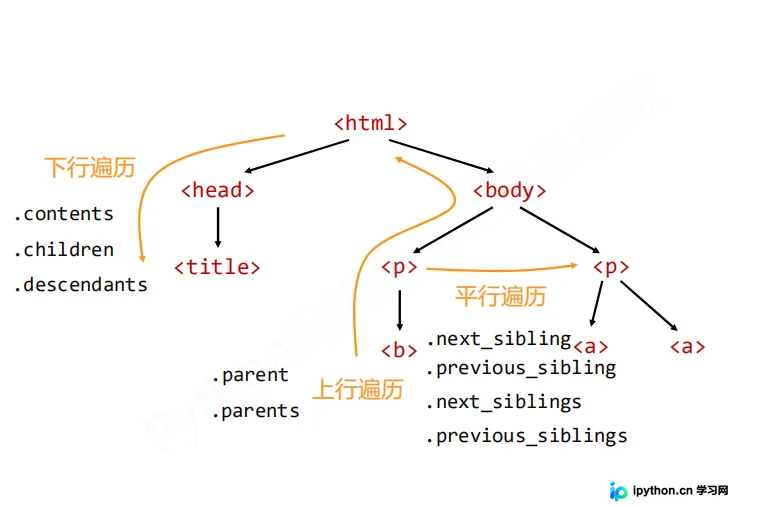
本文详细介绍Python中BeautifulSoup库的安装方法及核心功能。内容涵盖从bs4库的引用、BeautifulSoup类的基本概念,到Tag标签的name、attrs及字符串类型解析。重点讲解标签树的上下行与平行遍历操作,以及prettify()格式化输出和编码处理,帮助开发者快速掌握HTML/XML文档解析技巧。
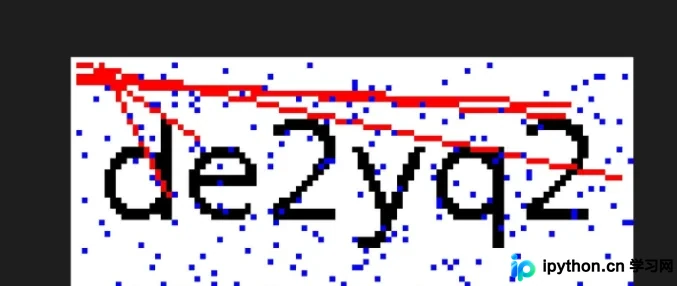
本文详细介绍使用Python进行验证码识别的完整流程。从批量下载验证码图片开始,通过二值化与灰度转换初步处理,重点讲解利用PIL库实现8邻域降噪算法去除干扰线。针对彩色验证码,提出基于颜色过滤的智能去噪策略,并结合Tesseract或tesserocr库实现最终的文字识别,提供完整代码示例与效果对比。
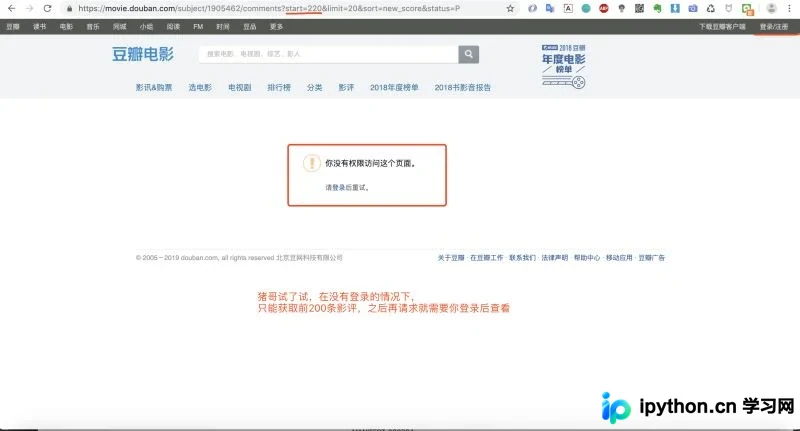
本文详解如何使用Python的requests库实现豆瓣登录及会话状态保持,通过Session对象自动管理Cookie,进而批量抓取《荒野生存》影评数据。结合正则表达式提取内容,利用结巴分词与词云库进行数据分析,完整展示从登录接口分析到数据可视化的全流程。
本文总结了利用Python读取微信朋友圈的四种方法。首先排除了通过好友链接查看自身朋友圈及已关闭的网页版微信方案。接着分析了基于Appium模拟器的可行性,重点介绍了通过pywinauto库模拟PC微信窗口操作的具体实现。文章提供了获取进程、定位控件、模拟点击及读取数据的完整代码示例,并探讨了后续数据清洗与自动回复的扩展方向。
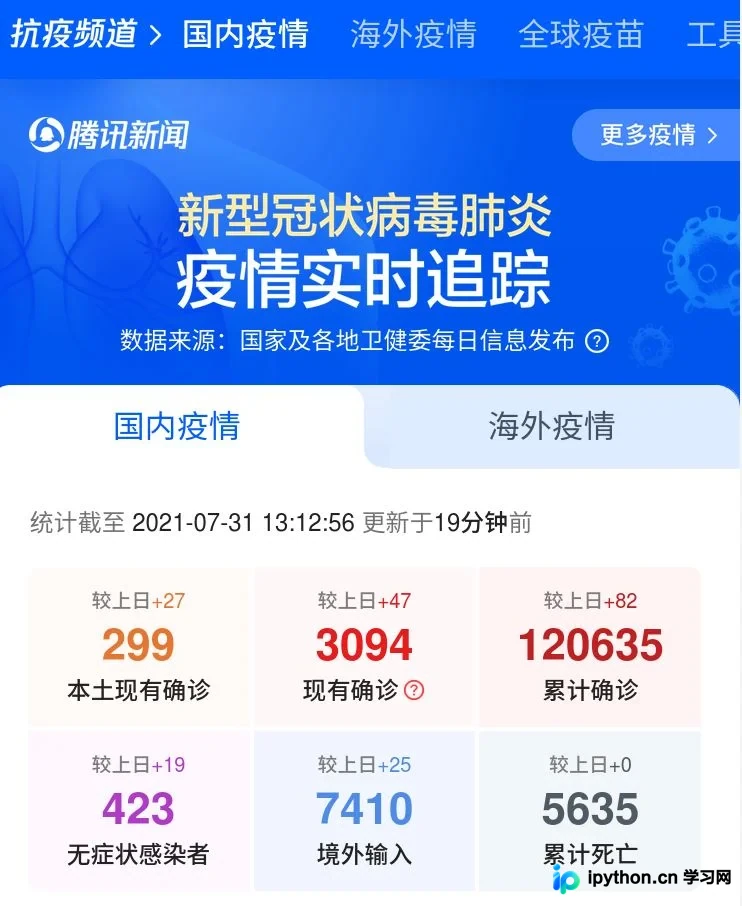
本文介绍如何使用Python的requests库抓取腾讯新闻疫情实时数据接口,并通过json解析提取全国及江苏省各地级市的确诊、新增及治愈数据。结合PrettyTable美化输出,最后利用matplotlib库对江苏各地市疫情分布进行可视化分析,直观展示扬州等地疫情状况。
本文详细解析Python中urllib标准库与第三方库urllib3的区别。urllib包含request、parse、error和robotparser四个模块,适用于基础网络请求。urllib3功能更强大,支持连接池、线程安全、代理及SSL验证。文章通过代码示例对比两者在GET/POST请求、Cookie处理、代理设置、文件上传及超时处理上的具体用法,帮助开发者根据需求选择合适的库。
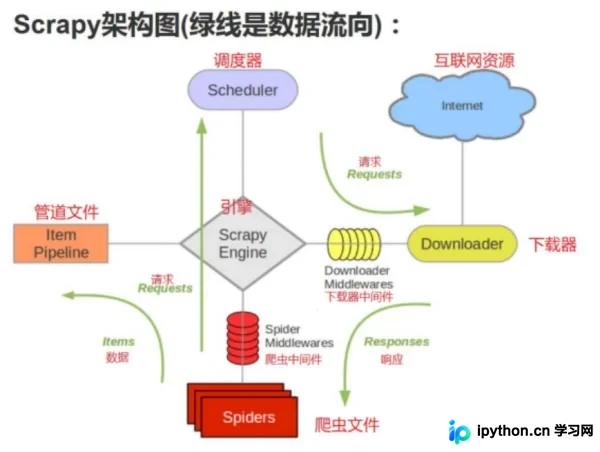
本文深入解析Scrapy爬虫框架的核心结构,详细阐述引擎、调度器、下载器、蜘蛛及管道等关键组件的功能与交互机制。通过梳理项目目录结构与数据流动路径,帮助开发者理解Scrapy为何被视为完整框架而非简单库,并掌握其高效处理网络请求与数据提取的工作原理。