Python爬取微信公众号文章实战:解决Cookie失效与代理配置问题
本文基于《Python3网络爬虫开发实践》案例,针对腾讯网站更新后导致的Cookie登录失效问题提供解决方案。通过整合Selenium浏览器自动化与代理池技术,详细演示了如何配置Chrome驱动、设置请求头及处理重试机制,帮助开发者应对反爬策略变更,实现稳定的微信文章数据抓取。
2026-10-13
6

本文基于《Python3网络爬虫开发实践》案例,针对腾讯网站更新后导致的Cookie登录失效问题提供解决方案。通过整合Selenium浏览器自动化与代理池技术,详细演示了如何配置Chrome驱动、设置请求头及处理重试机制,帮助开发者应对反爬策略变更,实现稳定的微信文章数据抓取。
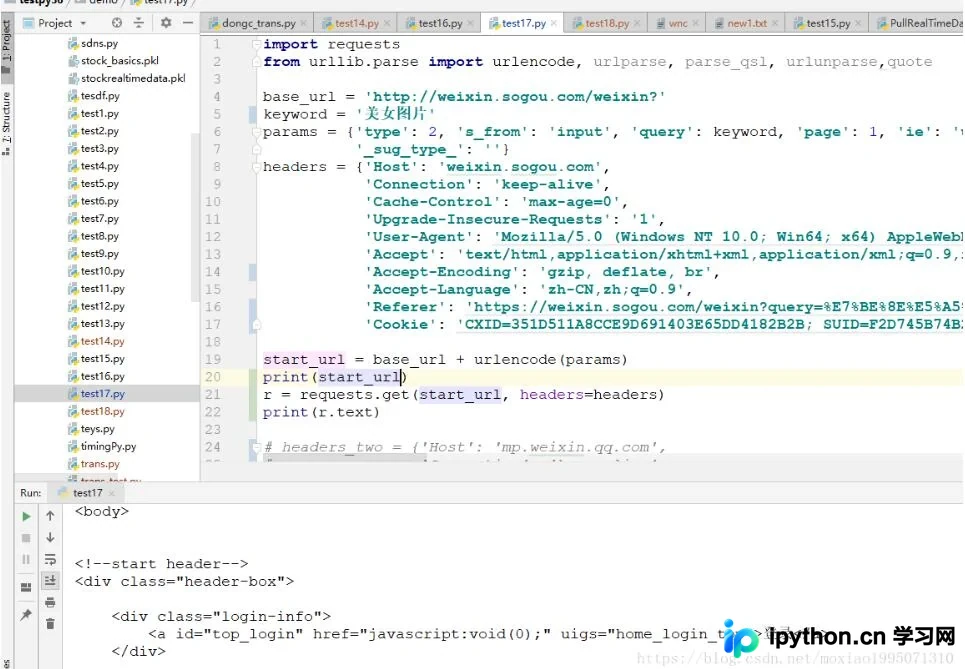
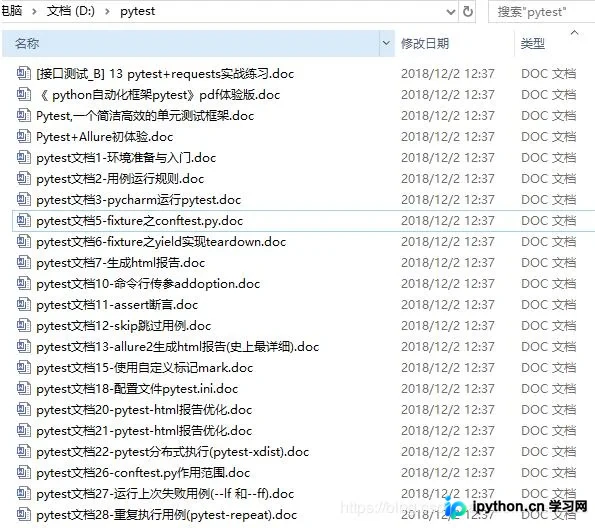
本文介绍使用Python脚本从搜狗微信搜索抓取特定公众号文章的方法。通过requests获取列表页,利用bs4解析标题与链接,并结合自定义HTML解析器将文章内容、代码块及图片提取并保存为Word文档。示例以“从零开始学自动化测试”公众号的pytest系列文档为例,展示了完整的下载与转换流程。
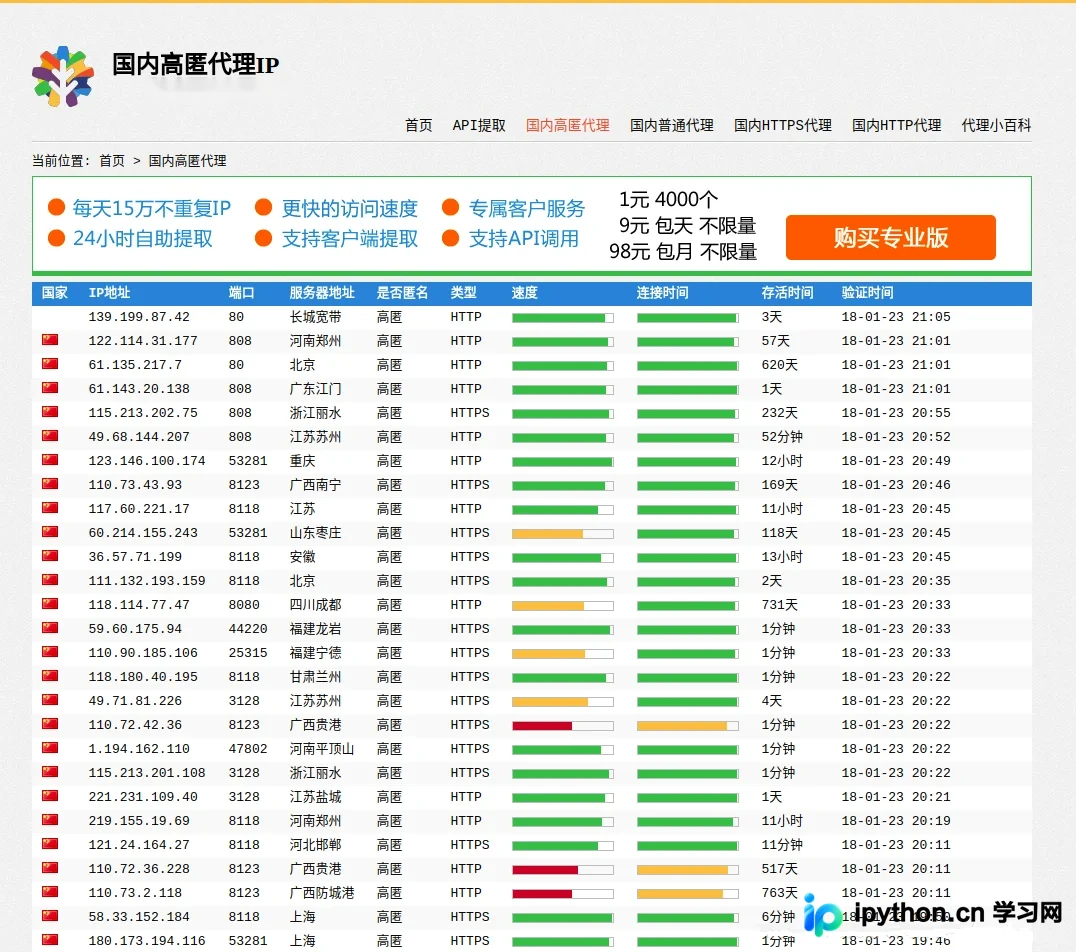
本文详细介绍如何使用Scrapy框架爬取西刺代理网的免费高匿IP数据,并将结果保存至MySQL数据库。教程涵盖项目创建、Item定义、Spider编写、Pipeline配置及Settings设置等完整步骤,代码示例仅展示前10页数据抓取逻辑,适合Python初学者参考学习。
本文介绍Python中fake-useragent库的安装与使用方法,展示如何随机生成各类浏览器UserAgent以辅助爬虫开发。重点解析缓存异常FakeUserAgentError的解决方案,包括禁用服务器缓存及添加本地数据文件的高级配置,帮助开发者规避网络请求失败问题。
本文分享利用Python抓取CNVD工控漏洞库信息的完整流程。针对网站反爬虫机制,通过模拟请求头、Cookie及Selenium自动化浏览器技术解决访问限制。代码涵盖从分页URL抓取到详情页信息提取的全过程,旨在帮助安全研究人员高效整理漏洞数据。
本文介绍如何利用Python进行历史天气数据的采集与分析。通过编写脚本获取天气信息,并将数据存入MySQL数据库及Excel文件中,为后续趋势分析提供数据支持。文章包含完整代码示例,适合对数据抓取和存储感兴趣的开发者参考。
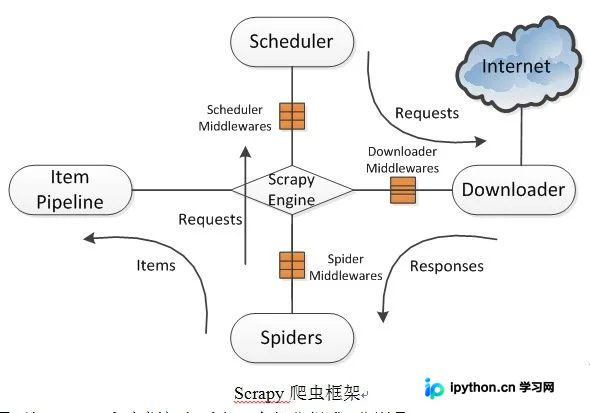
本文深入解析Scrapy网络爬虫框架的工作原理,详细阐述引擎、调度器、下载器、蜘蛛及管道五大核心组件的交互流程。同时提供基于Scrapy创建爬虫项目的完整命令行操作指南,涵盖项目结构解析、关键配置文件说明及程序执行方法,帮助开发者快速掌握Scrapy的数据采集与处理流程。
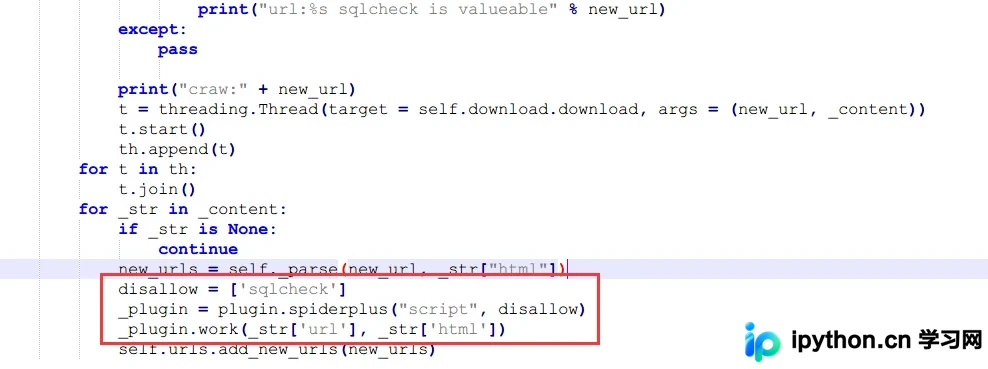
本文详解Python爬虫插件系统的开发流程,涵盖动态调用模块、扫描目录及参数传递机制。通过修改Spider类与脚本文件,实现SQL注入检测与E-Mail收集功能,提供完整代码示例与运行结果分析,帮助开发者快速构建可扩展的安全测试工具。
本文详细介绍如何使用Python编写一个集网页爬虫与SQL注入检测于一体的插件。通过构建多线程爬虫管理URL,利用布尔盲注Payload对比页面响应差异来检测注入点,并结合正则表达式识别数据库类型。文章提供完整的代码结构、依赖库安装及核心逻辑解析,适用于安全研究人员进行自动化漏洞扫描开发。
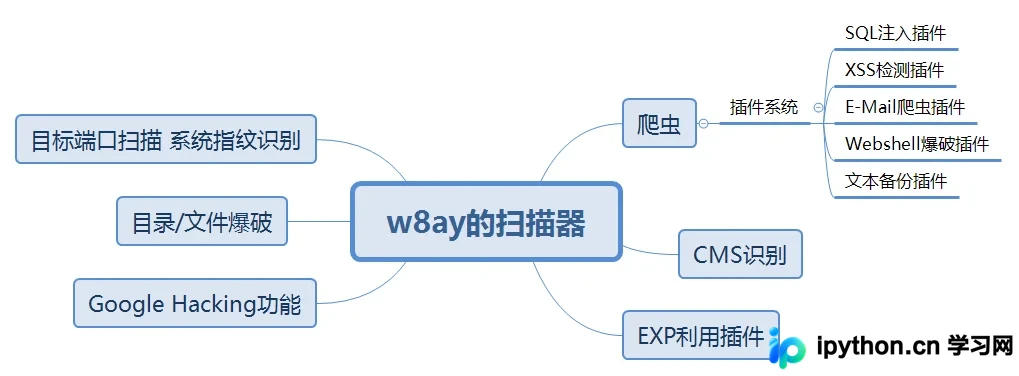
本文介绍如何使用Python实现桌面壁纸的自动切换功能。通过requests库从指定网站抓取图片URL并下载,结合win32api和win32gui模块修改Windows注册表及调用SystemParametersInfo接口,实现定期自动更换壁纸。代码包含完整的抓取、下载及设置流程,适合希望自定义桌面环境的用户参考。
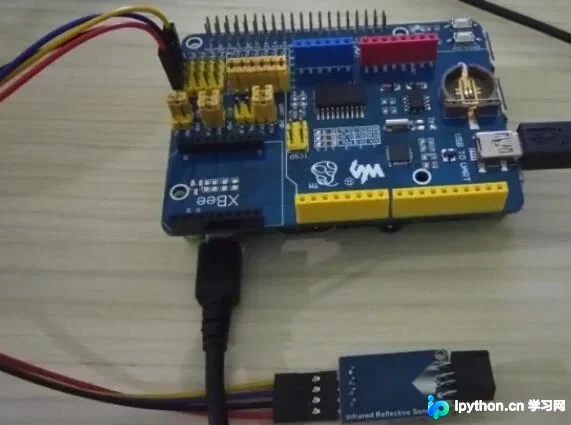
本文介绍利用Python在树莓派上驱动红外反射传感器的方法。通过微雪ARPI600扩展板及TLC1543芯片进行模拟信号AD转换,结合GPIO模拟SPI通信读取数据。程序通过DOUT引脚判断障碍物距离,并实时输出AD转换数值,适用于近距离物体检测场景。
本文详细讲解如何在Python环境中安装Scrapy爬虫框架,并介绍如何利用PyCharm完成项目的初始化与Spider创建。内容涵盖使用国内豆瓣源解决安装慢的问题、验证安装版本、通过命令行创建项目结构以及在IDE中生成Spider模板的完整操作流程,帮助开发者快速上手Scrapy开发。