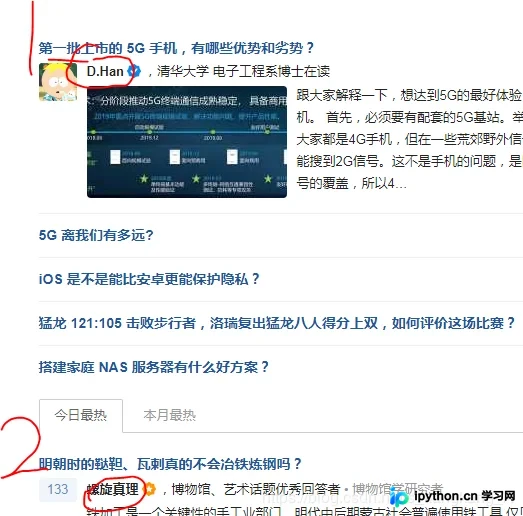
Python3爬虫实战:知乎热门话题数据抓取与TXT存储详解
本文详解使用Python3的Requests库和正则表达式爬取知乎热门话题的方法。重点解决作者匿名导致的数量偏差、标题与内容不匹配等问题,并通过正则处理HTML标签。最后演示如何将抓取到的标题、作者及内容完整保存至本地TXT文件,附带文件打开模式说明。
2026-10-13
6

本文详解使用Python3的Requests库和正则表达式爬取知乎热门话题的方法。重点解决作者匿名导致的数量偏差、标题与内容不匹配等问题,并通过正则处理HTML标签。最后演示如何将抓取到的标题、作者及内容完整保存至本地TXT文件,附带文件打开模式说明。
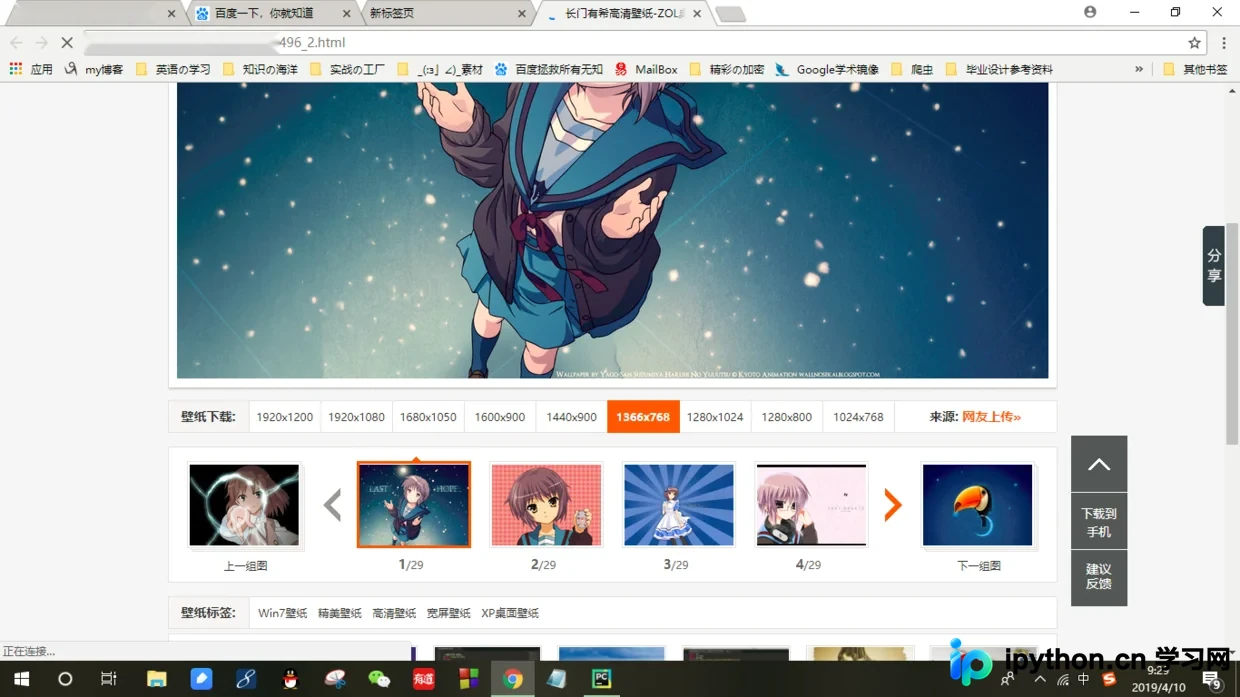
本文详解使用Python爬取高清壁纸的完整流程。通过模拟人工浏览步骤,包括访问列表页、解析源码获取子页面链接、进入详情页选择分辨率及最终下载图片,实现自动化批量获取。文中结合具体案例与代码注释,解析如何构造请求地址及处理中间链接,帮助开发者掌握静态网页图片抓取的核心技巧。
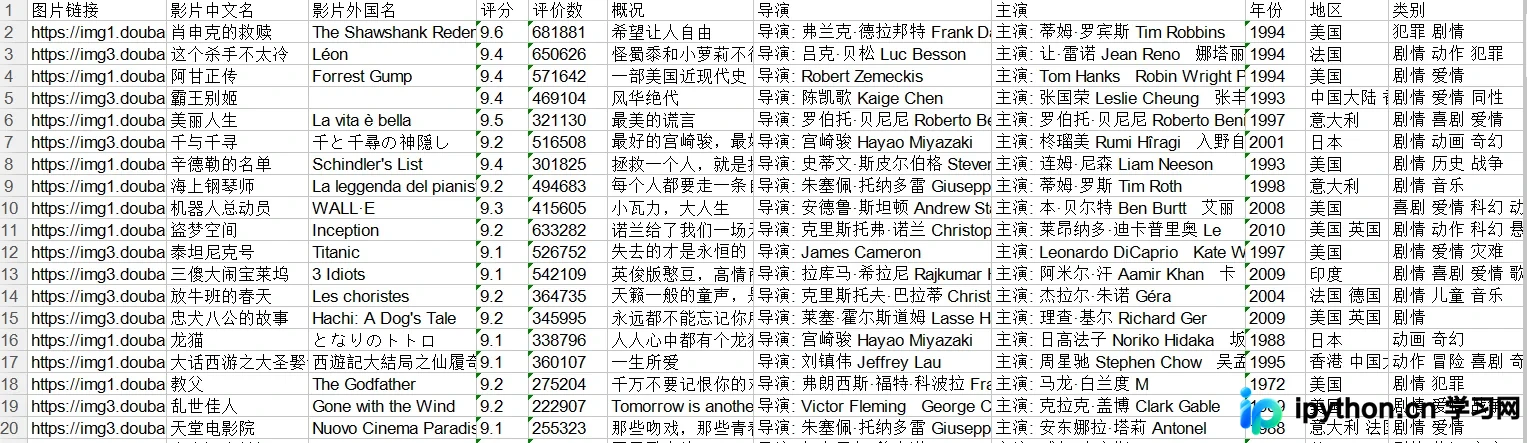
本文详细演示如何使用Python爬取豆瓣电影Top250的12项关键信息,包括链接、评分、主演及年份等。通过正则表达式解析HTML,利用BeautifulSoup和xlwt库将数据整理并写入Excel文件,提供完整代码供参考。
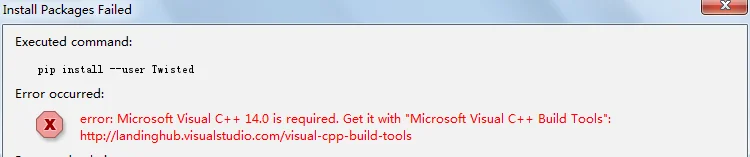
本文记录在Python3.6环境下安装Scrapy依赖模块Twisted时遇到的常见报错问题。通过对比PyCharm与命令行pip安装,发现直接pip install常因版本不匹配失败。最终通过从Gohlke网站下载对应Python位数(32位或64位)的whl文件解决,强调了匹配Python架构的重要性。
本文通过Python实战案例,详细解析如何模拟登录CSDN平台。内容涵盖从导入必要库、获取请求头部信息、解析网页结构,到维持登录状态Session及验证登录结果的完整代码流程。旨在帮助开发者理解模拟登录的核心逻辑,提升Python网络编程与爬虫开发能力。
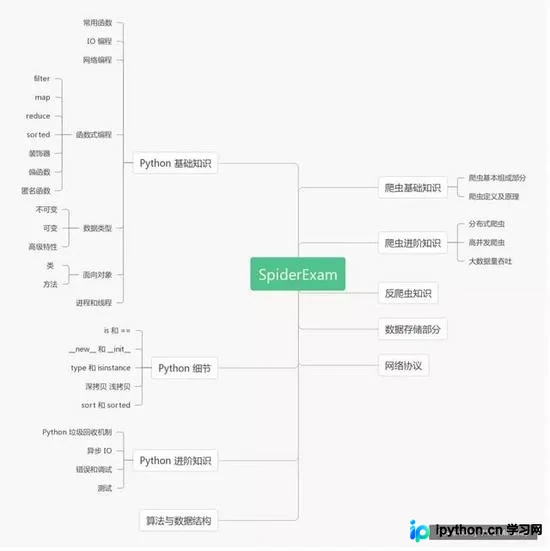
本文系统梳理Python爬虫工程师面试高频考点,涵盖Python语言特性、6种内置数据类型辨析、CPython运行机制及GIL锁原理。深入解析深/浅拷贝、is与==区别、文件IO操作及一行代码实现技巧,并对比多进程与多线程的稳定性差异,助力求职者掌握核心基础知识。
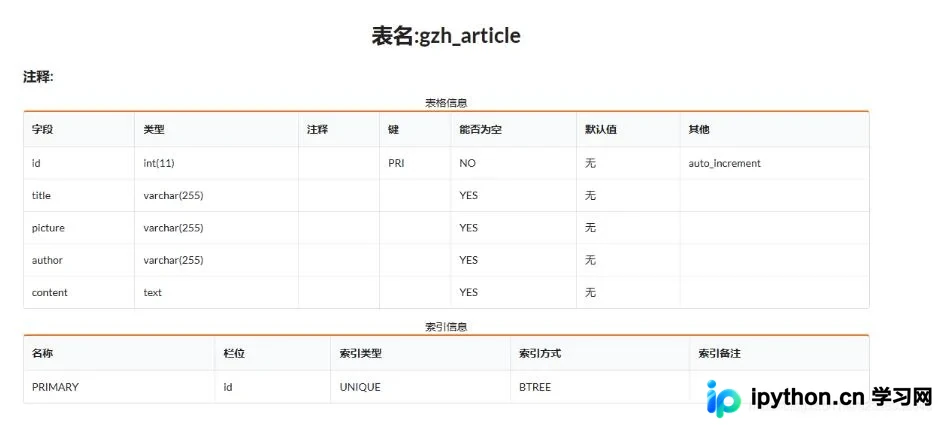
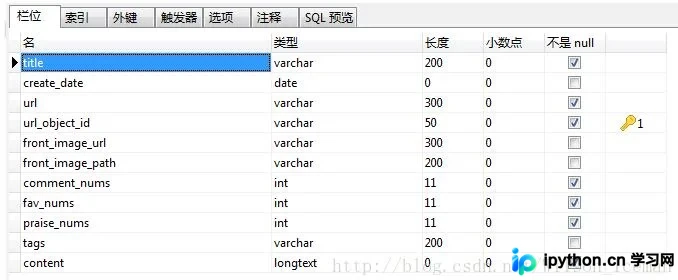
本文介绍如何使用Python编写爬虫程序,通过搜狗微信搜索接口抓取公众号文章标题、封面及正文内容,并利用pymysql库将数据持久化存储到MySQL数据库中。代码示例展示了数据库连接、数据去重检查及插入逻辑,供初学者参考学习。
本文详解如何使用 Python 和 Selenium 库自动化抓取网易云音乐公开歌单列表。重点讲解如何定位 iframe 框架、处理页面延迟加载以及通过判断按钮状态实现自动翻页,最终完整获取多页歌单名称数据。
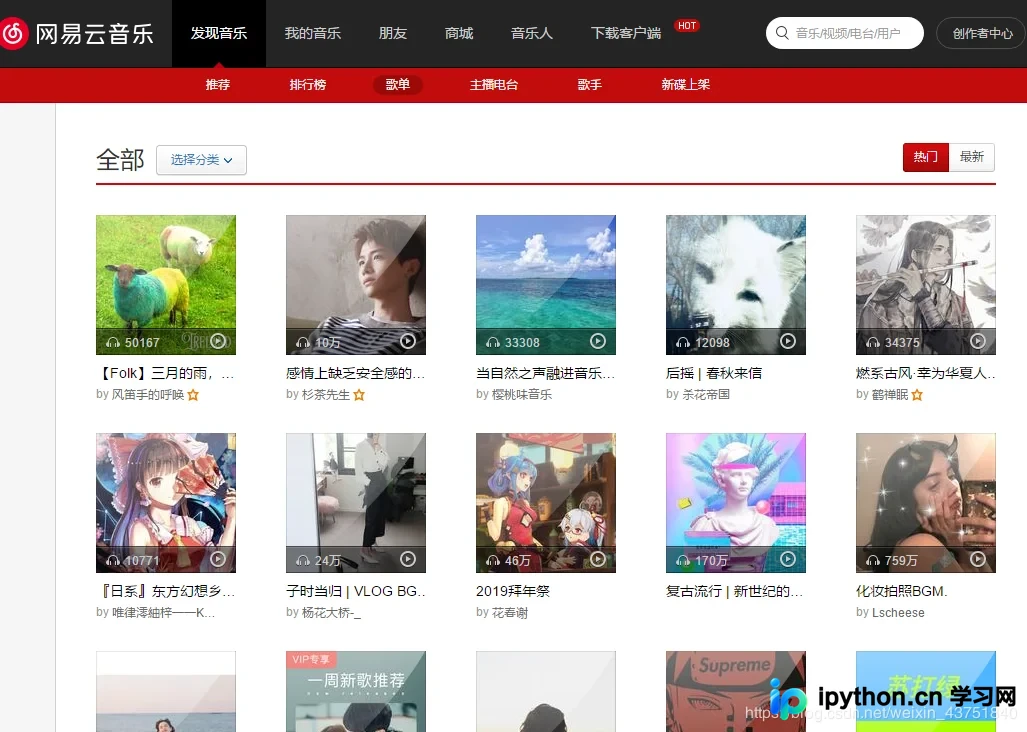
本文详解如何利用Scrapy框架结合Twisted的ADBAPI实现MySQL数据库的异步写入。通过对比同步操作的局限性,阐述了在高并发爬虫场景下使用异步机制避免数据库崩溃的必要性。文章提供了从Item解析、Pipeline配置到Settings设置的完整代码示例,展示如何高效处理大量数据入库。
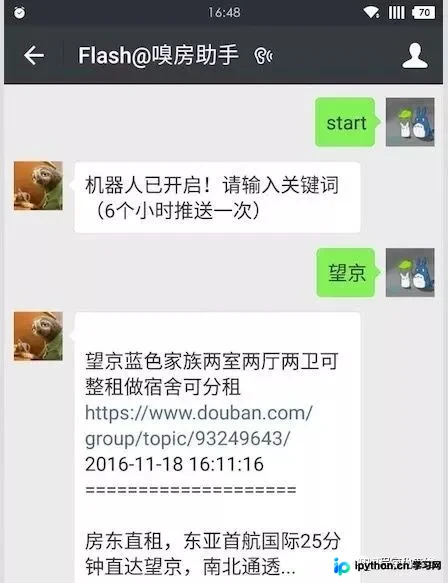
本文详细介绍如何利用Python、Scrapy爬虫框架及Whoosh搜索引擎构建一个自动抓取豆瓣租房信息并推送到微信的机器人。通过jieba分词与索引生成API,结合wxBot接口实现定时推送与持久化存储,帮助租房者高效获取实时房源。
本文针对Python3爬虫中常见的编码错误,深入解析Unicode与bytes的转换机制。详细说明了字符串encode与bytes decode的区别,以及在不同文件写入模式('w'与'wb')下如何正确处理编码参数。通过网页抓取实例,展示了如何避免TypeError和UnicodeEncodeError,确保数据正确存储。
本文探讨 Python 作为热门编程语言的多种变现途径。内容涵盖教育培训、网络爬虫数据采集、大数据分析处理、Web 网页开发以及跨语言软件集成开发等六大核心领域。旨在为学习者提供清晰的职业规划参考,解析不同技术方向的实际应用价值与市场需求。