

Python使用re.match()提取网页数据实战详解
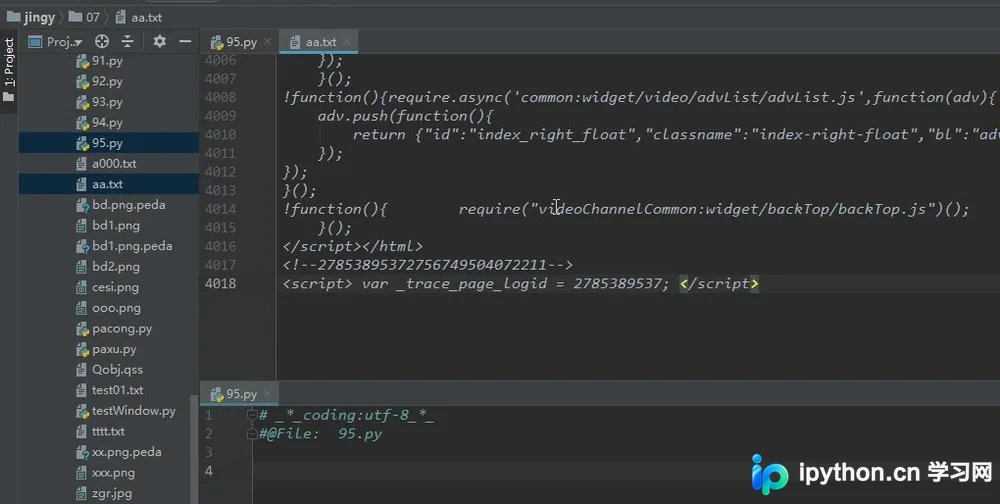
本文详解Python中re模块的match()函数,通过百度视频网页源码实例,演示如何编写正则表达式提取电影名称与链接。涵盖文件读取、逐行匹配、分组提取及代码封装,帮助开发者掌握基础爬虫数据抓取技巧。
2026-10-13
6

本文详解Python中re模块的match()函数,通过百度视频网页源码实例,演示如何编写正则表达式提取电影名称与链接。涵盖文件读取、逐行匹配、分组提取及代码封装,帮助开发者掌握基础爬虫数据抓取技巧。
本文介绍如何使用仅50行Python代码批量抓取高考志愿信息。通过结合requests-html解析网页与openpyxl处理Excel,实现从URL列表读取、网页内容提取到数据写入的全流程。文中详细讲解了处理非结构化HTML、正则表达式分割学校名称及表格切片等关键技术点,并提供了完整的错误处理与代码示例,帮助开发者快速完成数据自动化任务。
本文介绍在Python爬虫程序中验证代理IP是否成功配置的方法。通过访问httpbin.org/ip获取当前出口IP,并结合ip138.com进行比对,可确认代理是否生效。文中提供了基于requests库的完整代码示例,包含动态隧道代理的配置与IP切换头设置,帮助开发者快速排查代理连接问题。
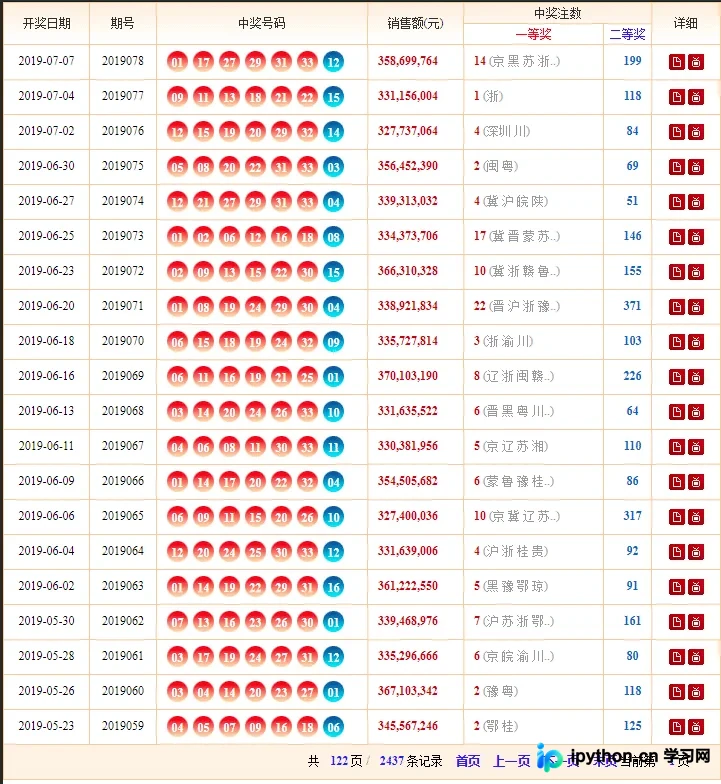
本文基于Python语言,演示如何抓取双色球历史开奖数据,并通过统计红蓝球出现频率来预测下一期号码。文章涵盖环境配置、网页解析、数据清洗及排序算法,提供完整代码示例。需注意的是,彩票具有随机性,本文方法仅基于历史数据统计,不构成中奖保证。
本文深入解析网站常用的反爬虫技术,包括User-Agent与Referer检测、JavaScript混淆与动态渲染、IP频次限制及验证码机制。针对各项防御措施,提供Python环境下的具体绕过方案,如代理池轮换、Selenium模拟浏览器、PyV8执行JS及OCR识别等实战方法,帮助开发者理解并应对常见的反爬策略。
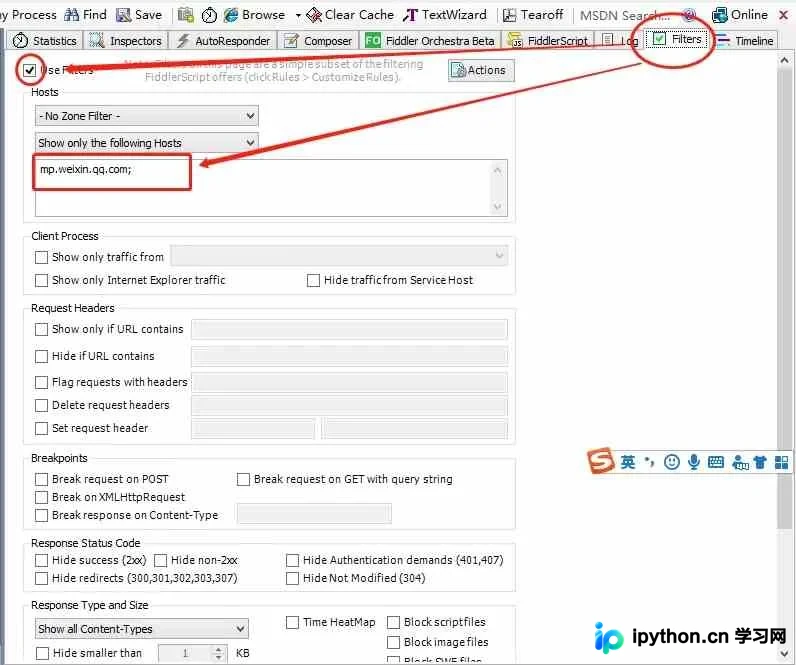
本文详细介绍如何使用Python结合Fiddler抓包工具,突破微信公众号的反爬限制,实现文章列表与评论数据的抓取。通过解析getmsg与getcomment接口参数,如__biz、pass_ticket及appmsg_token,并配合PostgreSQL数据库存储,提供完整的代码实现与数据库建表语句,帮助开发者掌握微信内容抓取的核心技术。
本文演示如何使用Python requests和BeautifulSoup库抓取有道词典网页数据,实现英汉互译功能。通过ctypes模块实现Windows控制台彩色文字输出,并利用PyInstaller将脚本打包为独立的EXE文件,方便在CMD中直接运行。
本文分享使用Python进行批量爬取和下载抖音视频的完整代码实现。通过解析用户主页获取视频列表,利用requests和re库提取关键信息,并结合asyncio与aiohttp实现异步并发下载,有效提升批量处理效率。
本文介绍如何利用Python配合Selenium库实现自动化打开Chrome浏览器进行百度关键词搜索。内容涵盖Python及Selenium的安装、chromedriver的配置、爬虫代理接口的获取,以及包含IP池管理的完整自动化搜索代码示例与运行效果。
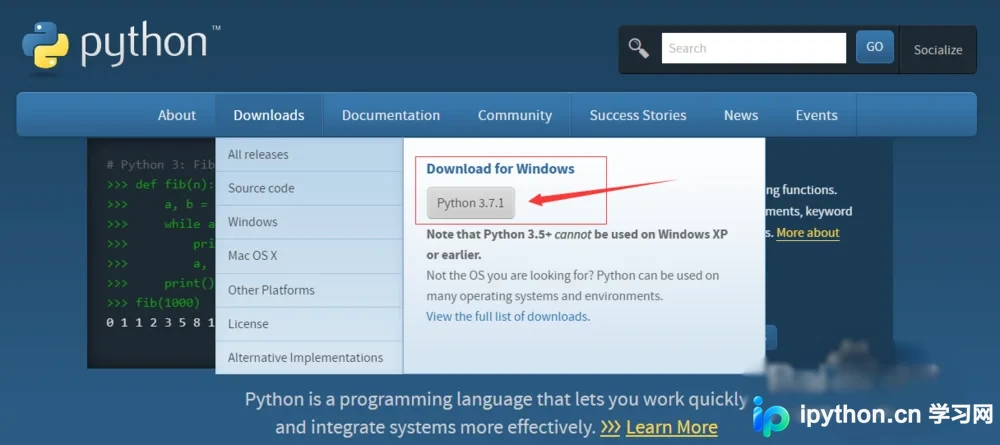
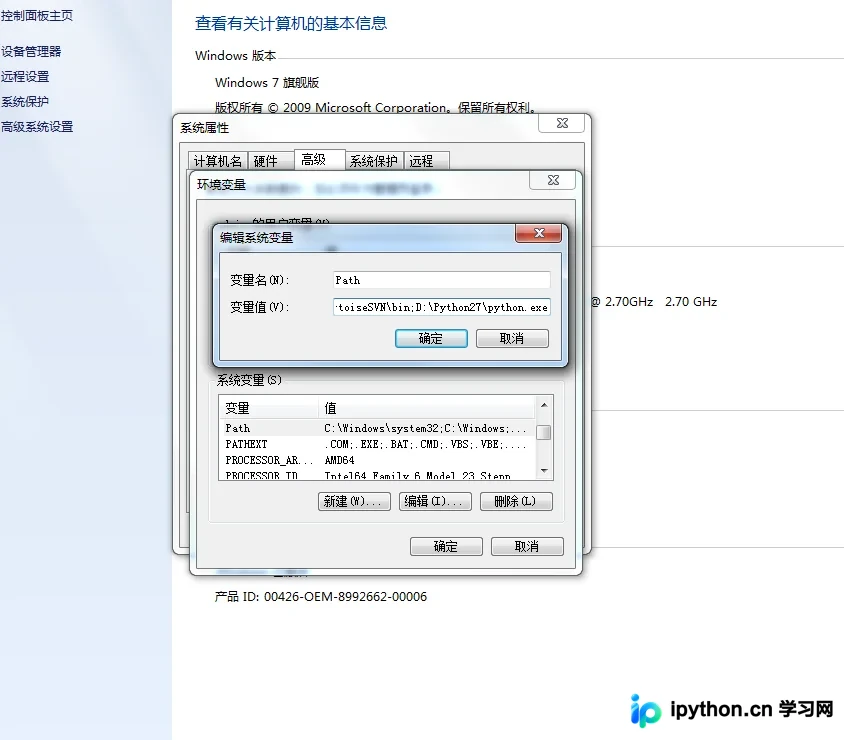
本文详细介绍在 Python 环境中安装 Scrapy 爬虫框架的完整步骤。内容涵盖 Python 环境变量配置、pywin32 组件安装、pip 工具部署以及通过命令行执行安装命令的全过程。最后提供验证 Scrapy 是否安装成功的方法,帮助开发者快速搭建爬虫开发基础环境。
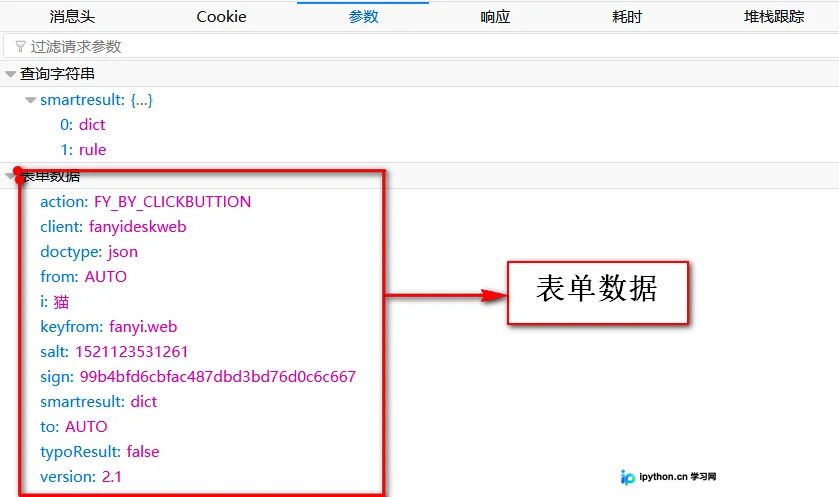
本文介绍如何利用Python标准库urllib模块,通过模拟POST请求调用有道翻译接口实现简单文本翻译。文章提供了完整的代码示例,详细解析了urllib.request.urlopen、urllib.parse.urlencode及json.loads等关键函数的用法,帮助开发者快速掌握基础的网络请求与数据处理技巧。
本文深入分析scrapy-redis框架源码,指出其默认仅支持GET请求的限制。通过重写RedisSpider中的make_request_from_data方法,结合FormRequest构造包含url、form_data和meta的POST请求,并演示如何将数据存入Redis以实现分布式POST抓取。