

Python实现E-Mail收集插件实例教程

本文详解Python爬虫插件系统的开发流程,涵盖动态调用模块、扫描目录及参数传递机制。通过修改Spider类与脚本文件,实现SQL注入检测与E-Mail收集功能,提供完整代码示例与运行结果分析,帮助开发者快速构建可扩展的安全测试工具。
__import__函数
通常我们使用import语句导入模块,但其底层实际上依赖于内置函数__import__来执行操作。在某些需要动态执行函数的场景中,若已知目标模块名称(以字符串形式表示),利用该内置函数可以非常便捷地实现动态调用。
def getfunctionbyname(module_name, function_name):
 module = __import__(module_name)
 return getattr(module, function_name)
借助上述代码示例,即可实现对特定模块函数的简单调用。
插件系统开发流程
一个完整的插件系统要正常运行,主要需执行以下几个关键步骤:
- 获取插件:通过扫描指定目录下的.py文件来识别可用插件。
- 将插件所在目录添加至系统环境变量sys.path中,确保Python能正确找到模块。
- 爬虫程序将扫描得到的URL及对应的网页源码传递给插件进行处理。
- 插件执行任务,完成后将控制权交还给扫描器继续后续工作。
插件系统代码
在lib/core/plugin.py文件中创建spiderplus类,以实现满足上述需求的代码逻辑。
# __author__ = 'mathor'

import os
import sys
class spiderplus(object):
 def __init__(self, plugin, disallow = []):
  self.dir_exploit = []
  self.disallow = ['__init__']
  self.disallow.extend(disallow)
  self.plugin = os.getcwd() + '/' + plugin
  sys.path.append(plugin)

 def list_plusg(self):
  def filter_func(file):
   if not file.endswith('.py'):
    return False
   for disfile in self.disallow:
    if disfile in file:
     return False
   return True
  dir_exploit = filter(filter_func, os.listdir(self.plugin)
  return list(dir_exploit)

 def work(self, url, html):
  for _plugin in self.list_plusg():
   try:
    m = __import__(_plugin.split('.')[0])
    spider = getattr(m, 'spider')
    p = spider()
    s = p.run(url, html)
   except Exception as e:
    print (e)
在work函数中,需要接收url和html两个参数,这正是扫描器传递给插件系统的数据。具体实现代码如下:
spider = getattr(m, 'spider')
p = spider()
s = p.run(url, html)
定义插件时,必须使用class spider中的run方法进行调用。
扫描器中调用插件
我们主要通过爬虫来调用插件。由于插件需要传递url和网页源码这两个参数,因此只需在爬虫获取到这两项数据的环节加入插件系统代码即可。
首先打开Spider.py文件,并在该文件开头添加以下导入语句:
from lib.core import plugin
然后在文件的末尾添加相应的执行代码。
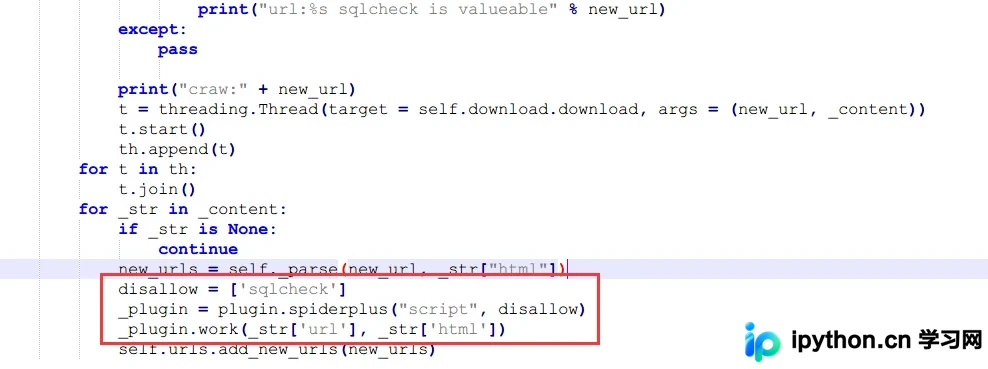
disallow = ['sqlcheck']
_plugin = plugin.spiderplus('script', disallow)
_plugin.work(_str['url'], _str['html'])
disallow变量定义了不允许运行的插件列表。为了方便测试,可以将sqlcheck填入该列表中。
SQL 注入融入插件系统
实现过程非常简单,只需将script/sqlcheck.py修改为如下内容即可:
关于Download模块,实际上它就是Downloader模块。只需将Downloader.py复制一份并命名为Download.py即可。
import re, random
from lib.core import Download

class spider:
 def run(self, url, html):
  if (not url.find("?")): # Pseudo-static page
   return false;
  Downloader = Download.Downloader()
  BOOLEAN_TESTS = (" AND %d=%d", " OR NOT (%d=%d)")
  DBMS_ERRORS = {
   # regular expressions used for DBMS recognition based on error message response
   "MySQL": (r"SQL syntax.*MySQL", r"Warning.*mysql_.*", r"valid MySQL result", r"MySqlClient\."),
   "PostgreSQL": (r"PostgreSQL.*ERROR", r"Warning.*\Wpg_.*", r"valid PostgreSQL result", r"Npgsql\."),
   "Microsoft SQL Server": (r"Driver.* SQL[\-\_\ ]*Server", r"OLE DB.* SQL Server", r"(\W|\A)SQL Server.*Driver", r"Warning.*mssql_.*", r"(\W|\A)SQL Server.*[0-9a-fA-F]{8}", r"(?s)Exception.*\WSystem\.Data\.SqlClient\.", r"(?s)Exception.*\WRoadhouse\.Cms\."),
   "Microsoft Access": (r"Microsoft Access Driver", r"JET Database Engine", r"Access Database Engine"),
   "Oracle": (r"\bORA-[0-9][0-9][0-9][0-9]", r"Oracle error", r"Oracle.*Driver", r"Warning.*\Woci_.*", r"Warning.*\Wora_.*"),
   "IBM DB2": (r"CLI Driver.*DB2", r"DB2 SQL error", r"\bdb2_\w+\("),
   "SQLite": (r"SQLite/JDBCDriver", r"SQLite.Exception", r"System.Data.SQLite.SQLiteException", r"Warning.*sqlite_.*", r"Warning.*SQLite3::", r"\[SQLITE_ERROR\]"),
   "Sybase": (r"(?i)Warning.*sybase.*", r"Sybase message", r"Sybase.*Server message.*"),
  }
  _url = url + "%29%28%22%27"
  _content = Downloader.get(_url)
  for (dbms, regex) in ((dbms, regex) for dbms in DBMS_ERRORS for regex in DBMS_ERRORS[dbms]):
   if (re.search(regex,_content)):
    return True
  content = {}
  content['origin'] = Downloader.get(_url)
  for test_payload in BOOLEAN_TESTS:
   # Right Page
   RANDINT = random.randint(1, 255)
   _url = url + test_payload % (RANDINT, RANDINT)
   content["true"] = Downloader.get(_url)
   _url = url + test_payload % (RANDINT, RANDINT + 1)
   content["false"] = Downloader.get(_url)
   if content["origin"] == content["true"] != content["false"]:
    return "sql found: %" % url
E-Mail 搜索插件
最后展示一个简单的例子:搜索网页中的E-Mail地址。由于插件系统会传递网页源码,我们可以使用正则表达式([\w-]+@[\w-]+\.[\w-]+)+来提取所有邮件地址。创建script/email_check.py文件。
# __author__ = 'mathor'
import re
class spider():
 def run(self, url, html):
  #print(html)
  pattern = re.compile(r'([\w-]+@[\w-]+\.[\w-]+)+')
  email_list = re.findall(pattern, html)
  if (email_list):
   print(email_list)
   return True
  return False
运行命令python w8ay.py。
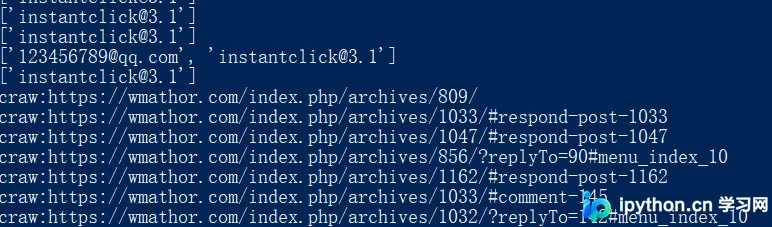
可以看到网页中的邮箱地址均已被成功采集。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,如果有疑问大家可以留言交流,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









