

Python实现微信公众号文章采集:基于搜狗微信搜索的实战代码
本文提供使用Python采集微信公众号文章的完整代码方案。通过搜狗微信搜索接口获取文章列表,利用PyQuery解析内容,并将结果存储至MongoDB。代码包含配置模块config.py及主程序采集公众号文章.py,支持关键词搜索、分页抓取及代理池配置,实测可有效运行,适合Python初学者参考学习。
2026-10-13
6

本文提供使用Python采集微信公众号文章的完整代码方案。通过搜狗微信搜索接口获取文章列表,利用PyQuery解析内容,并将结果存储至MongoDB。代码包含配置模块config.py及主程序采集公众号文章.py,支持关键词搜索、分页抓取及代理池配置,实测可有效运行,适合Python初学者参考学习。
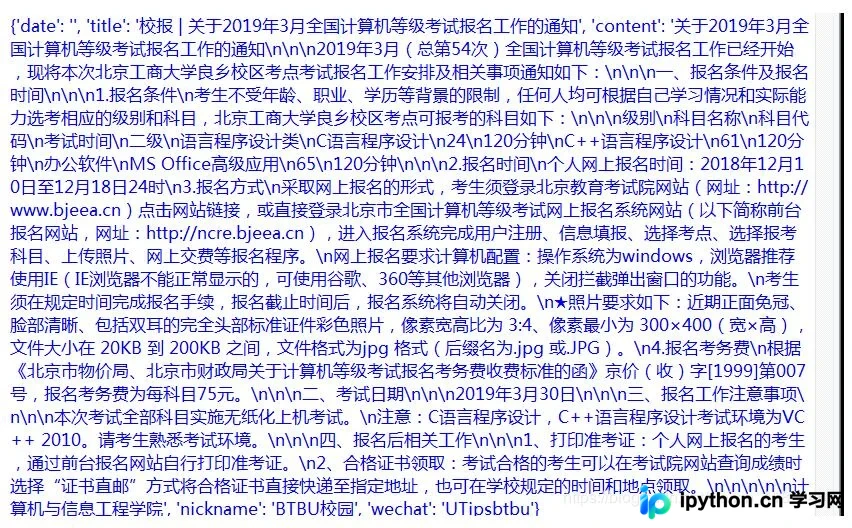
本文详细介绍Python爬虫中处理非200状态URL的重试机制。提供Python 2.7与3.5版本的同步requests实现及异步aiohttp方案,并封装可复用的重试装饰器。代码涵盖错误捕获、递归重试逻辑及异常处理,适用于需要提高爬虫稳定性的场景。
本文介绍在Python3中如何利用urllib请求网页数据,并结合BeautifulSoup库解析HTML内容。通过具体代码示例,演示如何获取标题、类名、ID等属性值,以及使用select方法按标签、类名或ID进行精准查找,为网页数据抓取提供实用参考。
本文介绍如何在Scrapy中集成PhantomJS以实现异步AJ数据爬取。通过重写Downloader并引入Semaphore控制并发,解决传统同步集成的性能瓶颈。代码展示了如何配置PhantomJSDownloadHandler,利用线程池和队列管理浏览器实例,从而在保持Scrapy高效并发能力的同时,处理需要JavaScript渲染的网页内容。
本文分享一段Python爬取链家租房信息的完整代码,涵盖从网页请求、数据解析到数据库存储的全流程。通过封装获取列表页链接与详情页信息的函数,结合SQL Server数据库操作,实现自动化数据采集。代码包含关键逻辑说明及错误处理思路,适合Python初学者参考学习。
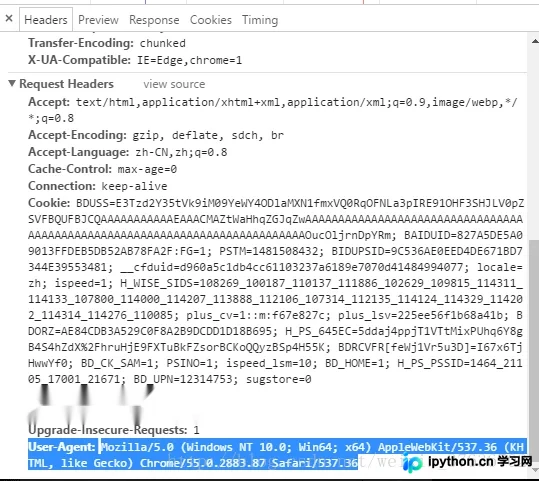
本文详解Python3中利用urllib模块应对网站反爬虫策略的方法。通过构造Request对象并添加包含User-Agent的headers字典,可模拟浏览器访问行为,有效绕过基于请求头鉴别的反爬检测。文中提供了完整的代码示例及API说明,帮助开发者实现更稳定的数据采集。
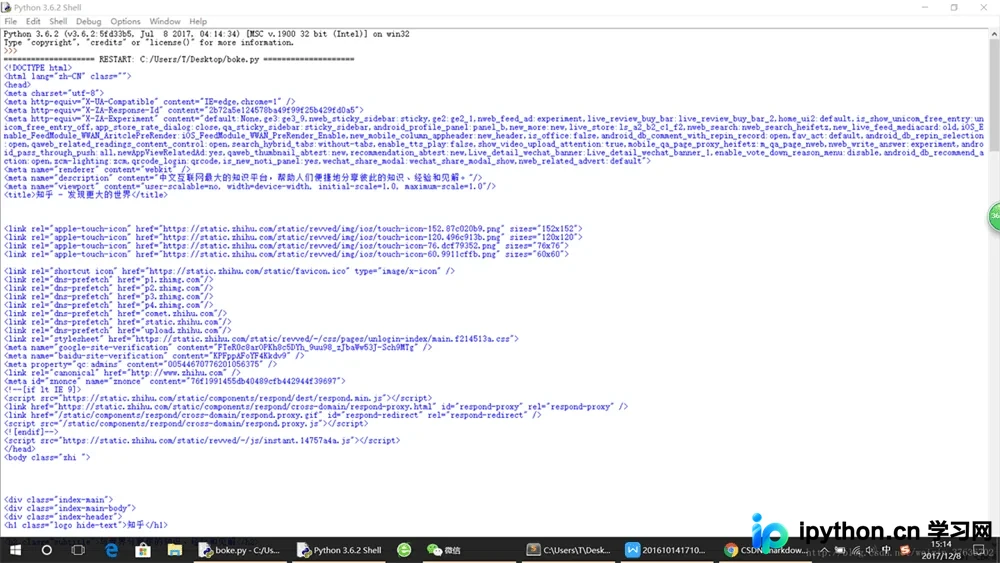
本文针对Python3环境提供爬虫入门指南,对比Python2差异,推荐边学边做。通过抓取知乎首页源码演示urllib.request.urlopen()用法,解析HTML并处理编码,介绍爬虫流程及数据提取存储方法,帮助初学者快速上手。
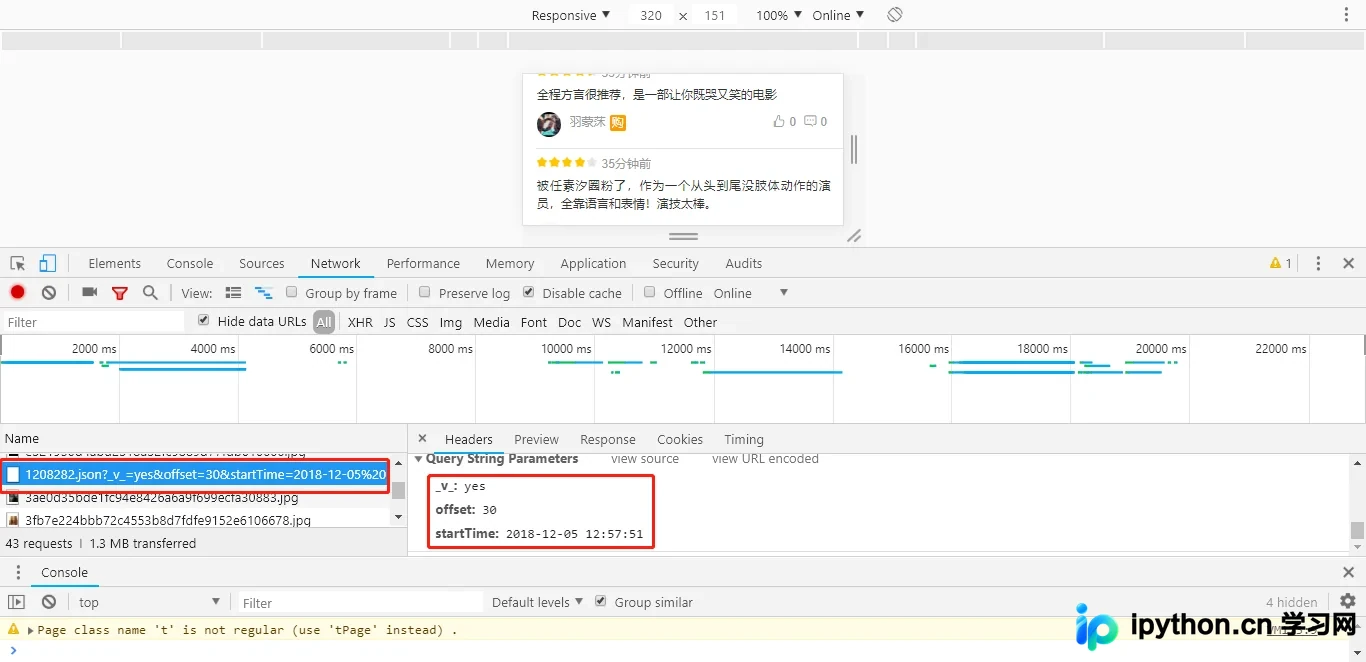
本文详细介绍使用Python采集猫眼电影《无名之辈》近两万条用户评论的全过程。通过移动端接口获取数据,利用jieba进行分词,结合pyecharts和matplotlib制作观众城市分布热点图、TOP20来源柱状图及评论词云。文中还包含对pyecharts源码的修改以解决城市简称匹配问题,提供完整代码供学习参考。
本文详细介绍如何使用Python3结合Requests和BeautifulSoup模块爬取赶集网列表数据。文章涵盖环境配置、模块安装及核心代码实现,通过构造请求头模拟浏览器访问,解析HTML并提取标题信息,帮助开发者快速掌握基础爬虫技巧。
本文介绍在Python中为数字字符串左侧补零的两种实用方法。第一种通过设定足够大的基数进行加法运算后截取指定子串;第二种通过计算当前字符串长度与预期长度的差值,动态生成前导零。这两种方法均可有效解决URL中日期格式需补零的问题,适用于新闻爬虫等场景。
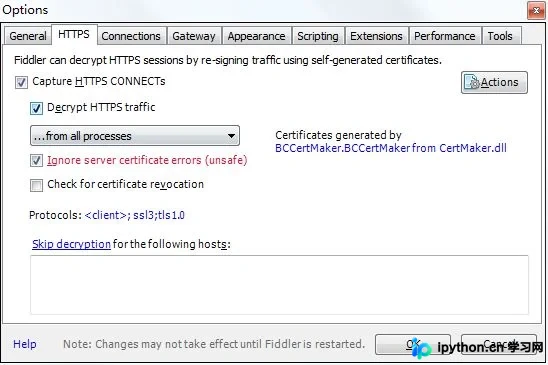
本文详细讲解如何使用Python3配合Fiddler工具抓取手机APP接口数据。内容涵盖Fiddler安装配置、手机代理设置、证书信任及抓包测试,并以王者荣耀盒子APP为例,演示如何解析英雄与装备接口数据,最终提供完整的Python爬取代码供参考。
本文介绍如何利用Python编写脚本爬取淘宝商品销量信息。通过指定关键词和分页参数,程序可自动获取商品列表并计算总销量。支持在代码中通过特定标记约束作者、时期等属性,适用于电商数据分析场景。