

Python3爬虫实战:知乎热门话题数据抓取与TXT存储详解

本文详解使用Python3的Requests库和正则表达式爬取知乎热门话题的方法。重点解决作者匿名导致的数量偏差、标题与内容不匹配等问题,并通过正则处理HTML标签。最后演示如何将抓取到的标题、作者及内容完整保存至本地TXT文件,附带文件打开模式说明。
Python3爬虫实战:知乎热门话题数据抓取与TXT存储详解
上一篇实战中,我们完成了知乎热门话题的爬取,并将结果保存为本地TXT文本文件。
接下来展示具体代码实现。在编写过程中需要注意许多细节和潜在陷阱,整个过程耗时约两个半小时才调试完成。
核心代码实现与请求头设置
import requests
import re

headers = {
 "user-agent" : "Mozilla/5.0 (Windows NT 6.1; Win64; x64)"
   " AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari"
   "/537.36M",
 "cookie" : '_xsrf=H6hRg3qQ9I1O8jRZOmf4ytecfaKdf2es; _zap=296584df-ce11-4059-bc93-be10eda0fdc1; d_c0="AKBmB5e-PA-PTkZTAD1nQun0qMf_hmcEH14=|1554554531"; '
  'capsion_ticket="2|1:0|10:1554554531|14:capsion_ticket|44:Yjc0NjAzNDViMTIzNDcyZDg2YTZjYTk0YWM3OGUzZDg=|2d7f136328b50cdeaa85e2605e0be2bb931d406babd396373d15d5f8a6c'
  '92a61"; l_n_c=1; q_c1=ad0738b5ee294fc3bd35e1ccb9e62a11|1554554551000|1554554551000; n_c=1; __gads=ID=9a31896e052116c4:T=1554555023:S=ALNI_Mb-I0et9W'
  'vgfQcvMUyll7Byc0XpWA; tgw_l7_route=116a747939468d99065d12a386ab1c5f; l_cap_id="OGEyOTkzMzE2YmU3NDVmYThlMmQ4OTBkMzNjODE4N2Y=|1554558219|a351d6740bd01ba8ee34'
  '94da0bd8b697b20aa5f0"; r_cap_id="MDIzNThmZjRhNjNlNGQ1OWFjM2NmODIxNzNjZWY2ZjY=|1554558219|ff86cb2f7d3c6e4a4e2b1286bbe0c093695bfa1d"; cap_id="MGNkY2RiZTg5N2MzNDUyNTk0NmEzMTYyYzgwY'
  'zdhYTE=|1554558219|18ed852d4506efb2345b1dbe14c749b2f9104d54"; __utma=51854390.789428312.1554558223.1554558223.1554558223.1; __utmb=51854390.0.10.1554558223; __utmc=51854390; '
  '__utmz=51854390.1554558223.1.1.utmcsr=(direct'
  ')|utmccn=(direct)|utmcmd=(none); __utmv=51854390.000--|3=entry_date=20190406=1',
 "authority" : "www.zhihu.com",

}
url = "https://www.zhihu.com/explore"
response = requests.get(url=url , headers=headers)
text = response.text
# print(text)
titles = []
f_titles = re.findall(r'<div class="explore-feed feed-item".*?>.*?<a class="question_link".*?>(.*?)</a>.*?</h2>',text,re.S)
for title in f_titles:
 titles.append(title.strip())
# print("*"*30)
authors = []
f_authors = re.findall(r'<div class="zm-item-answer-author-info".*?>(.*?)</span>',text,re.S)[1:]
for f_author in f_authors:
 # print(f_author)
 author = re.sub(r'<.*?>|<a ([^>]*?)>' , "" , f_author,re.S).strip()
 authors.append(author)
# print("*"*30)
content_urls = re.findall(r'<div class="zh-summary summary clearfix">.*?<a href="(.*?)" rel="external nofollow" rel="external nofollow" .*?>.*?</a>',text,re.S)[1:]
contents = []
for content_url in content_urls:
 content_full_url = "https://www.zhihu.com" + content_url
 # print(content_full_url)
 resp = requests.get(url=content_full_url , headers=headers)
 c_text = resp.text
 content = re.findall(r'<div class="RichContent-inner">*?<span .*?>(.*?)</span>',c_text,re.S)
 content = str(content)
 # print(type(content))
 cont = re.sub(r'\\n|<.*?>',"",content).strip()
 # print(cont)
 contents.append(cont)

zhihu_questions = []
for value in zip(titles,authors,contents):
 title,author,content = value
 zhihu_question = {
 "标题" : title,
 "作者" : author,
 "内容" : content
 }
 zhihu_questions.append(zhihu_question)

# for zhihu_question in zhihu_questions:
# for value in zhihu_question.values():
#  print(value)
# print("=" * 50)

with open("知乎.txt" , "a" , encoding="utf-8") as fp:
 for zhihu_question in zhihu_questions:
 for value in zhihu_question.values():
  fp.write(value)
  fp.write('\n' + "="*10 + '\n')
 fp.write('\n' + "*"*50 + '\n')
本次爬取主要依赖requests库进行HTTP请求,并结合正则表达式解析HTML内容。
由于需要反复测试爬取内容的准确性,高频请求可能导致账号被封禁。博主曾因此被封号一次,随后通过修改Cookie等信息重新获取了访问权限,最终成功获取到所需内容。
正则表达式的应用在前文已有介绍并经过实战验证,此处不再赘述基础语法,重点讨论爬取过程中遇到的具体问题和解决方案。
在爬取标题环节较为顺利,主要操作是去除字符串中的空白字符即可。
爬取难点:作者信息获取异常分析
然而,在爬取作者信息时遇到了问题。热门话题共有10篇,即对应10个作者,但使用正则表达式获取时,结果要么第一个作者信息错误,要么只获取到9个作者。为了排查问题,博主将所有热门话题的URL、标题、作者和内容打印出来,并在浏览器中逐一核对标题、作者与内容的对应关系,发现了一个特殊现象。
问题一:作者数量统计不正确。
知乎平台存在匿名作者,这些匿名作者与实名作者同处于一个div标签下。区别在于,匿名作者的信息包裹在span标签内,而实名作者的信息位于a标签下。此前直接使用正则匹配a标签内容,导致无法获取匿名用户,从而造成作者数量缺失。解决方案是直接获取div下的所有内容,然后使用sub函数去除不需要的部分。
问题二:作者信息与标题或内容不匹配。
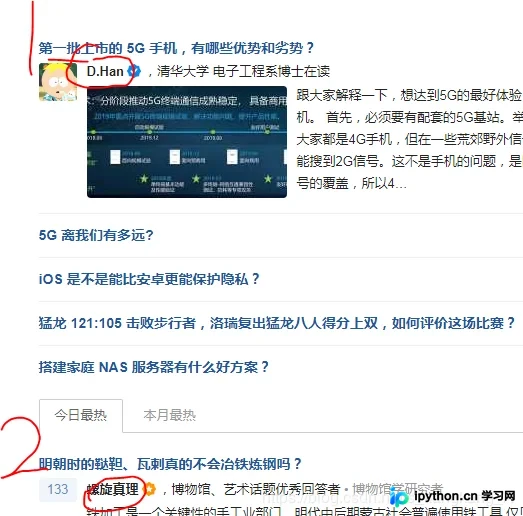
列表中的第一个元素并非我们需要的热门话题作者,而是系统默认或无关的作者,真正的第一个热门话题作者位于列表的第二个位置(索引1)。
此外,由于未获取匿名用户,导致数据缺失。
上述两个因素是导致无法正常获取准确数据的原因。
针对上述两个问题,采取以下解决策略:
解决方案:处理匿名作者与标签清理
f_authors = re.findall(r'<div class="zm-item-answer-author-info".*?>(.*?)</span>',text,re.S)[1:]
for f_author in f_authors:
 # print(f_author)
 author = re.sub(r'<.*?>|<a ([^>]*?)>' , "" , f_author,re.S).strip()
 authors.append(author)
首先获取所有未经处理的作者信息列表。由于第一个元素并非热门话题的回答者,我们需要将其排除。变量f_authors是一个包含大量HTML标签的列表,建议打印查看其具体内容。
遍历这个未经处理的列表,打印出原始作者名,以便分析需要处理的具体内容。
分析发现原始数据中包含大量span标签和a标签,我们使用sub函数进行清理处理。
问题三:部分抓取内容字符串过长,格式异常。
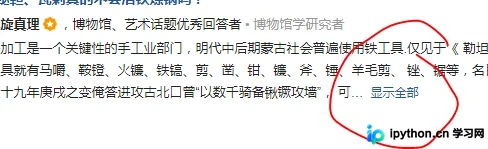
直接获取的内容格式不正常。通过分析,可以找到该话题对应的链接,拼接上域名即可跳转至话题详情页。
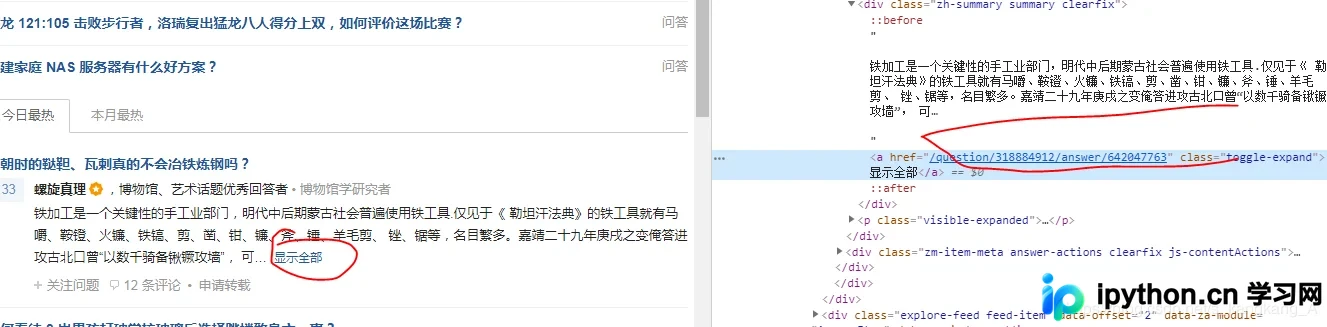
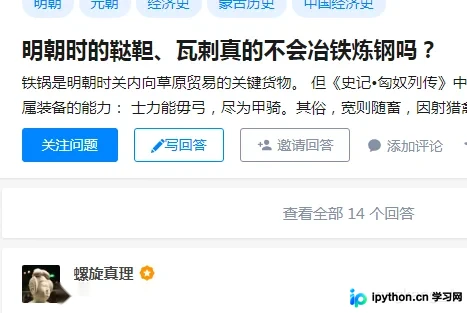
具体步骤为:获取URL,处理页面请求,提取内容,最后去除HTML标签等无关字符,得到纯净文本。
内容提取与详情页跳转处理
content_urls = re.findall(r'<div class="zh-summary summary clearfix">.*?<a href="(.*?)" rel="external nofollow" rel="external nofollow" .*?>.*?</a>',text,re.S)[1:]
contents = []
for content_url in content_urls:
 content_full_url = "https://www.zhihu.com" + content_url
 # print(content_full_url)
 resp = requests.get(url=content_full_url , headers=headers)
 c_text = resp.text
 content = re.findall(r'<div class="RichContent-inner">*?<span .*?>(.*?)</span>',c_text,re.S)
 content = str(content)
 # print(type(content))
 cont = re.sub(r'\\n|<.*?>',"",content).strip()
 # print(cont)
 contents.append(cont)
关于zip函数的使用,在上一篇爬取古诗文的案例中也曾提及,这是一个非常重要的内置函数。
数据整合与TXT文件保存
zhihu_questions = []
for value in zip(titles,authors,contents):
 title,author,content = value
 zhihu_question = {
 "标题" : title,
 "作者" : author,
 "内容" : content
 }
 zhihu_questions.append(zhihu_question)
最后一步是将获取到的所有数据保存为本地TXT文档。
with open("知乎.txt" , "a" , encoding="utf-8") as fp:
 for zhihu_question in zhihu_questions:
 for value in zhihu_question.values():
  fp.write(value)
  fp.write('\n' + "="*10 + '\n')
 fp.write('\n' + "*"*50 + '\n')
这是保存爬取内容的最基本方法。后续博客将继续介绍JSON、CSV格式以及数据库存储的相关实现。
运行结果如下所示:
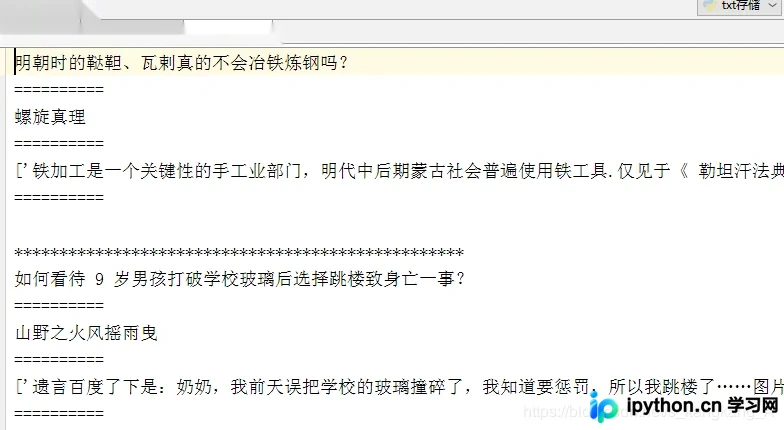
另外,注释掉的代码均为测试代码,供参考使用。
补充说明:在运行代码时,注意Cookie信息可能会过期,需及时更新。
附录:Python文件打开模式详解
补充知识:文件打开的几种常见模式。
1:r:只读模式,也是默认打开模式。
2:rb:二进制只读模式。
3:r+:读写模式。
4:rb+:二进制读写模式。
5:w:写入模式(覆盖原有内容)。
6:wb:二进制写入模式。
7:w+:读写模式(覆盖原有内容)。
8:wb+:二进制读写模式。
9:a:追加模式,此方式不会覆盖原有内容,本篇代码采用此方式打开文件。
10:ab:二进制追加模式。
11:a+:读写模式(追加)。
12:ab+:二进制读写模式(追加)。
以上介绍了Python3爬虫学习之数据存储TXT的案例详解,希望对大家有所帮助。如有疑问请留言,小编会及时回复。感谢大家对本站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









