Python爬虫实现GitHub模拟登录并提取数据
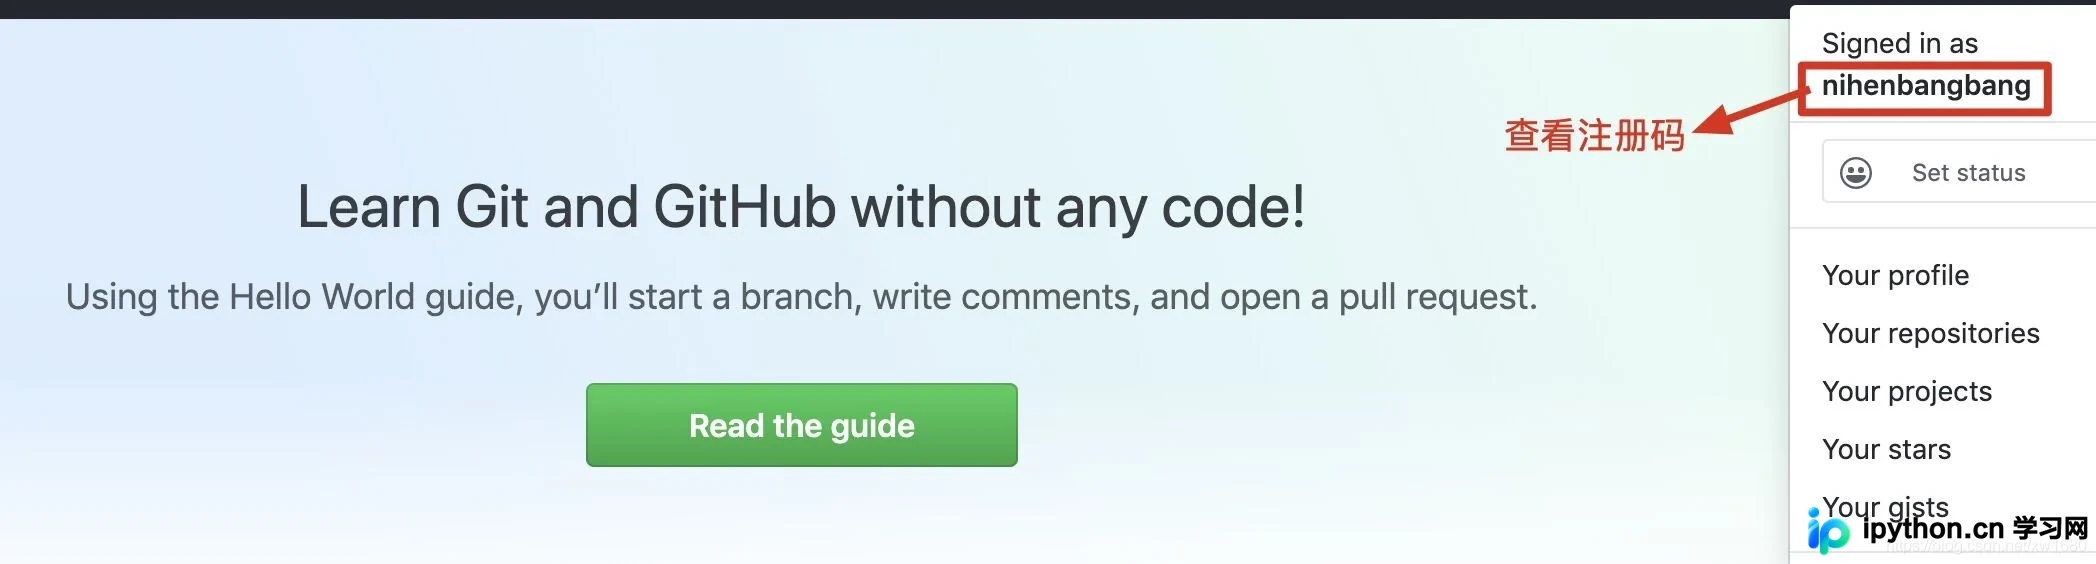
本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。
2026-10-14
6

本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。
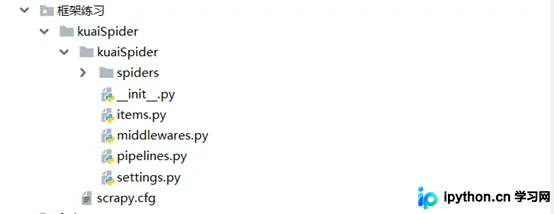
本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。
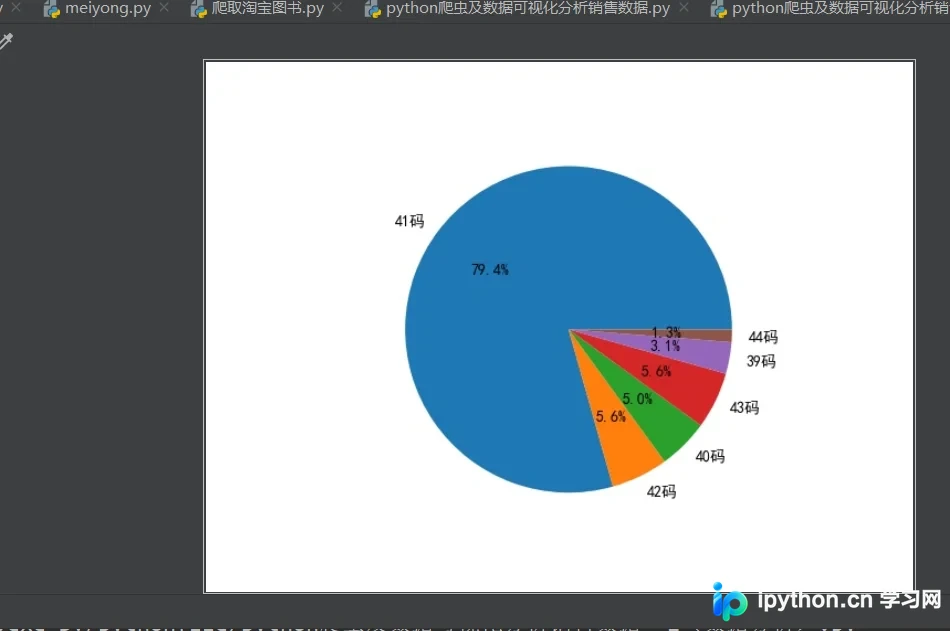
本文介绍使用Python爬取京东商品评论的完整流程。通过requests库获取动态数据,利用openpyxl将清洗后的评论信息保存至Excel文件。随后读取Excel数据,统计商品尺码分布,并使用Matplotlib生成饼图进行可视化展示,帮助理解销售数据特征。
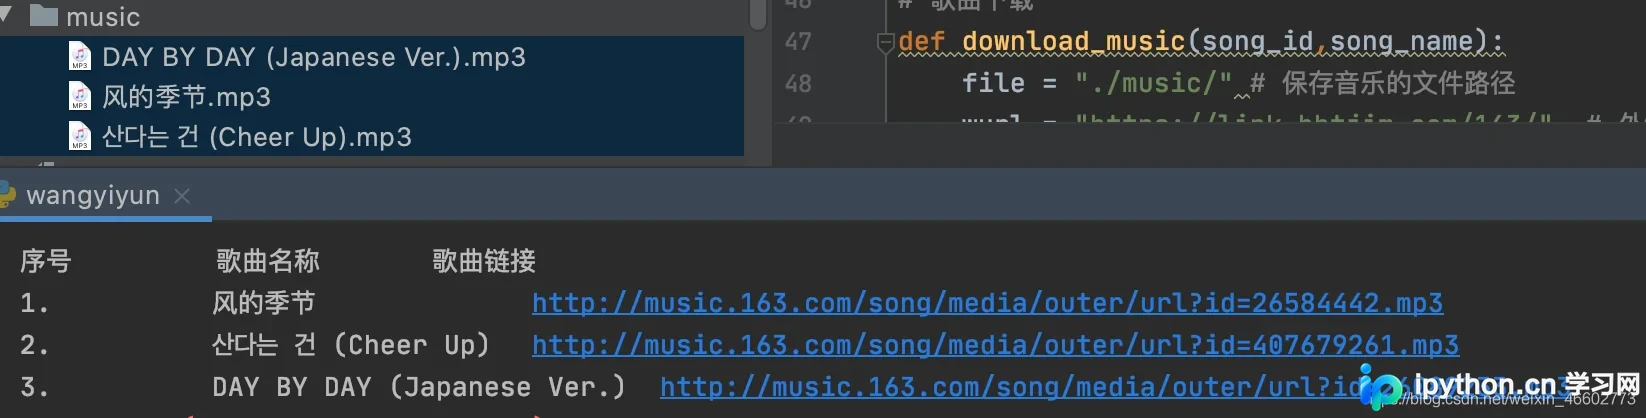
本文提供使用Python批量下载网易云音乐歌单中歌曲的完整示例代码。通过解析歌单链接获取歌曲ID与名称,并利用第三方接口转换音频链接进行下载。文中详细说明了Cookie的获取方法、代码逻辑结构及保存路径配置,帮助用户快速实现本地音乐文件的自动化下载。
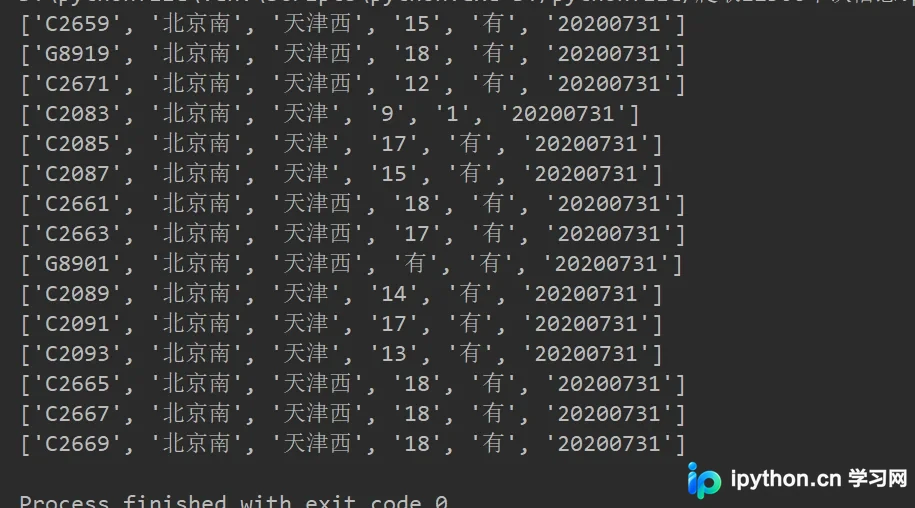
本文详解使用Python抓取12306车次信息的完整流程。重点解决动态加载数据的定位问题,通过配置User-Agent和Cookie规避反爬机制,处理UTF-8编码乱码,并解析JSON数据提取有效车次。包含代码实现、站点字典转换及运行结果展示,适合Python初学者参考。
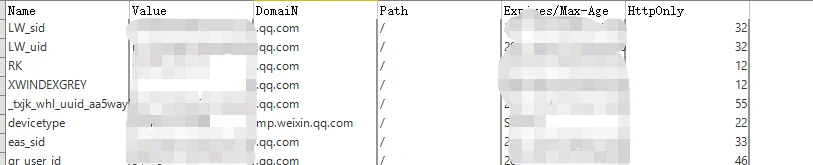
本文介绍使用 Python Selenium 批量抓取微信公众号历史文章的方法。通过注入 Cookie 保持登录状态,利用 JavaScript 控制滚动加载至底部以获取所有链接,并解析 HTML 提取标题、日期及原创标识,最终将结果保存为 Excel 文件。
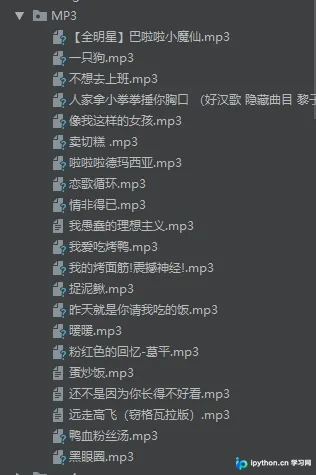
本文介绍如何使用Python的requests和BeautifulSoup库,从网易云音乐指定歌单页面解析歌曲链接与名称,并批量下载MP3文件至本地。代码包含请求头设置、DOM解析及文件保存逻辑,适用于学习网络爬虫基础与文件处理。
本文详细演示了如何使用Python编写爬虫程序,通过正则表达式和BeautifulSoup解析豆瓣电影Top250网页。文章涵盖了从构建请求头、提取电影链接与名称,到将数据保存为Excel文件和SQLite数据库的完整流程。代码包含完整的函数封装,适合初学者学习网络数据采集与本地存储技术。
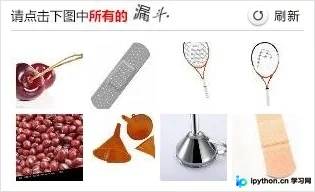
本文详解如何使用Python3结合Selenium与超级鹰API识别点触验证码。针对OCR技术处理变形文字和复杂背景效果不佳的问题,介绍通过在线打码平台获取坐标的方案。内容涵盖账号注册、API封装、图片截取、坐标解析及模拟点击全流程,适用于12306等常见点触场景。
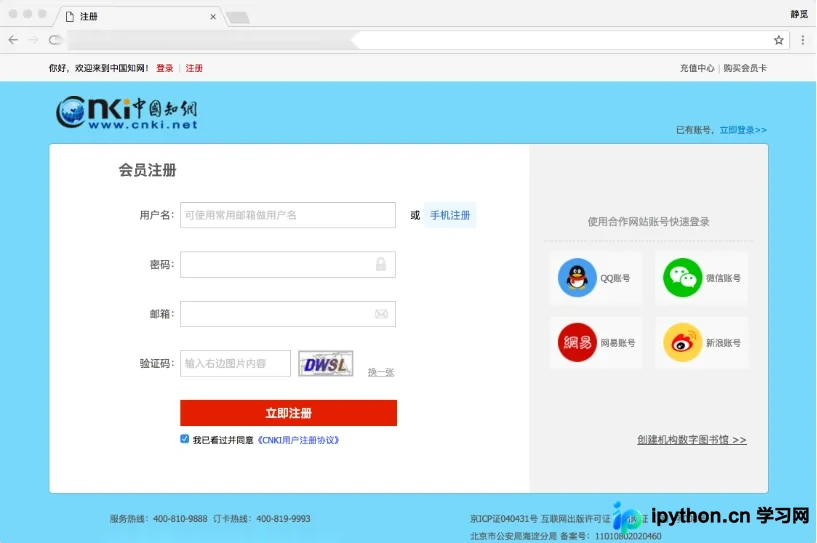
本文详细讲解在Python3爬虫中如何使用Tesserocr库识别简单的图形验证码。内容涵盖从获取验证码图片、直接调用OCR接口,到通过灰度转换和二值化处理去除干扰线条以提高识别准确率的全过程。结合知网注册页面实例,提供完整的代码示例与参数设置说明,帮助开发者解决验证码识别难题。
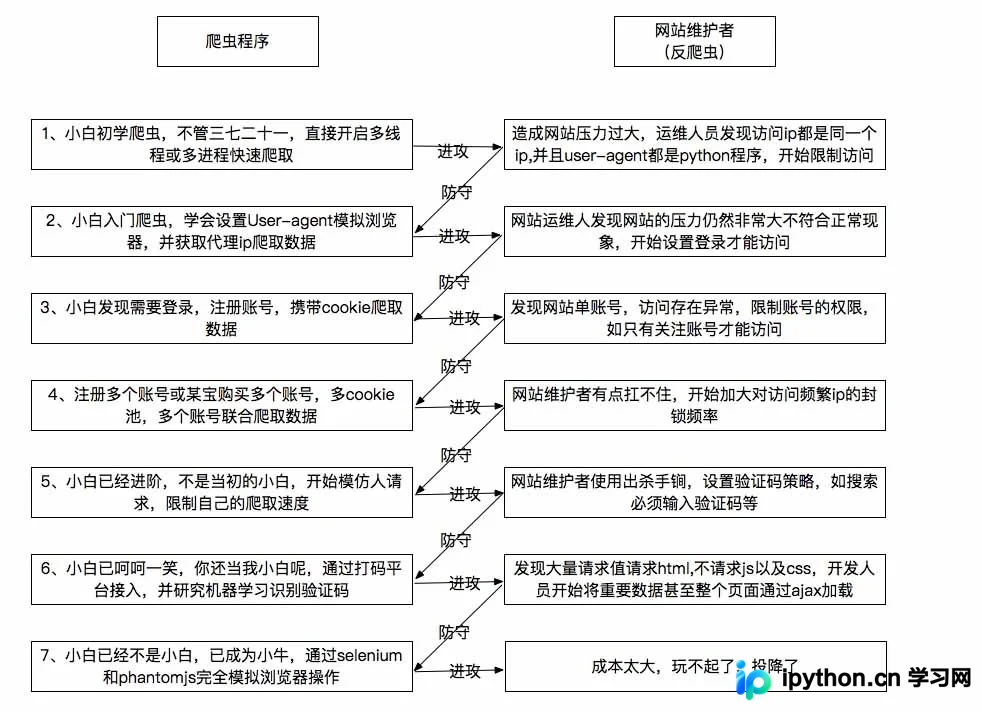
本文深入解析Python爬虫与反爬虫的对抗机制,涵盖自动获取数据原理、常见反爬策略如IP封禁的成本与误伤风险,以及数据保护与商业竞争背景下的防御目的。通过梳理实战中的攻防策略,帮助开发者理解如何在获取数据与防止滥用之间取得平衡,适用于Python及相关技术栈的开发者参考。
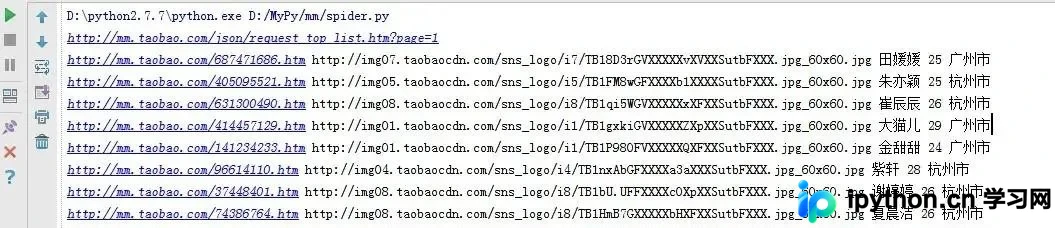
本文详解使用Python编写爬虫抓取淘宝MM首页信息的完整流程。通过解析HTML获取头像、姓名、年龄及详情页链接,利用正则表达式提取数据,并演示如何将图片与个人简介按文件夹保存至本地。代码涵盖页面请求、数据提取、文件创建及写入逻辑,适合Python初学者学习网络爬虫基础操作。