Python网页解析器入门:从正则到BeautifulSoup实战
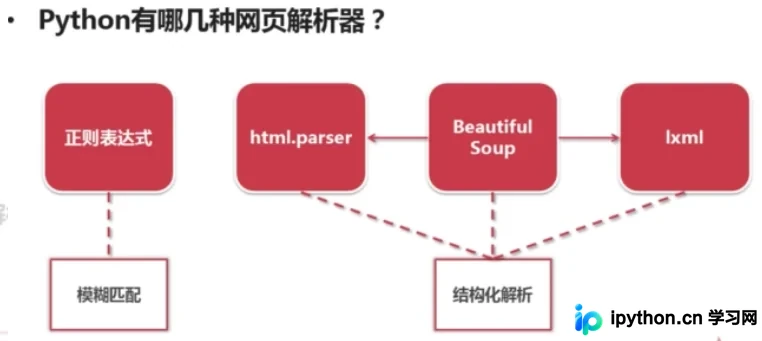
本文详解Python中常见的网页解析工具,包括正则表达式、html.parser、BeautifulSoup及lxml。重点介绍基于DOM树的结构化解析原理,并通过urllib与requests库结合BeautifulSoup的完整代码示例,展示如何获取和解析网页内容,帮助开发者快速掌握网页数据提取的核心方法。
2026-10-13
6

本文详解Python中常见的网页解析工具,包括正则表达式、html.parser、BeautifulSoup及lxml。重点介绍基于DOM树的结构化解析原理,并通过urllib与requests库结合BeautifulSoup的完整代码示例,展示如何获取和解析网页内容,帮助开发者快速掌握网页数据提取的核心方法。
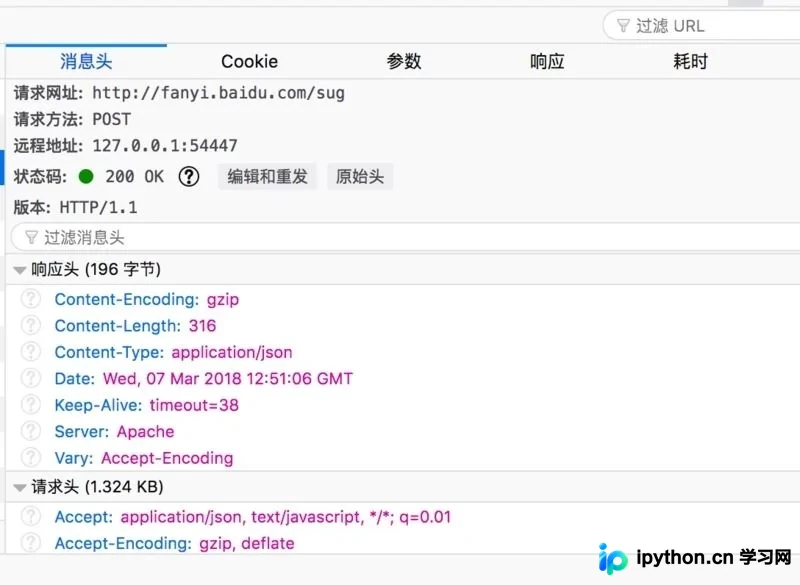
本文详解如何使用Python编写爬虫程序调用百度翻译接口。通过F12开发者工具分析网络请求,获取fanyi.baidu.com/sug接口及POST参数kw。结合urllib库构造请求头与数据,实现输入内容并输出翻译结果的核心功能,适合初学者快速上手网络爬虫开发。
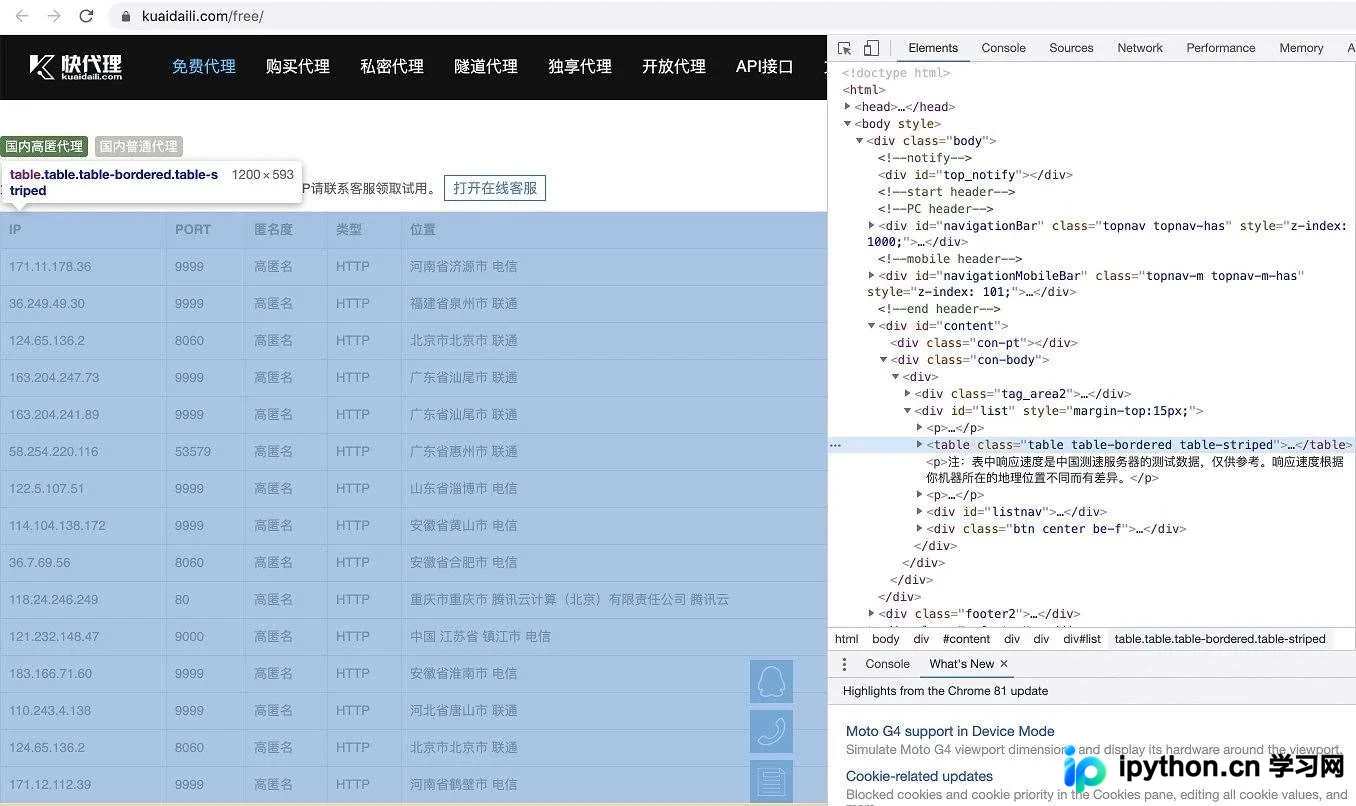
本文介绍如何使用Python的pandas库通过一行代码高效抓取网页表格数据。相比传统结合requests和bs4的复杂解析方式,pd.read_html()能直接处理URL并返回DataFrame对象。文章详细演示了从抓取代理IP网站表格到保存为CSV文件的完整流程,并解析了read_html函数的常用参数及返回值处理技巧,帮助开发者简化数据采集工作。
本文深入解析Python内置库urllib.request,涵盖其核心模块功能及常用方法。通过读取内容、获取URL、状态码及HTTP头信息等案例,演示如何模拟浏览器发起HTTP请求,并展示文件保存与图片下载的完整代码实现,适合Python初学者快速掌握网络数据抓取基础。
本文详细解析Python中urllib.request与requests库的使用方法及核心差异。通过对比urlopen()与Request类的构建方式,以及requests库对GET/POST请求的便捷封装,帮助开发者理解为何在实际开发中更推荐使用requests。内容涵盖Headers添加、响应数据处理及代码示例,适合Python爬虫初学者参考。
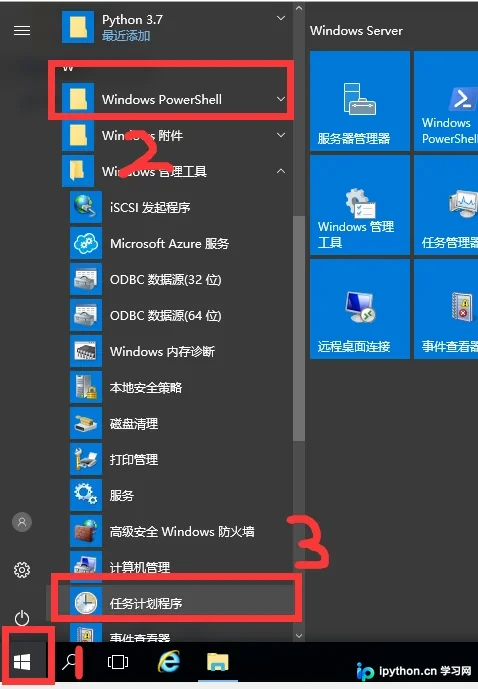
本文详细介绍如何在Windows系统中利用任务计划程序和批处理脚本实现Python程序的定时自动运行。通过创建包含启动命令的.bat文件,并配置任务计划程序的触发器、操作及参数,可轻松实现Python脚本的无人值守执行。适用于Windows 10及Server 2016等版本,确保爬虫或后台任务按设定频率稳定运行。
本文解析Python爬虫中Request Payload与Form Data在Content-Type上的核心差异,指出Scrapy的FormRequest仅支持Form Data。针对Request Payload场景,提供通过Jsoup发送JSON字符串或Map参数的具体代码实现,并强调动态获取变化参数的重要性,帮助开发者解决POST请求参数传递问题。
本文介绍如何在Django项目中通过Scrapyd服务实现爬虫的可视化管理。涵盖创建Django与Scrapy项目、部署爬虫、通过API启动/停止任务及查看状态等完整流程,并提供关键代码示例与接口说明。
本文解析如何利用Selenium控制Chrome浏览器模拟移动端环境。通过ChromeOptions配置mobileEmulation,可调用预设设备名称(如iPhone X)或自定义设备指标(宽度、高度、像素比及User-Agent)。该方法适用于H5页面兼容性测试及降低移动端反爬策略影响,提供完整代码示例与参数说明。
本文介绍使用Python爬取手机号前7位归属地的实现方案。通过对比单线程与多线程版本,展示从耗时1个半小时到2-3分钟的优化过程。单线程处理10000次查询需约90分钟,而多线程(32线程)处理1000条数据仅需2-3分钟,CPU占用约70%。最终40多个号段、41万条数据的爬取总耗时约1-2小时,提供了完整的代码示例与性能数据。
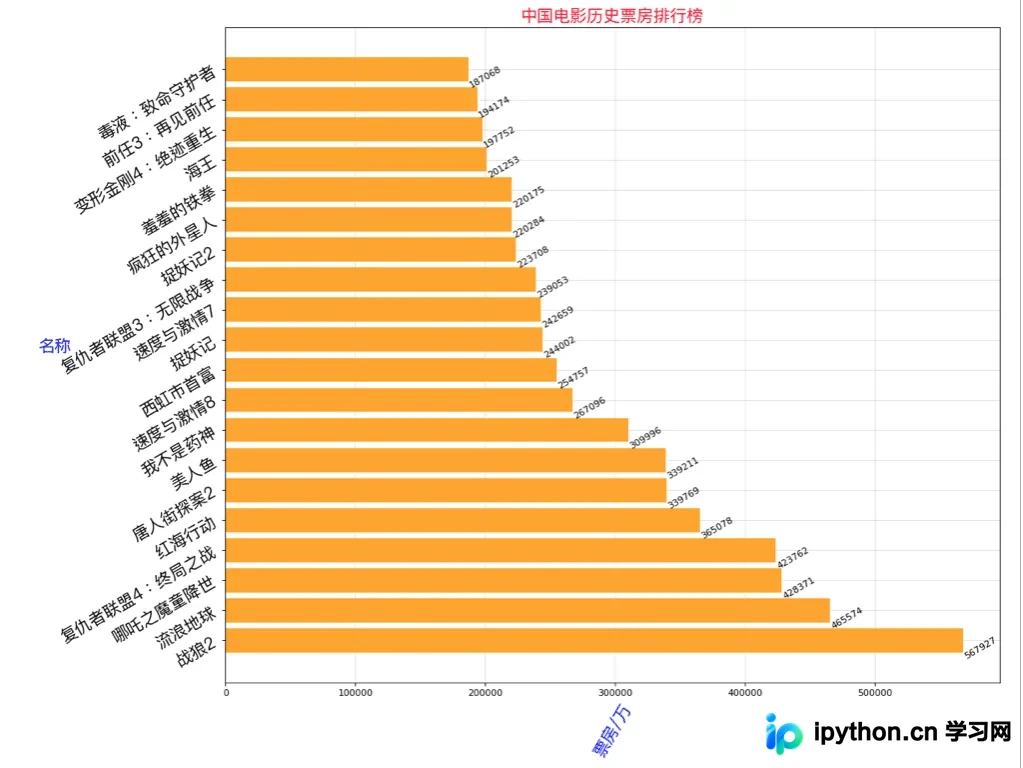
本文通过Python实现电影历史票房数据的抓取与可视化展示。利用requests库请求指定API获取JSON数据,结合matplotlib库绘制横向条形图。代码采用面向对象设计,封装了请求、解析及绘图逻辑,可直接运行查看结果,适合Python初学者参考学习。
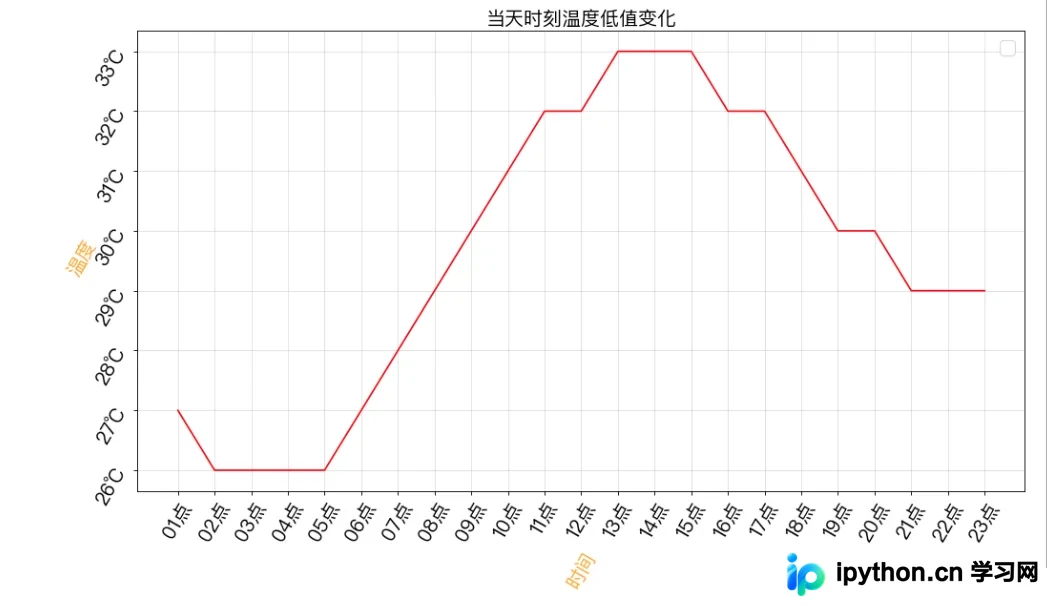
本文介绍使用Python爬虫技术抓取杭州今日24小时温度数据的方法。通过requests库发起请求,利用正则表达式解析HTML页面中的温度数值,并结合面向对象编程封装逻辑。最后使用Matplotlib库将提取的小时温度数据绘制为散点图或折线图,直观展示温度变化趋势。