

Python3爬虫实战:利用Tesserocr识别图形验证码

本文详细讲解在Python3爬虫中如何使用Tesserocr库识别简单的图形验证码。内容涵盖从获取验证码图片、直接调用OCR接口,到通过灰度转换和二值化处理去除干扰线条以提高识别准确率的全过程。结合知网注册页面实例,提供完整的代码示例与参数设置说明,帮助开发者解决验证码识别难题。
Python3爬虫实战:利用Tesserocr识别图形验证码
本节首先介绍一种最基础的验证码类型——图形验证码。这类验证码出现时间较早,目前仍广泛使用,通常由四位字母或数字组成。例如,中国知网注册页面就使用了此类验证码,其链接为:http://my.cnki.net/elibregister/commonRegister.aspx,页面效果如下:
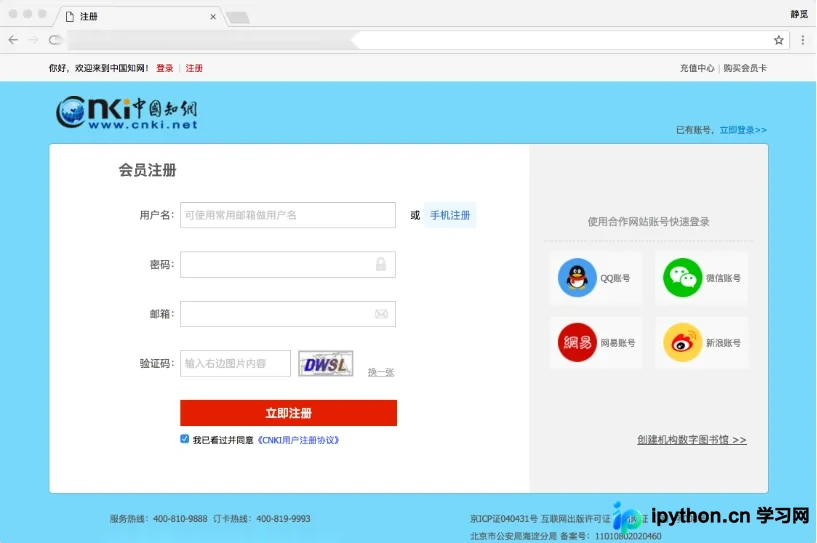
表单中的最后一项即为图形验证码,用户必须准确输入图中显示的字符才能完成注册流程。
本节目标
1.本节目标
本节将以知网验证码为例,演示如何利用OCR技术识别此类图形验证码。
准备工作
2. 准备工作
识别图形验证码需要依赖Tesserocr库,若尚未安装,请参考第一章的安装指南进行配置。
获取验证码
3. 获取验证码
为了便于实验操作,我们先将验证码图片保存至本地,以便后续测试使用。
打开浏览器开发者工具,定位到验证码元素,可以发现它是一个图片标签,其src属性指向CheckCode.aspx。直接访问该链接:http://my.cnki.net/elibregister/CheckCode.aspx,即可看到验证码图片。右键保存该图片,命名为code.jpg,如图8-2所示:
至此,我们获得了一张用于后续测试识别的验证码图片。
识别测试
4. 识别测试
接下来新建一个项目,将验证码图片放置于项目根目录下,使用Tesserocr库尝试识别该验证码,代码如下:
import tesserocr
from PIL import Image
image = Image.open('code.jpg')
result = tesserocr.image_to_text(image)
print(result)
代码中首先创建了一个Image对象,随后调用Tesserocr的image_to_text()方法,传入该对象即可完成识别。实现过程十分简洁,识别结果如下:
JR42此外,Tesserocr还提供了一种更简便的方法,直接将图片文件转换为字符串,同样能达到识别效果,代码如下:
import tesserocr
print(tesserocr.file_to_text('image.png'))
经测试,这种直接文件转换方法的识别效果不如前一种方法理想。
验证码处理
5. 验证码处理
上述图片的识别过程相对简单,只需新建Image对象并调用image_to_text()方法即可获取结果。
接下来我们更换一张验证码进行测试,命名为code2.jpg,如图8-3所示:
使用以下代码重新进行测试:
import tesserocr
from PIL import Image
image = Image.open('code2.jpg')
result = tesserocr.image_to_text(image)
print(result)
此时可以看到输出结果如下:
FFKT结果显示识别结果与实际字符存在偏差,原因在于验证码中的干扰线条影响了OCR的识别精度。
针对这种情况,我们需要对图片进行额外处理,例如转换为灰度图或进行二值化处理。
利用Image对象的convert()方法,传入参数'L'即可将图片转换为灰度图像,代码如下:
image = image.convert('L')
image.show()
若传入参数'1',则可对图片进行二值化处理:
image = image.convert('1')
image.show()
我们还可以指定二值化的阈值。上述方法使用的是默认阈值127,但不能直接对原图进行二值化转换,而应先转换为灰度图像,再指定阈值进行转换,代码如下:
image = image.convert('L')
threshold = 80
table = []
for i in range(256):
    if i < threshold:
        table.append(0)
    else:
        table.append(1)
image = image.point(table, '1')
image.show()
此处定义了一个变量threshold代表二值化阈值,将其设置为80。处理后的效果如图8-4所示:
经过处理后,验证码中的干扰线条已被去除,图像变得黑白分明。此时重新对处理后的验证码进行识别,代码如下:
import tesserocr
from PIL import Image
image = Image.open('code2.jpg')
image = image.convert('L')
threshold = 127
table = []
for i in range(256):
    if i < threshold:
        table.append(0)
    else:
        table.append(1)
image = image.point(table, '1')
result = tesserocr.image_to_text(image)
print(result)
运行结果变为:
PFRT识别正确。
由此可见,对于包含干扰元素的图片,通过灰度转换和二值化处理,可以显著提高识别的准确率。
本节代码
6. 本节代码
本节相关代码地址为:https://github.com/Python3WebSpider/CrackImageCode。
结语
7. 结语
本节介绍了利用Tesserocr识别验证码的基本流程。对于简单的图形验证码,可直接调用库函数获取结果;若需提高识别准确度,则应对验证码图片进行预处理。
以上就是Python3爬虫中识别图形验证码的实例讲解的详细内容,更多关于Python3爬虫识别图形验证码的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









