Python3爬虫中Splash负载均衡配置详解
本文详解如何在Python3爬虫中使用Splash进行高并发抓取时,通过Nginx配置负载均衡以分散压力。涵盖最少链接、轮询、权重及IP散列四种策略,并介绍基于Nginx的认证配置与测试方法,帮助提升爬虫系统的稳定性和处理效率。
2026-10-14
6

本文详解如何在Python3爬虫中使用Splash进行高并发抓取时,通过Nginx配置负载均衡以分散压力。涵盖最少链接、轮询、权重及IP散列四种策略,并介绍基于Nginx的认证配置与测试方法,帮助提升爬虫系统的稳定性和处理效率。
本文通过Python 3.7环境,演示如何使用Requests发起HTTP请求并处理GBK编码,结合BeautifulSoup解析HTML结构以提取51job职位列表。文章详细讲解了数据获取、解析及保存至JSON文件的完整流程,并探讨了多线程、动态渲染及数据库存储等进阶优化方向。
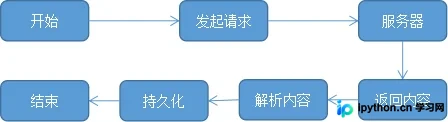
本文详细讲解如何使用Scrapy框架模拟登录赶集网。通过分析登录接口的POST请求参数,包括setcookie、__hash__及验证码机制,提供完整的Python代码实现。内容涵盖项目创建、Spider编写、表单数据构造及登录后的处理流程,帮助开发者掌握动态参数提取与自动登录技巧。
本文介绍在Python爬虫中遇到Cloudflare邮箱加密时的解决方案。通过分析前端JS代码,提取基于异或运算的解密逻辑,并使用Python的execjs库加载并调用该JS函数,成功还原加密后的邮箱地址,实现自动化采集。
本文详解Python爬虫中常见的403禁止访问及网络超时问题。通过模拟浏览器User-Agent解决反爬限制,利用requests模块设置timeout参数处理超时,并演示如何捕获ReadTimeout、HTTPError等具体异常类,提升爬虫稳定性。
本文分析使用Python Selenium结合多线程执行定时任务时,因频繁启动浏览器实例导致CPU占用率飙升至90%以上的问题。通过展示基于threading.Timer的简易定时代码,指出其潜在性能瓶颈,并探讨如何优化资源占用以避免系统卡顿,适用于需要长期运行的自动化爬虫场景。
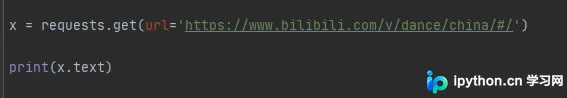
本文详细介绍如何使用Python的requests库查看网页源代码。通过导入requests模块,利用get()函数发送HTTP请求获取指定URL的HTML内容,并设置编码为utf-8后打印输出。文章包含完整代码示例及运行结果分析,适合初学者快速掌握网页数据抓取的基本方法。
本文介绍利用Python编写爬虫程序以提取百度搜索结果的完整代码实例。通过配置User-Agent池防止IP限制,使用urllib2库发起请求并解析HTML返回链接与标题。该示例展示了基础的网页抓取流程,适用于学习Python网络编程及数据提取技术,供开发者参考实现。
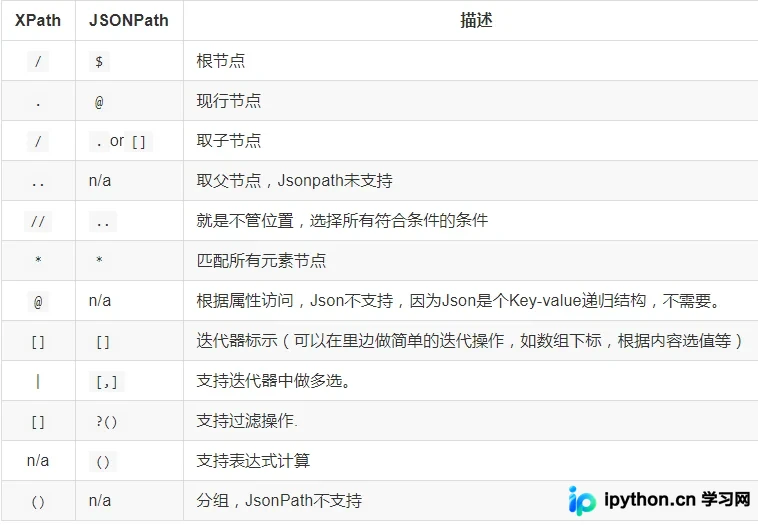
本文详解Python中JSON数据格式及JSONPath信息抽取工具。通过对比JSONPath与XPath语法,展示如何利用jsonpath库从拉勾网和城市数据中提取信息,并结合lxml处理糗事百科HTML内容。文章提供完整代码示例,涵盖JSON字符串转换、列表提取及文件保存操作,帮助开发者掌握Web数据抓取核心技巧。
本文系统梳理Python爬虫的核心知识点,涵盖从Python基础语法、urllib/urllib2网络请求库,到正则表达式数据提取,再到Scrapy高级框架的完整学习路径。同时解析爬虫背后的HTTP请求、DNS解析及服务器响应机制,帮助初学者建立完整的爬虫知识体系。
本文详解如何使用Python的Beautiful库结合CSS选择器高效抓取京东商品信息。通过解析搜索URL参数、利用urllib.quote编码关键词,并编写具体的CSS提取逻辑,快速获取商品名称、链接、图片及价格。适合希望掌握轻量级网页解析技术的开发者参考。
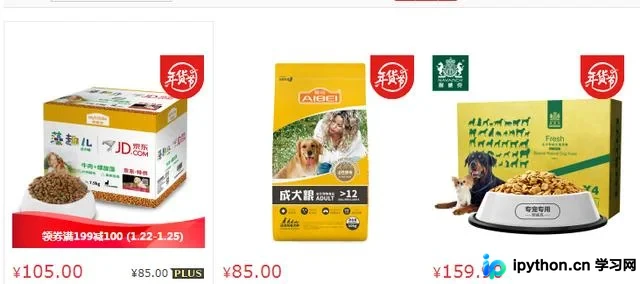
本文演示如何使用Python的BeautifulSoup库解析京东网页源码。通过构造包含keyword参数的搜索URL,利用urllib.quote进行编码,并解析HTML标签树提取商品名称、链接、图片及价格。文中特别指出处理空图片链接时使用get方法的技巧,对比正则表达式展示了BeautifulSoup的便捷性。