

Python爬取京东评论并保存Excel与可视化分析实战

发布时间:2026-10-14| 4人浏览过
本文介绍使用Python爬取京东商品评论的完整流程。通过requests库获取动态数据,利用openpyxl将清洗后的评论信息保存至Excel文件。随后读取Excel数据,统计商品尺码分布,并使用Matplotlib生成饼图进行可视化展示,帮助理解销售数据特征。
项目目标与数据流程概述
本次实践主要聚焦于从京东平台抓取某款鞋子的用户评论数据,并将获取的数据保存至Excel文件中,同时对相关数据进行可视化展示以直观呈现信息。
实现上述功能的核心Python代码逻辑如下:
第一个代码文件负责数据的读取、统计与可视化处理。
Excel数据读取与可视化分析
#将excel中的数据进行读取分析
import openpyxl
import matplotlib.pyplot as pit #数据统计用的
wk=openpyxl.load_workbook('销售数据.xlsx')
sheet=wk.active #获取活动表
#获取最大行数和最大列数
rows=sheet.max_row
cols=sheet.max_column
lst=[] #用于存储鞋子码数
for i in range (2,rows+1):
  size=sheet.cell(i,3).value
  lst.append(size)
#以上已经将excel中的数据读取完毕
#一下操作就你行统计不同码数的数量
'''python中有一个数据结构叫做字典,使用鞋码做key,使用销售数量做value'''
dic_size={}
for item in lst:
  dic_size[item]=0

for item in lst:
  for size in dic_size:
    #遍历字典
    if item==size:
      dic_size[size]+=1
      break
for item in dic_size:
  print(item,dic_size[item])
#弄成百分比的形式
lst_total=[]
for item in dic_size:
  lst_total.append([item,dic_size[item],dic_size[item]/160*1.0])

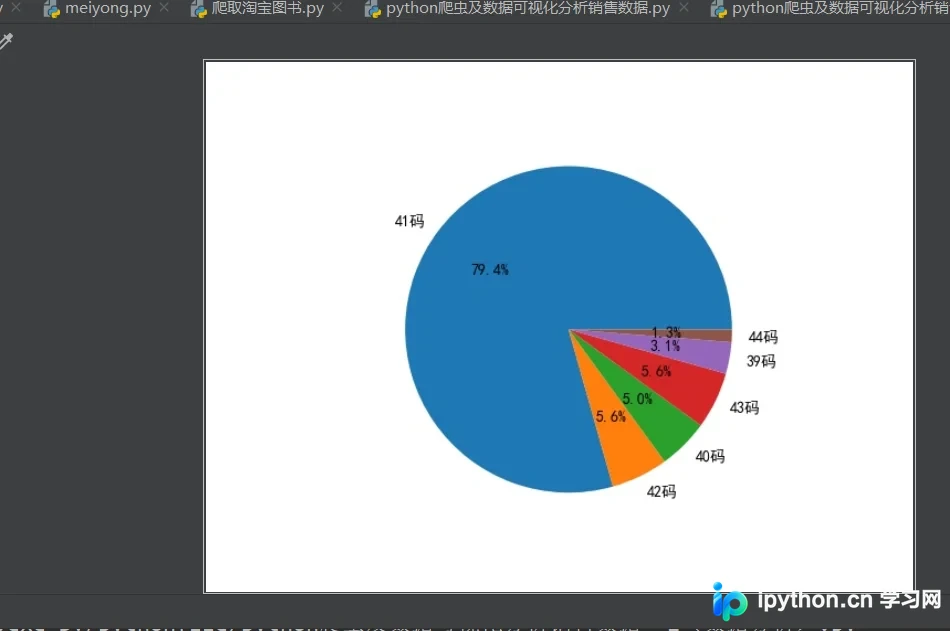
#接下来进行数据的可视化(进行画饼操作)
labels=[item[0] +'码'for item in lst_total] #使用列表生成式,得到饼图的标签
fraces=[item[2] for item in lst_total] #饼图中的数据源
pit.rcParams['font.family']=['SimHei'] #单独的表格乱码的处理方式
pit.pie(x=fraces,labels=labels,autopct='%1.1f%%')
#pit.show()进行结果的图片的展示
pit.savefig('图.jpg')
第二个代码文件负责数据的抓取、存储及清洗工作。
京东评论抓取与存储实现
#所涉及到的是requests和openpyxl数据的存储和数据的清洗以及统计然后就是matplotlib进行数据的可视化
#静态数据点击element中点击发现在html中,服务器已经渲染好的内容,直接发给浏览器,浏览器解释执行,
#动态数据:如果点击下一页。我们的地址栏(加后缀但是前面的地址栏没变也算)(也可以点击2和3页)没有发生任何变化说明是动态数据,说明我们的数据是后来被渲染到html中的。他的数据根本不在html中的。
#动态查看network然后用的url是network里面的headers
#安装第三方模块输入cmd之后pip install 加名字例如requests
import requests
import re
import time
import json
import openpyxl #用于操作 excel文件的
headers = {'user-agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.131 Safari/537.36'}#创建头部信息
def get_comments(productId,page):
  url = "https://club.jd.com/comment/productPageComments.action?callback=fetchJSON_comment98&productId={0}&score=0&sortType=5&page={1}&pageSize=10&isShadowSku=0&fold=1".format(productId,page)
  resp = requests.get(url, headers=headers)
  s=resp.text.replace('fetchJSON_comment98(','')#进行替换操作。获取到所需要的相应的json,也就是去掉前后没用的东西
  s=s.replace(');','')
  json_data=json.loads(s)#进行数据json转换
  return json_data

#获取最大页数
def get_max_page(productId):
  dis_data=get_comments(productId,0)#调用刚才写的函数进行向服务器的访问请求,获取字典数据
  return dis_data['maxPage']#获取他的最大页数。每一页都有最大页数

#进行数据提取
def get_info(productId):
  max_page=get_max_page(productId)
  lst=[]#用于存储提取到的商品数据
  for page in range(1,max_page+1):
    #获取没页的商品评论
    comments=get_comments(productId,page)
    comm_list=comments['comments']#根据comnents获取到评论的列表(每页有10条评论)
    #遍历评论列表,获取其中的相应的数据
    for item in comm_list:
      #每条评论分别是一字典。在继续通过key来获取值
      content=item['content']
      color=item['productColor']
      size=item['productSize']
      lst.append([content,color,size])#将每条评论添加到列表当中
    time.sleep(3)#防止被京东封ip进行一个时间延迟。防止访问次数太频繁
  save(lst)

def save(lst):
  #把爬取到的数据进行存储,保存到excel中
  wk=openpyxl.Workbook()#用于创建工作簿对象
  sheet=wk.active #获取活动表(一个工作簿有三个表)
  #遍历列表将数据添加到excel中。列表中的一条数据在表中是一行
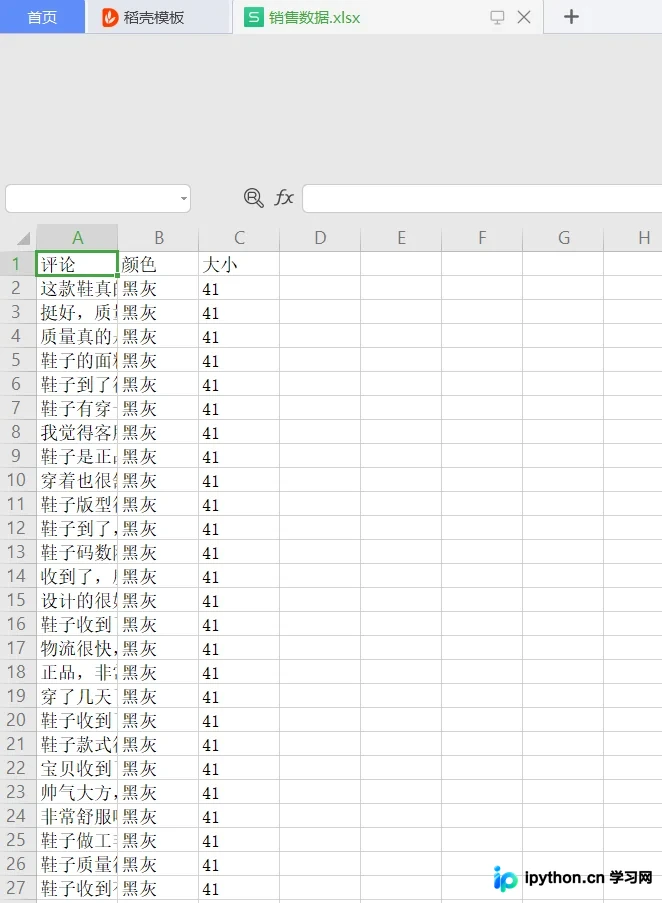
  biaotou='评论','颜色','大小'
  sheet.append(biaotou)
  for item in lst:
    sheet.append(item)
  #将excel保存到磁盘上
  wk.save('销售数据.xlsx')


if __name__=='__main__':
  productId='66749071789'
  get_info(productId)
  print("ok")
最终运行程序后,生成的可视化效果如下所示:
以上内容即为本次教程的全部介绍,希望能为读者的学习提供有益帮助,同时也欢迎大家继续支持本站获取更多技术资源。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









