Python实战:利用Scrapy与browsercookie获取浏览器Cookie进行博客爬取
本文详解如何在Python Scrapy框架中集成browsercookie库,通过读取本地Firefox浏览器的Cookie实现免登录爬取。重点讲解如何替换默认的CookiesMiddleware,处理Chrome 80版本后的加密差异,并演示如何构造POST请求完成自动化点赞操作,为需要登录态的爬虫提供实用方案。
2026-10-14
6

本文详解如何在Python Scrapy框架中集成browsercookie库,通过读取本地Firefox浏览器的Cookie实现免登录爬取。重点讲解如何替换默认的CookiesMiddleware,处理Chrome 80版本后的加密差异,并演示如何构造POST请求完成自动化点赞操作,为需要登录态的爬虫提供实用方案。
本文通过实测对比单线程、多线程、多进程及aiohttp协程四种方式在Python爬虫中的表现。结果显示,处理十万级页面时,aiohttp协程方案比单线程快90倍,多线程提升68倍,多进程提升7倍。文章提供了各方案的代码实现与耗时数据,为提升爬虫并发效率提供实用参考。
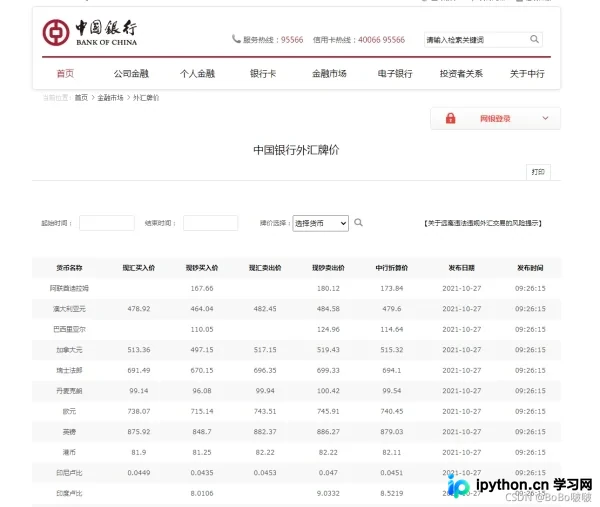
本文详解如何使用Python的requests、BeautifulSoup和xlwings库,从中国银行外汇牌价官网抓取实时数据。通过解析HTML表格提取关键信息,利用xlwings将数据写入Excel,并自动生成包含货币对价格的折线图,实现数据抓取、存储与可视化的完整流程。
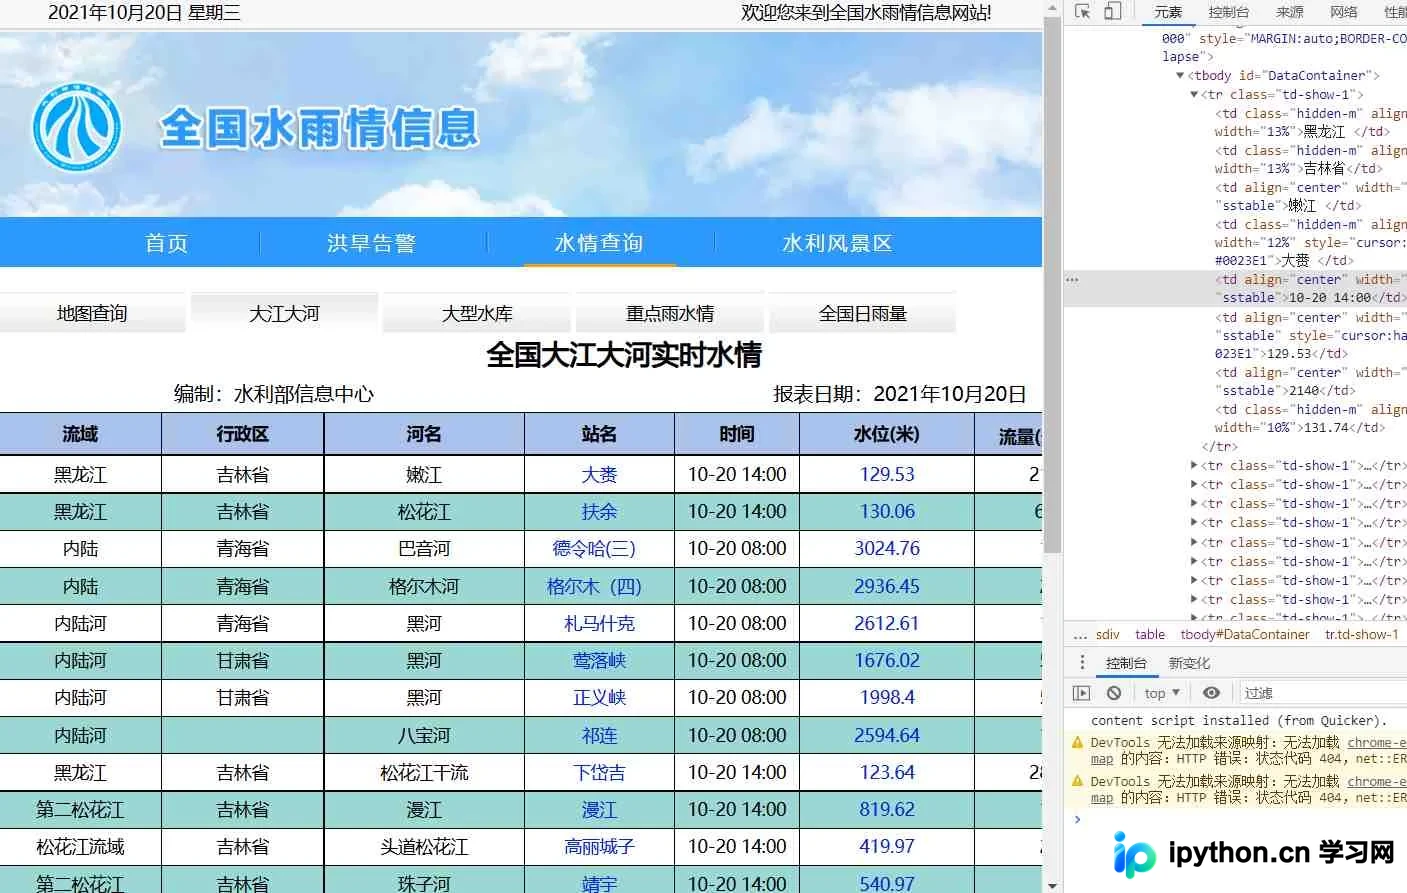
本文详细解析如何使用Python结合Selenium库爬取全国水雨情信息。针对无直接接口的情况,通过模拟浏览器行为获取页面数据,并利用pandas进行清洗与存储。文章涵盖代码实现、结果展示及常见问题分析,包括时间处理、代码优化建议,为相关数据采集提供完整参考。
本文详细介绍Python爬虫的核心流程,涵盖使用requests获取网页数据、利用lxml进行HTML解析,以及将数据保存为CSV文件或存入MySQL数据库的具体实现。通过完整代码示例,演示如何处理动态页面、登录状态及异常捕获,帮助开发者快速掌握网络数据采集与持久化技术。
本文介绍如何使用Python编写一个简单的新闻爬虫程序。通过requests获取网页HTML,利用bs4解析提取标题与正文,并结合Tkinter构建图形界面。最后使用PyInstaller将脚本编译为独立的exe文件,实现无需Python环境即可运行的新闻查看工具。
本文详细介绍Python中数据解析的概念,重点讲解BeautifulSoup库的安装与核心用法。通过实例演示如何利用BeautifulSoup定位HTML标签、提取文本内容及属性值,并完整展示爬取三国演义章节及内容的Python代码实现过程。
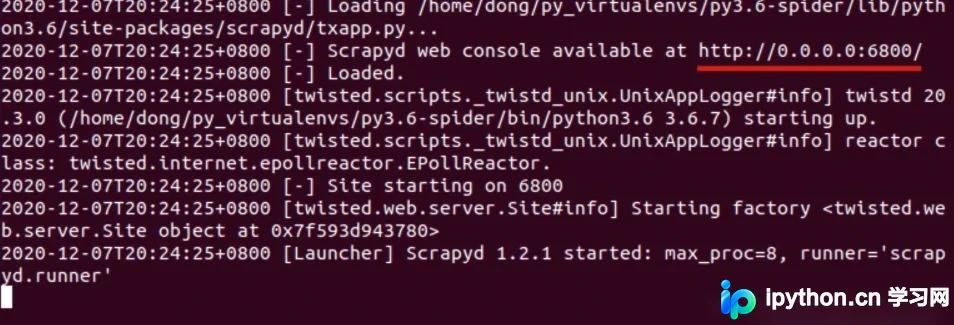
本文详细介绍Scrapy项目通过scrapyd进行服务器部署的完整流程。涵盖scrapyd的安装、配置文件修改以实现远程访问、scrapyd-client的使用、项目发布及爬虫调度命令。同时介绍Gerapy可视化管理工具的安装与基础配置,帮助开发者实现高效、可视化的爬虫运维管理。
本文详细介绍如何使用Python爬取B站热门视频排行榜Top100的数据。通过伪装浏览器请求、利用BeautifulSoup和正则表达式解析网页源码,并将排名、标题、播放量等七项关键信息保存至SQLite数据库。教程涵盖核心代码逻辑与数据保存策略,适合Python初学者参考学习。
本文介绍基于Python3和Windows环境的爬虫开发基础,涵盖Anaconda与Jupyter工具使用。详细解析Robots协议规范、动态页面处理及反爬策略。同时展望Python在数据分析、人工智能、运维自动化及Web开发领域的核心应用与实战价值。
本文详解Python爬虫应对常见反爬策略的三种核心方法。首先介绍如何通过F12开发者工具获取并模拟User-Agent和Referer以伪装浏览器身份;其次讲解IP代理的配置及访问频率控制,防止IP被封禁;最后阐述手动与自动获取Cookie的技巧,利用Session保持登录状态,有效解决403禁止访问错误。
本文详细介绍Python中BeautifulSoup库的安装方法及核心功能。内容涵盖从bs4库的引用、BeautifulSoup类的基本概念,到Tag标签的name、attrs及字符串类型解析。重点讲解标签树的上下行与平行遍历操作,以及prettify()格式化输出和编码处理,帮助开发者快速掌握HTML/XML文档解析技巧。