

Python+Selenium爬取全国水雨情数据实战解析

发布时间:2026-10-15| 2人浏览过
本文详细解析如何使用Python结合Selenium库爬取全国水雨情信息。针对无直接接口的情况,通过模拟浏览器行为获取页面数据,并利用pandas进行清洗与存储。文章涵盖代码实现、结果展示及常见问题分析,包括时间处理、代码优化建议,为相关数据采集提供完整参考。
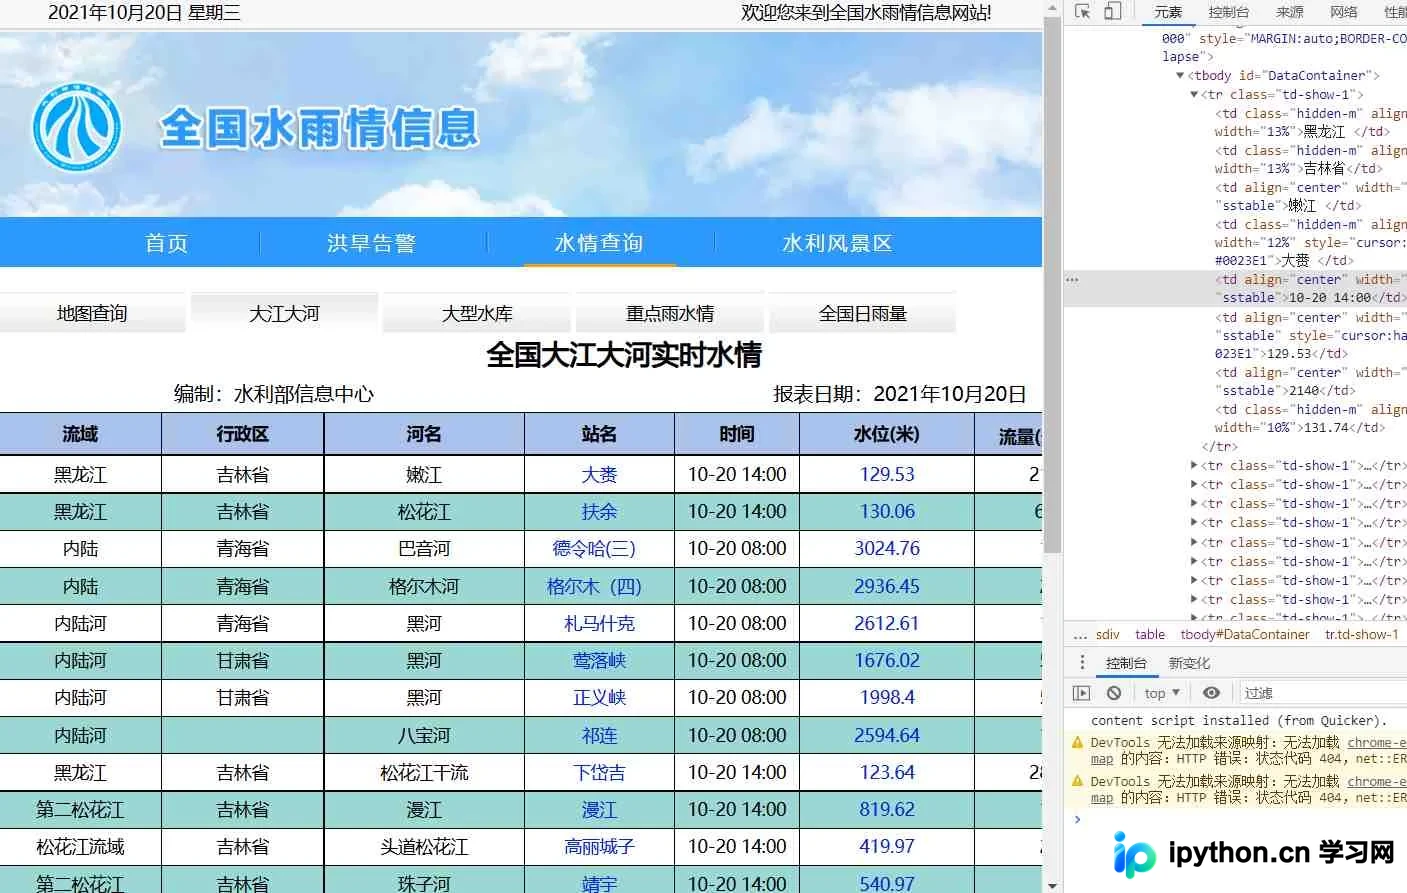
分析
由于未能找到直接的数据接口,我们决定采用Selenium工具进行网页爬取。
代码
import datetime
import pandas as pd
from bs4 import BeautifulSoup
from selenium import webdriver
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.common.by import By
from selenium.webdriver.support import expected_conditions as EC
from selenium.webdriver.chrome.options import Options #建议使用谷歌浏览器
import time
chrome_options = Options()
chrome_options.add_argument('--headless')
driver = webdriver.Chrome()

# 存储中英文对应的变量的中文名
word_dict = {"poiBsnm": "流域",
             "poiAddv": "行政区",
             "rvnm": "河名",
             "stnm": "站名",
             "tm": "时间",
             "zl": "水位(米)",
             "ql": "流量(立方米/秒)",
             "wrz": "警戒水位(米)"}
# 空df接收结果
rain_total = pd.DataFrame([])

url = 'http://xxfb.mwr.cn/sq_dxsk.html'
driver.get(url)
time.sleep(5)
infos = driver.find_elements_by_xpath("/html/body//tbody[@id='DataContainer']/tr")
# pd.set_option('display.max_columns', None)#所有列
# pd.set_option('display.max_rows', None)#所有行

# 列表提取
for info in infos:
    poiBsnm = info.find_element_by_xpath("./td[1]").text
    poiAddv = info.find_element_by_xpath("./td[2]").text
    rvnm = info.find_element_by_xpath("./td[3]").text
    stnm = info.find_element_by_xpath("./td[4]").text
    tm = info.find_element_by_xpath("./td[5]").text
    zl = info.find_element_by_xpath("./td[6]").text
    ql = info.find_element_by_xpath("./td[7]").text
    wrz = info.find_element_by_xpath("./td[8]").text
# 组成pandas对象
    rain_data = [[poiBsnm,poiAddv,rvnm,stnm,tm,zl,ql,wrz]]
    rain_df = pd.DataFrame(data=rain_data,columns=list(word_dict.values()))
    rain_total = pd.concat([rain_total,rain_df])
    print(rain_total)
# 关闭浏览器
driver.close()
# 保存数据
data_str = datetime.datetime.now().strftime('%Y_%m_%d')
rain_total.to_csv("%s_全国水雨情信息.csv" % (data_str),index=None, encoding="GB18030")
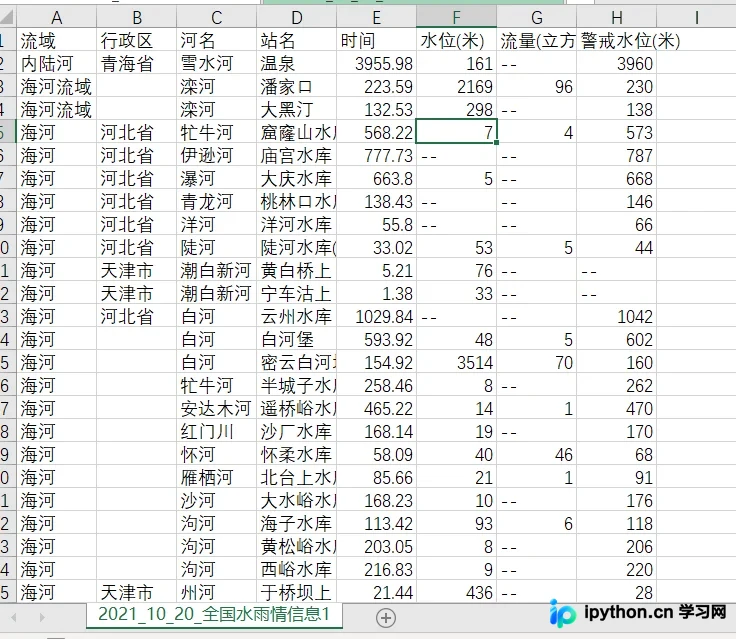
结果
总结
本次爬取过程中,时间数据的处理存在一定偏差,具体原因尚待厘清。此外,循环逻辑部分代码略显冗余,有简化空间;整体架构尚未实现模块化封装。在此感谢崔工提供的支持。
本文到此结束,希望能为读者带来启发。欢迎持续关注本站,获取更多技术内容。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









