Python使用Appium在移动端抓取微博数据的实现
本文介绍如何利用Appium配合Python实现移动端微博数据的自动化抓取。内容涵盖Appium与Android Studio的安装配置,通过反编译APK获取包名与Activity,录制操作生成Python代码,以及使用Appium-Python-Client库提取具体微博内容的完整流程。
2026-10-14
6

本文介绍如何利用Appium配合Python实现移动端微博数据的自动化抓取。内容涵盖Appium与Android Studio的安装配置,通过反编译APK获取包名与Activity,录制操作生成Python代码,以及使用Appium-Python-Client库提取具体微博内容的完整流程。
本文总结了利用Python读取微信朋友圈的四种方法。首先排除了通过好友链接查看自身朋友圈及已关闭的网页版微信方案。接着分析了基于Appium模拟器的可行性,重点介绍了通过pywinauto库模拟PC微信窗口操作的具体实现。文章提供了获取进程、定位控件、模拟点击及读取数据的完整代码示例,并探讨了后续数据清洗与自动回复的扩展方向。
本文详细介绍Python爬虫中动态代理IP的切换方法及urllib2超时参数的设置技巧。通过示例代码展示如何构建代理处理器、定期更换IP以规避频率限制,并讲解timeout参数在应对响应缓慢网站时的应用,旨在帮助开发者提升爬虫稳定性与成功率。
本文介绍Python爬虫在爬取商品时因反爬机制导致失败的处理方法。通过浏览器开发者工具分析Network请求,提取有效的Cookie和User-Agent信息,并将其添加到headers中。文章提供了完整的代码示例,展示如何正确构建请求头以绕过基础反爬验证,确保数据抓取成功。
本文详解如何利用Python抓取百度贴吧表情包,并通过百度AI开放平台的OCR接口识别图片文字。文章涵盖API Key申请、贴吧数据抓取及多线程下载,最终实现根据识别出的主要文字自动重命名图片文件,提升表情包管理效率。
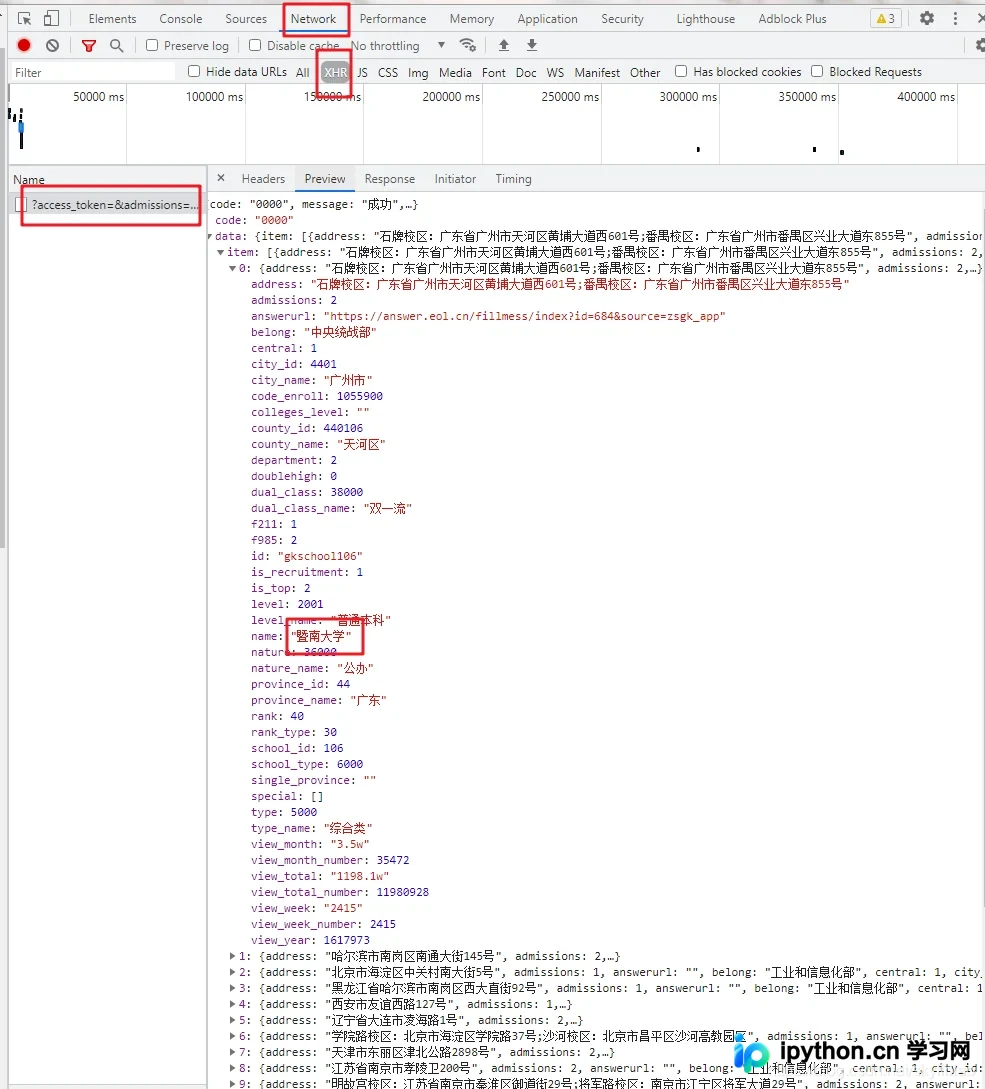
本文详解如何利用Python爬取中国教育在线的高校数据,通过requests发送POST请求获取JSON数据,使用Pandas进行清洗与存储至Excel,最后结合Matplotlib等库生成柱形图、地图及分布统计,辅助大学选择决策。
本文详解如何使用Python编写爬虫程序,通过requests获取爱奇艺热门电影页面源码,并利用BeautifulSoup解析HTML结构,提取电影链接与名称等关键信息。教程涵盖环境配置、代码实现及结果验证,帮助开发者快速掌握基础网页数据抓取技巧。
本文详细演示如何使用Python抓取某婚恋网站的公开征婚数据。通过浏览器开发者工具分析页面加载机制,确定采用同步加载处理方式。文章逐步解析URL规律、构造请求头、利用XPath提取关键信息,并完整展示数据保存至CSV文件的代码实现,为初学者提供清晰的爬虫开发思路。
本文介绍使用Python编写脚本从指定网站批量爬取高清原图壁纸的方法。通过构建代理IP池以规避反爬机制,利用urllib库进行HTTP请求,并结合正则表达式解析页面结构,实现图片的自动识别与保存。代码包含完整的代理获取、验证及下载逻辑,适合Python初学者参考学习网络爬虫基础技术。
本文介绍如何使用Python结合Selenium和Requests库,动态渲染并爬取中国天气网实时数据及微博热搜榜。通过win32gui模拟键鼠操作,实现指定时间自动向微信好友发送天气详情与热榜信息,并支持打包为exe文件运行。
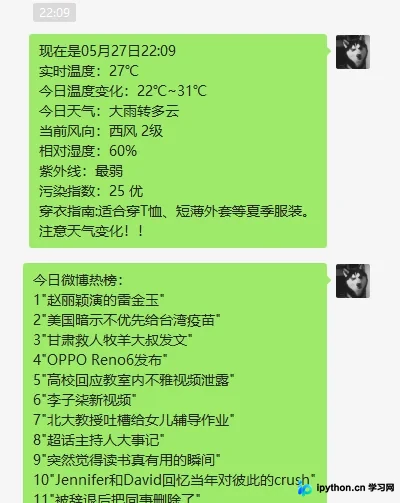
本文介绍使用Python和BeautifulSoup4编写简易爬虫,分别抓取开心网和豆瓣的个人日记。教程涵盖获取浏览器Cookie、配置请求头、处理HTML解析及文件保存等核心步骤,并提供完整代码示例与注意事项。
本文详细演示如何利用Python逆向分析APP数据。通过Fiddler抓包发现SSL Pinning,使用Xposed和JustTrustme绕过;利用ApkScan查壳、frida-DEXDump脱壳及jadx反编译定位加密逻辑。最终通过Frida Hook获取AES密钥,在Python中复现加解密过程,成功抓取APP接口数据。