

Python数据解析:使用BeautifulSoup提取三国演义章节内容

本文详细介绍Python中数据解析的概念,重点讲解BeautifulSoup库的安装与核心用法。通过实例演示如何利用BeautifulSoup定位HTML标签、提取文本内容及属性值,并完整展示爬取三国演义章节及内容的Python代码实现过程。
数据解析
数据解析是指从爬取到的完整网页中提取局部特定内容的过程。在Python生态中,常用的数据解析技术主要包括以下三种:
- bs4(Python专用库)
- xpath(推荐,通用性强)
- 正则表达式
数据解析的基本原理如下:
首先,需要解析或提取的目标数据通常存储于HTML标签内部或标签的特定属性中。
因此,第一步是精确定位到包含目标数据的指定标签。
随后,从定位到的标签或其属性中提取并解析出所需的数据值。
BeautifulSoup
Beautiful Soup是一个用于从HTML或XML文件中提取数据的Python库,且该库仅适用于Python语言环境。
bs4数据解析的工作流程
第一步,实例化一个BeautifulSoup对象,并将页面源码数据加载至该对象。加载源码数据主要有两种方式:一是加载本地的HTML文档,二是加载从互联网获取的页面源码。
第二步,调用BeautifulSoup对象提供的相关属性或方法,执行标签定位和数据提取操作。
使用bs4前,需先下载并安装对应的依赖包。
pip install bs4
pip install -i https://mirrors.aliyun.com/pypi/simple/ lxml
BeautifulSoup用法
提取整个标签数据
进行标签定位时,常用的几个方法如下:
soup。标签名 返回HTML中第一次出现的该标签。
soup.find(标签名) 返回第一次出现的该标签。
soup.find_all(标签名) 返回符合要求的所有一级标签。
soup.select(标签名) 返回符合要求的所有一级标签。
from bs4 import BeautifulSoup    #导包
html = """
<html lang="en">
    <head>
      <meta charset="utf-8">
      <meta name="theme-color" content="#ffffff">
      <base href="./" rel="external nofollow" ><link rel="stylesheet" href="styles.30d0912c1ece284d8d9a.css" rel="external nofollow" >
    </head>
    <body>
        <div>
            <p>百里守约</p>
        </div>
        <div class="song">
            <p>前程似锦</p>
        </div>
        <div class="song">
            <p>前程似锦2</p>
        </div>
        <div class="ming">  #后面改了名字
            <p>以梦为马</p>
        </div>
        <div class="tang">
            <ul>
                <li><a href='http://123.com' title='qing'>清明时节</a></li>
                <li><a href='http://ws.com' title='qing'>秦时明月</a></li>
                <li><a href='http://xzc.com' title='qing'>汉时关</a></li>
            </ul>
        </div>
      <flink-root></flink-root>
        <script type="text/javascript" src="runtime.0dcf16aad31edd73d8e8.js"></script><script type="text/javascript" src="es2015-polyfills.923637a8e6d276e6f6df.js" nomodule></script><script type="text/javascript" src="polyfills.bb2456cce5322b484b77.js"></script><script type="text/javascript" src="main.8128365baee3dc30e607.js"></script>
    </body>
</html>
"""
#实例化一个BeautifulSoup对象,并且将本地的源码数据加载到该对象中。且使用html.parser进行数据解析
soup = BeautifulSoup(html,'html.parser')
print(soup.meta)      #输出<meta charset="utf-8">
print(soup.p)         #输出<p>百里守约</p>

#find
print(soup.find('div'))  #输出<div><p>百里守约</p></div>
#这里有多个div标签,根据属性定位,因为class为关键字,所以这里加_
print(soup.find('div',class_="song"))   #<p>前程似锦</p>

#find_all
print(soup.find_all('p'))  #[<p>百里守约</p>, <p>前程似锦</p>, <p>前程似锦2</p>, <p>以梦为马</p>]
print(soup.select('.tang'))  #将这个选择器中的所有内容提取
print(soup.select('.tang > ul > li > a')[1])  #返回ul中的li中的所有a标签中的第二个a标签 <a href="http://ws.com" rel="external nofollow"  title="qing">秦时明月</a>
提取标签中的内容以及标签的属性值
#获取标签中的内容
print(soup.p.text)      #输出百里守约
print(soup.find('div',class_="ming").text)  #以梦为马
print(soup.find('div',class_="song"))
print(soup.select('.tang   a')[0].text)   #清明时节

#获取标签中的属性值,如a标签中的href值
print(soup.select('.tang   a')[0]['href'])  #http://123.com
案例——爬取三国演义章节及对应的内容
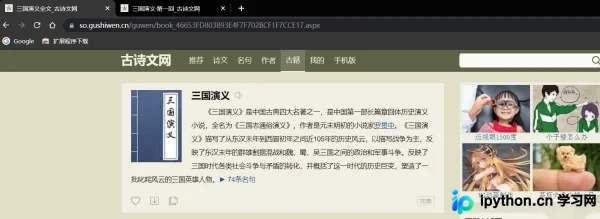
目标网站如下,该网站的数据获取并非通过Ajax发送请求。
import requests
from bs4 import BeautifulSoup
url = 'https://so.gushiwen.org/guwen/book_46653FD803893E4F7F702BCF1F7CCE17.aspx'
headers={
    'User-Agent':'Mozilla/5.0 (Linux; Android 6.0; Nexus 5 Build/MRA58N) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.75 Mobile Safari/537.36'
}
pag_content = requests.get(url,headers,timeout=4).text
#print(pag_content)
#提取每章节内容的链接
soup = BeautifulSoup(pag_content,'html.parser')
a_text = soup.select('.bookcont a')     #将其下面的所有a标签提取出来
for i in a_text:
    #获取a标签中的href属性的值
    detail_url = i['href']
    #请求详细内容的url的内容
    detail_content = requests.get(detail_url,headers,timeout=4).text
    soup = BeautifulSoup(detail_content,'html.parser')
    #提取class标签
    class_content = soup.find('div',class_='contson')
    #print(class_content)  #该标签中有很多p标签,返回整个class_content标签
    #print(class_content.text)   #获取其所有的内容
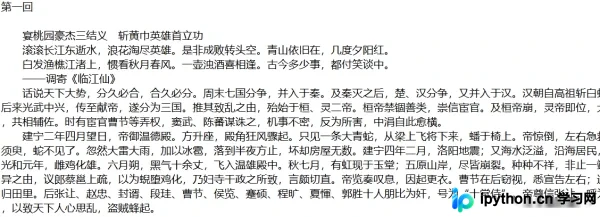
    with open('三国演义.txt','a',encoding='utf-8') as f:
        f.write(i.text+'\r')
        f.write(class_content.text+'\r')
    print(f'爬取{i.text}ok')
print('全部ok')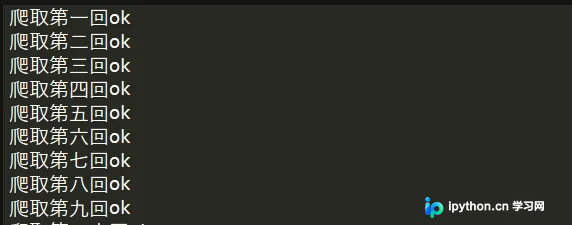
以上即为Python数据解析中利用BeautifulSoup爬取三国演义章节的示例详解,更多关于BeautifulSoup爬取三国演义章节的资料,请关注本站其他相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









