Python+Tkinter打造签名设计工具
本文介绍如何使用Python结合Tkinter库与网络爬虫技术,开发一个个性签名设计工具。通过解析在线签名网站的POST请求,获取用户输入并生成签名图片,同时处理输入校验与界面交互,最终打包为独立应用。
2026-10-15
6

本文介绍如何使用Python结合Tkinter库与网络爬虫技术,开发一个个性签名设计工具。通过解析在线签名网站的POST请求,获取用户输入并生成签名图片,同时处理输入校验与界面交互,最终打包为独立应用。
本文详解Scrapy框架中下载中间件的编写方法。涵盖process_request、process_response及process_exception三大核心函数的实现逻辑,演示如何通过中间件进行UA伪装、响应数据篡改(结合Selenium处理动态加载)以及代理IP设置,并说明在settings.py中启用中间件的具体配置步骤。
本文详解如何利用Python爬取微博移动端动态图片。针对PC端反爬限制,通过解析m.weibo.cn接口获取用户UID及动态列表,提取图片ID后拼接完整链接进行下载。文中包含参数转码、UID获取及循环下载的具体代码实现与步骤说明。
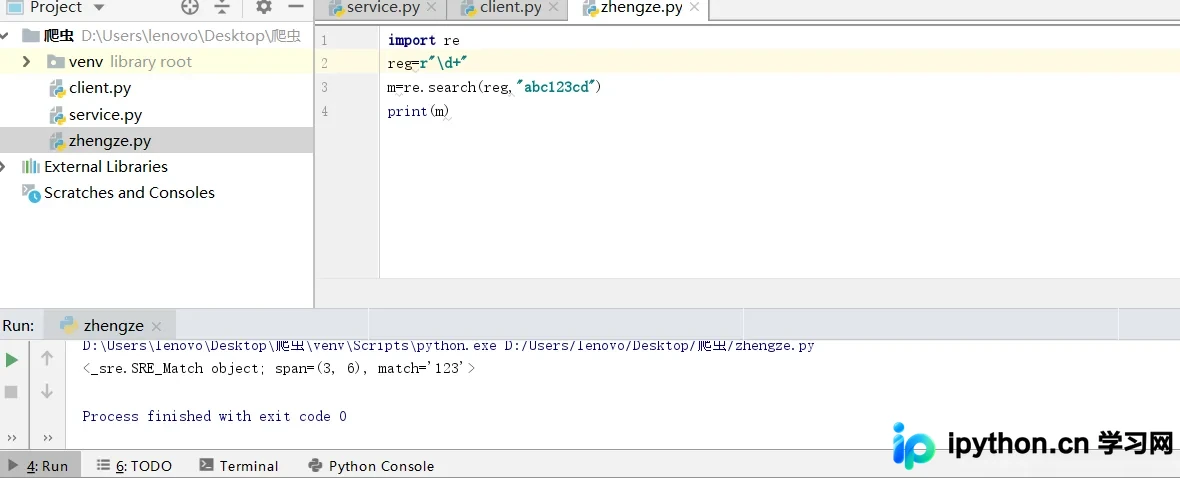
本文系统梳理Python中正则表达式的核心用法,涵盖re模块引入、常用元字符(如\d, \w, \s)及量词(+, *, ?)的具体含义。通过实例解析如何提取连续数字、识别单词边界及处理特殊字符,并演示利用search函数结合切片操作完整提取字符串中所有单词的实战方法,适合Python初学者快速掌握文本处理技能。
本文介绍如何利用Python Selenium获取并复用Cookie,实现Airbnb网站的免密登录。通过手动登录后保存Cookie文件,后续请求直接加载Cookie,无需重复输入账号密码,有效提升爬虫效率。
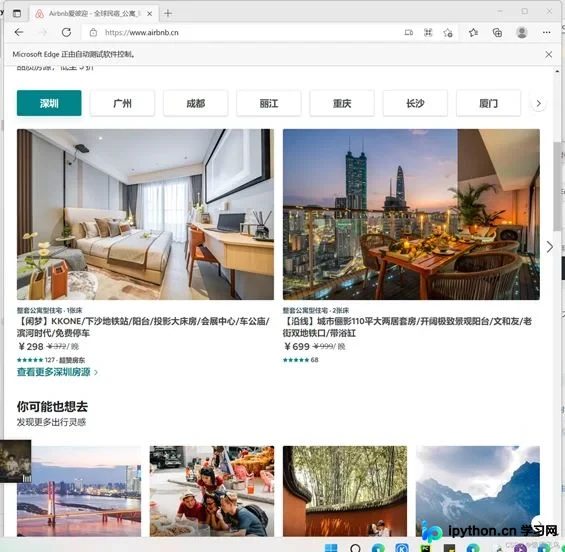
本文详解如何利用 Selenium 控制已打开的 Chrome 浏览器,通过指定 user-data-dir 和 remote-debugging-port 参数,实现复用本地浏览器的缓存与登录信息。适用于需要保持登录状态进行网页爬取或自动化操作的场景,避免重复模拟登录。
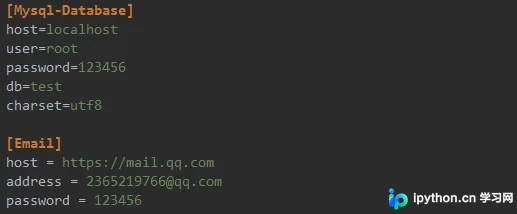
本文介绍如何利用Python内置的ConfigParser模块读取ini格式配置文件,并通过二次封装实现灵活配置管理。通过对比绝对路径与相对路径读取方式,演示了如何将数据库连接信息、爬虫参数等配置抽离至独立文件。文章提供了完整的类封装代码,涵盖读取配置、连接MySQL及执行SQL操作,帮助开发者提升项目配置的灵活性与可维护性。
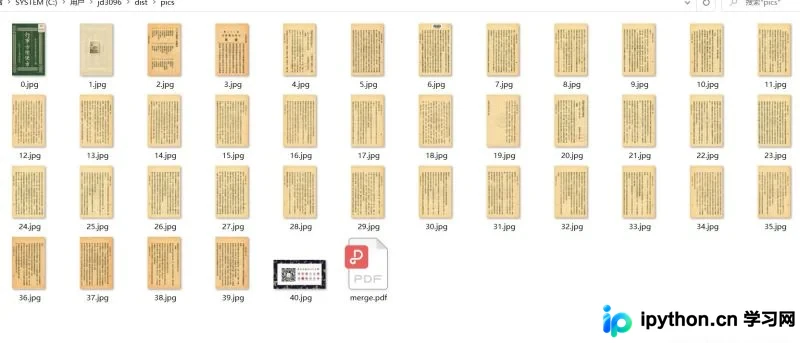
本文介绍了一款基于Python的微信公众号文章图片抓取与PDF转换工具。该工具支持自动解析文章中的图片链接并批量下载,利用fpdf库将图片按原始比例整合为PDF文档,同时添加序号以便查阅。文章提供了完整的代码逻辑说明及操作示例,帮助开发者快速实现图文内容的本地化归档。
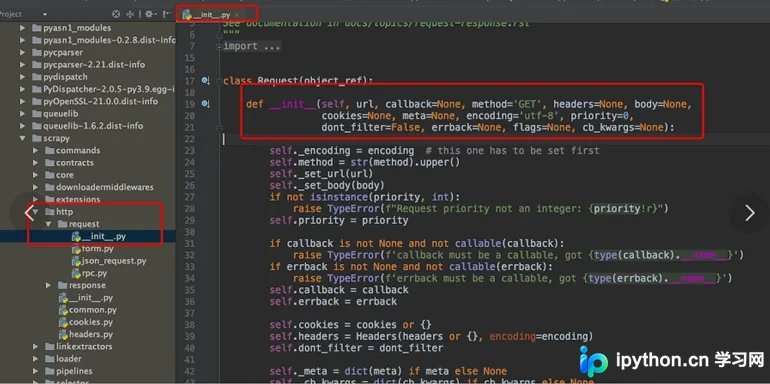
本文详细介绍Python Scrapy框架中Request和Response对象的核心用法。解析Request对象的url、callback、method等关键参数,演示如何通过FormRequest发送POST请求,并列举Response对象的text、body、xpath等常用属性,帮助开发者掌握Scrapy基础数据交互机制。
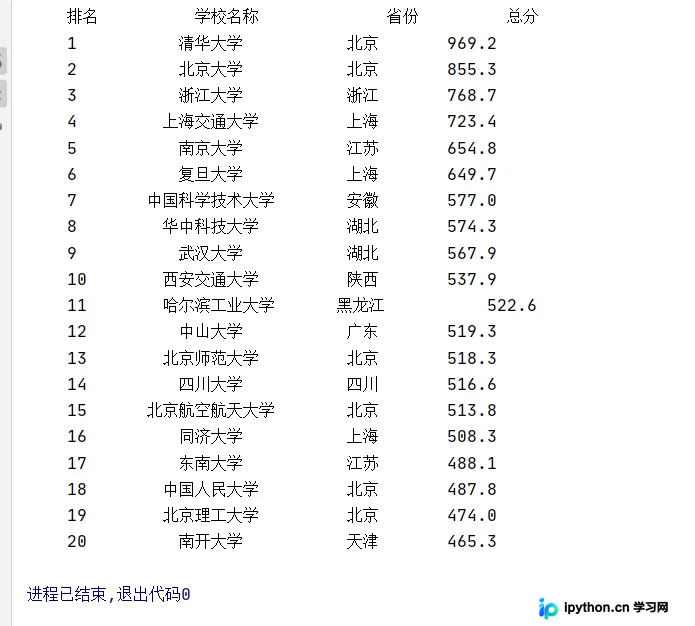
本文介绍如何使用Python编写网络爬虫,自动获取中国大学排名网站的前20所大学信息。通过requests库请求网页,利用BeautifulSoup解析HTML结构,提取学校名称、省份及总分等关键字段,并将结果格式化输出至控制台及本地文本文件,实现数据的自动化采集与持久化存储。
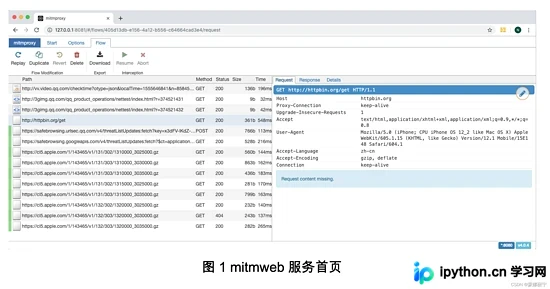
本文介绍如何利用mitmweb这一Web版可视化工具监听移动App的网络请求与响应。通过启动服务并访问默认端口8081,用户可以在浏览器界面中查看URL列表、请求详情及响应数据。文章还演示了如何编辑响应信息、使用Replay功能重发请求以及查看详细信息,并对比了mitmweb与mitmdump结合Python处理的适用场景,为移动App数据抓取提供可视化分析方案。
本文详细介绍Python中Selenium库的安装与ChromeDriver配置,演示无头模式、页面截图、元素定位及交互操作。涵盖多窗口切换、Cookie管理、代理设置及滑块验证码处理,并分析其优缺点,帮助开发者高效构建自动化测试与数据采集工具。