Python实现CSV文件追加写入新列的两种方法
本文介绍在Python中向CSV文件追加新列的两种常用方法。第一种利用Pandas库读取数据后直接赋值新列并保存;第二种通过csv模块逐行读取并修改。文章包含代码示例及注意事项,帮助开发者高效处理CSV数据追加任务。
2026-10-13
6

本文介绍在Python中向CSV文件追加新列的两种常用方法。第一种利用Pandas库读取数据后直接赋值新列并保存;第二种通过csv模块逐行读取并修改。文章包含代码示例及注意事项,帮助开发者高效处理CSV数据追加任务。
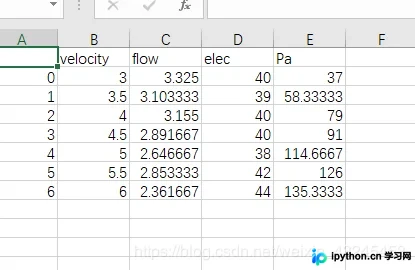
本文详细介绍pandas库中DataFrame的append方法,涵盖其函数签名、核心参数如ignore_index和verify_integrity的作用。通过字典、Series及列表三种数据结构的添加示例,演示如何处理索引冲突及列名扩展,帮助开发者高效进行数据合并操作。
本文详细介绍Pandas中处理缺失值的核心方法。涵盖如何识别Series和DataFrame中的NaN与None,使用dropna按行或列过滤数据,以及通过fillna进行指定值、前后向或均值填充。掌握这些技巧可提升数据清洗效率。
本文详细介绍Python中pandas库的排序与排名功能。涵盖Series和DataFrame按索引或值排序的方法,包括sort_index和sort_values的使用及注意事项。同时解析rank函数的多种排名策略(如first、min、max、average)及处理重复值和平局的情况,帮助开发者高效处理数据排序与排名需求。
本文详解Pandas中利用.sort和.loc函数进行数据排序与筛选的方法,涵盖单列与多列排序、条件组合逻辑。进一步演示如何结合聚合函数实现类似Excel的Sumif、Countif及Averageif统计功能,助力高效数据处理。
本文介绍 Python Pandas 中时间日期的进阶处理方法,涵盖日期格式转换、基于时间的数据过滤与提取、星期几的判断(含名称与数字量化)、日期加减运算以及判断月末、月初和闰年等常用技巧。
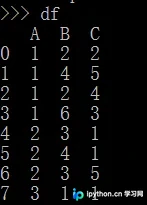
本文介绍如何利用Python Pandas库对数据集中多列元素进行分组统计。通过groupby()指定多列参数,结合size()计算出现频次,并将MultiIndex Series转换为包含自定义列名的DataFrame结构,实现高效的数据聚合分析。
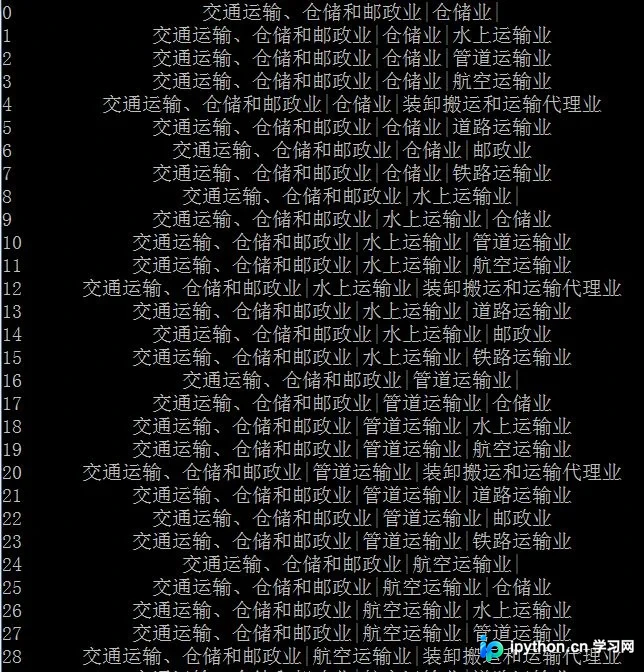
本文详解在pandas中如何使用str.split方法对包含分隔符的字符串列进行分割。重点解析expand参数的作用:设为True时可自动将分割结果展开为多列,设为False则保持单列。通过具体代码示例展示如何提取特定分割后的子列,适用于行业分类等数据的标准化处理。
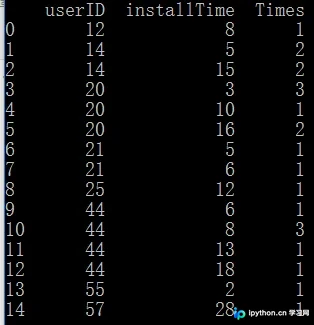
本文介绍如何利用Python Pandas库中的cumsum函数,结合groupby操作,实现按用户ID分组统计历史累计安装次数。通过具体数据集示例,演示从数据分组到计算累加值的全过程,帮助开发者快速掌握累计统计技巧。
本文详解Python中numpy和pandas计算标准差的区别。默认情况下,numpy.std()使用有偏估计(除以n),而pandas.std()使用无偏估计(除以n-1)。通过调整ddof参数,可实现两种算法的互换。文章指出ddof=1为无偏估计的关键,并提醒在scikit-learn等库中手动设置该参数的重要性,尤其在数据量较小时需特别注意。
本文探讨pandas中MultiIndex对象在切片或布尔索引后,其index属性仍保留原始层级的问题。通过示例展示该现象,并推荐使用remove_unused_levels()方法清理未使用的索引层级,确保df.index与实际数据索引一致,避免潜在Bug。
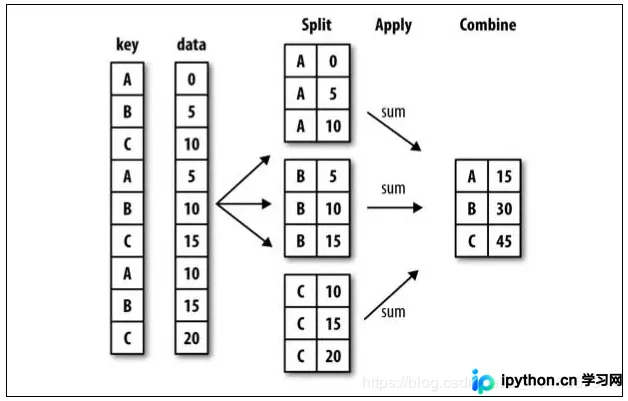
本文详细介绍Pandas中分组与排序的核心操作。通过split-apply-combine机制解析groupby函数,演示单列、多列分组及不同聚合函数的应用,并对比DataFrame与Series返回类型。同时讲解按索引和数值降序排列的sort_index与sort_values方法,提供完整代码示例。