

Pandas分组与排序核心操作指南

发布时间:2026-10-13| 5人浏览过
本文详细介绍Pandas中分组与排序的核心操作。通过split-apply-combine机制解析groupby函数,演示单列、多列分组及不同聚合函数的应用,并对比DataFrame与Series返回类型。同时讲解按索引和数值降序排列的sort_index与sort_values方法,提供完整代码示例。
Pandas分组运算机制
在Pandas数据处理中,分组操作是核心功能之一。
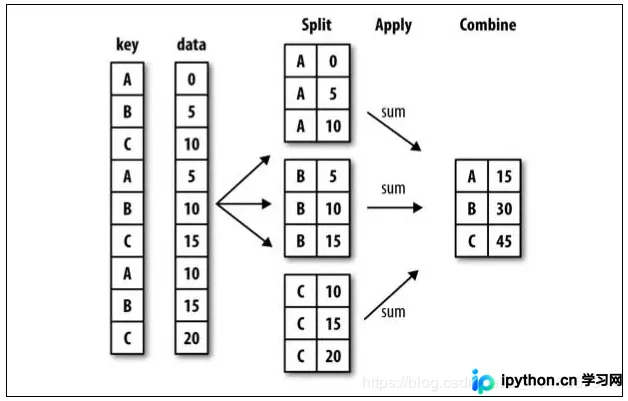
分组运算遵循“拆分-应用-合并”(split-apply-combine)的基本流程。
- 拆分阶段:确定进行分组的具体依据。
- 应用阶段:定义每个分组内部执行的计算规则。
- 合并阶段:将各个分组的计算结果整合在一起。
分组函数与聚合应用
Pandas提供了专门的分组函数来实现上述逻辑。
DataFrame.groupby(by=None, axis=0, level=None, as_index=True, sort=True, group_keys=True, squeeze=False, observed=False, **kwargs
by参数用于指定分组的依据列,其值可以是映射字典、函数、标签或标签列表。
除了基础分组,Pandas还支持丰富的聚合函数以处理统计需求。
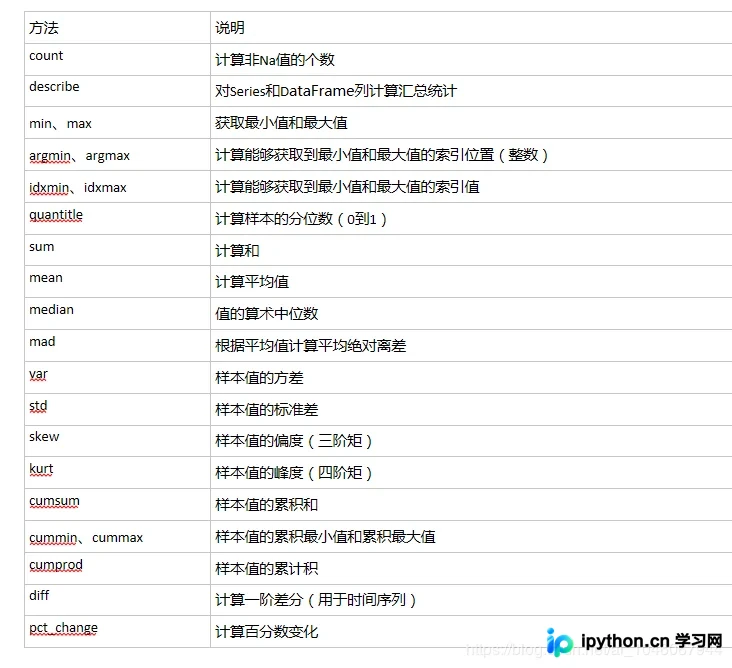
下面通过具体实例展示分组聚合的实际应用。
首先演示单列分组的场景。
>>> import pandas as pd
>>> df = pd.DataFrame({'A': ['a', 'b', 'a', 'c', 'a', 'c', 'b', 'c'], 'B': [2, 8, 1, 4,
3, 2, 5, 9], 'C': [102, 98, 107, 104, 115, 87, 92, 123], 'D': [2, 98, 17, 14, 15, 7, 92,
 13]})
>>> df
  A B  C  D
0 a 2 102  2
1 b 8  98 98
2 a 1 107 17
3 c 4 104 14
4 a 3 115 15
5 c 2  87  7
6 b 5  92 92
7 c 9 123 13
>>> df.groupby(by='A').sum()
  B  C  D
A
a  6 324  34
b 13 190 190
c 15 314  34
接着介绍多列分组的实现方式。
>>> df.groupby(by=['A','B']).sum()       ###A,B成索引
    C  D
A B
a 1 107 17
 2 102  2
 3 115 15
b 5  92 92
 8  98 98
c 2  87  7
 4 104 14
 9 123 13
进一步展示如何对多个列同时进行聚合计算。
>>> df.groupby(by=['A','B'])['C'].sum()   ###1个列
A B
a 1  107
  2  102
  3  115
b 5   92
  8   98
c 2   87
  4  104
  9  123

>>> df.groupby(by=['A','B'])['C','D'].sum()  ###2个列
    C  D
A B
a 1 107 17
 2 102  2
 3 115 15
b 5  92 92
 8  98 98
c 2  87  7
 4 104 14
 9 123 13
当不同列需要应用不同的聚合函数时,可采用混合聚合策略。
>>> import numpy as np
>>> df.groupby(by=['A']).agg({'C':[np.mean, 'sum'], 'D':['count',np.std]})
      C     D
     mean sum count    std
A
a 108.000000 324   3 8.144528
b  95.000000 190   2 4.242641
c 104.666667 314   3 3.785939


>>>ps: 不同列使用多个不同函数进行聚合C: mean,sum;D:count,std
需要注意的是,不同实现方式返回的数据类型存在差异。
方法1:agg
>>> df.groupby(by=['A']).agg({'C':[np.mean]})
      C
     mean
A
a 108.000000
b  95.000000
c 104.666667
>>> type(df.groupby(by=['A']).agg({'C':[np.mean]}))
<class 'pandas.core.frame.DataFrame'>


方法2:索引
>>> df.groupby(by=['A'])['C'].mean()
A
a  108.000000
b   95.000000
c  104.666667
Name: C, dtype: float64
>>> type(df.groupby(by=['A'])['C'].mean())
<class 'pandas.core.series.Series'>


总结: 两种方法结果一样,但是一个类型是DataFrame,一个为Series;有时候会用上
Pandas排序操作指南
排序是数据处理的另一项基础操作,Pandas提供了多种排序方式。
可以使用sort_index方法按索引进行降序排列。
>>> df
  A B  C  D
0 a 2 102  2
1 b 8  98 98
2 a 1 107 17
3 c 4 104 14
4 a 3 115 15
5 c 2  87  7
6 b 5  92 92
7 c 9 123 13
>>> df.sort_index(ascending=False)    ### 索引
  A B  C  D
7 c 9 123 13
6 b 5  92 92
5 c 2  87  7
4 a 3 115 15
3 c 4 104 14
2 a 1 107 17
1 b 8  98 98
0 a 2 102  2
也可以使用sort_values方法按特定列的值进行降序排列。
>>> df.sort_values(by="A",ascending=False)    # 按某一列
  A B  C  D
3 c 4 104 14
5 c 2  87  7
7 c 9 123 13
1 b 8  98 98
6 b 5  92 92
0 a 2 102  2
2 a 1 107 17
4 a 3 115 15

>>> df.sort_values(by=["B","A"],ascending=False)  # 按2列
  A B  C  D
7 c 9 123 13
1 b 8  98 98
6 b 5  92 92
3 c 4 104 14
4 a 3 115 15
5 c 2  87  7
0 a 2 102  2
2 a 1 107 17
以上内容涵盖了Pandas分组与排序的主要用法,希望能为读者提供实用参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









