

Pandas数据筛选与排序实战:从基础操作到聚合统计

本文详解Pandas中利用.sort和.loc函数进行数据排序与筛选的方法,涵盖单列与多列排序、条件组合逻辑。进一步演示如何结合聚合函数实现类似Excel的Sumif、Countif及Averageif统计功能,助力高效数据处理。
Pandas数据筛选与排序概述
在Excel中,筛选和排序是最高频使用的功能,允许用户依据特定条件对数据表进行过滤和计算,从而快速获取所需结果。在Python的Pandas库中,通过.sort和.loc函数同样可以实现这两项核心操作。.sort函数负责数据表的排序,而.loc函数则用于执行筛选。本文将详细介绍如何利用Pandas的这两个函数,完成与Excel中相似的筛选和排序任务。
首先,需要导入Pandas库和numpy库,读取数据并创建数据表,将该数据表命名为lc。
import pandas as pd
import numpy as np
lc=pd.DataFrame(pd.read_csv('LoanStats3a.csv',header=1))
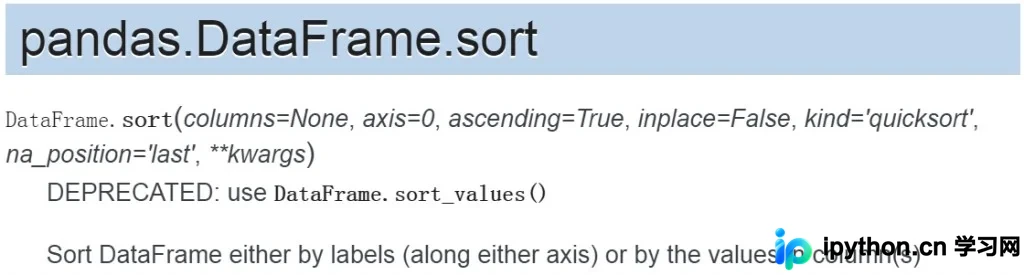
数据表创建完成后,开始使用Pandas的.sort函数对数据表进行排序。以下是Pandas官方对.sort函数语法和使用方法的说明。.sort函数主要包含6个参数:columns指定要排序的列名;ascending定义排序方式,True为升序,False为降序,默认值为True;axis指定排序轴,0表示按索引(行)排序,1表示按列名排序,当对数据列进行排序时,axis必须设置为0;inplace默认为False,表示直接修改原数据表而不创建新实例;kind可选排序算法,如快速排序等;na_position处理NaN值的方式,可选first或last,默认值为last,即将NaN值置于排序结果的末尾。
数据排序操作详解
在了解.sort函数的语法和使用方法后,我们开始利用该函数对数据进行排序操作。数据源来自Lending Club 2017-2011年的公开数据。首先演示对单列数据进行排序。
对单列数据进行排序
升序
单列数据的排序方法十分简单,依据.sort函数的说明,只需明确指定要排序的数据表名称以及目标列名即可。具体代码和排序结果如下所示,其中lc是前文读取并创建的数据表名称,loan_amnt是要进行排序的列名。此处我们将lc数据表按loan_amnt列进行升序排列。需要注意的是,ascending参数的默认值为True,即升序。因此,以下两种写法的效果是相同的。
lc.sort(["loan_amnt"])
lc.sort(["loan_amnt"],ascending=True)
降序
将ascending参数的值改为False,即可完成对数据表的降序排列。与升序排列的数据表相比,升序排列将loan_amnt列的最小值置于前端,由此可判断loan_amnt的最小金额为500;相反,降序排列将最大值置于前端,因此loan_amnt的最大金额应为35000。此处未设置na_position参数,故按默认情况,loan_amnt列的NaN值显示在排序结果的末尾。以下展示了降序排列的代码和结果。
lc.sort(["loan_amnt"],ascending=False)对多列数据进行排序
除了对单列数据进行排序外,.sort函数还支持对多列数据进行排序操作。下面分别对loan_amnt和int_rate字段进行降序排列,具体代码和排序结果如下。与单列数据排序的代码相比,此处仅增加了一个新的列名int_rate。
lc.sort(["loan_amnt","int_rate"],ascending=False)我们将需要排序的两个列名互换位置,再次执行降序排列操作。观察两次的排序结果可以发现,此次结果与之前的结果存在差异。Loan_amnt字段的排序结果看似混乱,部分较小值排在了较大值的前面。这是因为第一次排序时loan_amnt是第一排序字段,int_rate是第二排序字段。当两个字段交换位置后第二次排序,int_rate变为第一排序字段,loan_amnt变为第二排序字段。
lc.sort(["int_rate","loan_amnt"],ascending=False)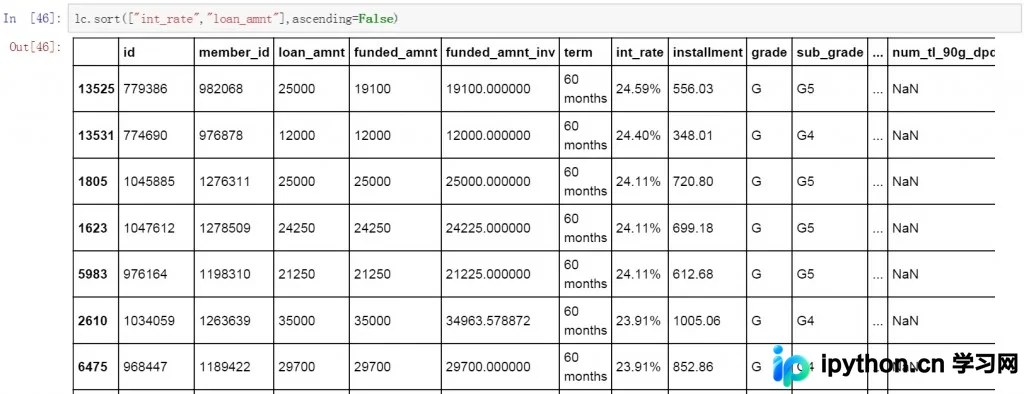
获取金额最小前10项
在完成数据表排序操作后,我们可以对数据表进行简单的筛选,例如获取loan_amnt金额最小的前10条数据。具体方法是先对lc数据表按loan_amnt升序排列,然后取前10条数据。NaN值默认在排序结果的末尾显示。以下是具体代码和结果。与前面单列升序排列的代码相比,仅在结尾增加了.head()函数。
lc.sort(["loan_amnt"],ascending=True).head(10)获取金额最大前10项
获取金额最大前10条数据的代码与获取金额最小前10条数据略有差异。原本只需复制前面的代码,将.head()函数改为tail()函数即可,但由于NaN值位于排序尾部,因此我们将lc数据表按loan_amnt降序排列,并取排名前10条的数据。当然,这并非唯一方法,我们还可以通过忽略NaN值的排序或将NaN值置于排序前端来解决此问题。以下是具体代码和执行结果。
lc.sort(["loan_amnt"],ascending=False).head(10)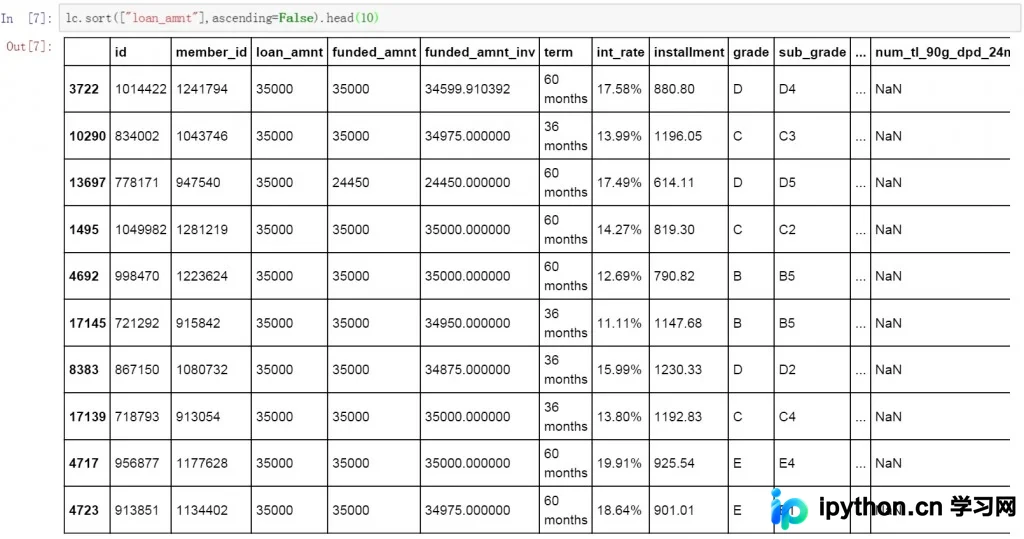
数据筛选与组合逻辑
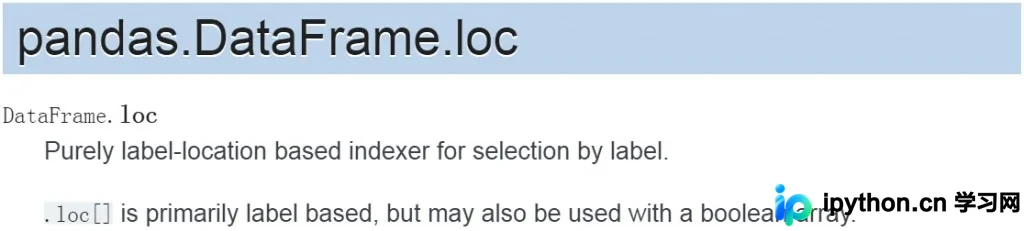
介绍完排序功能后,接下来看筛选功能。在筛选方面,Pandas使用的是.loc函数。以下是Pandas官方对.loc函数语法和使用方法的说明。
单列数据筛选并排序
我们使用.loc对lc数据表中grade列为B值的数据条目进行了筛选操作,具体代码和筛选结果如下。在代码中lc.loc[]是.loc函数的语法,lc[“grade”] == “B”是具体的筛选条件。由于数据表较大,因此在最后使用了head()函数仅显示前5行筛选结果。从筛选结果来看,grade列的值均为B。
lc.loc[lc["grade"] == "B"].head()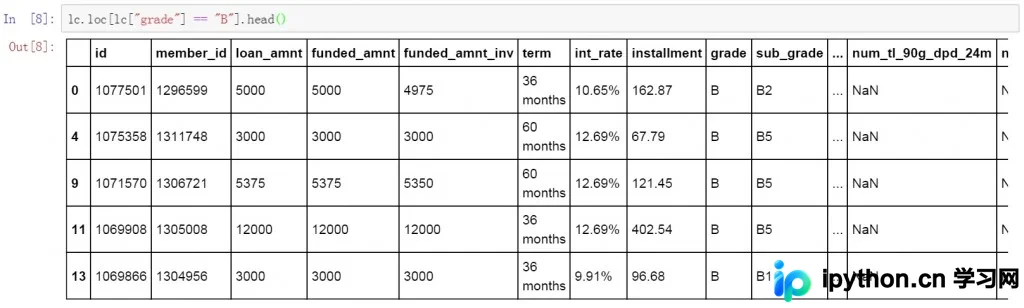
筛选条件除了“等于”(==)以外,还可以使用“不等于”(!=)来排除列中特定的值。我们使用“不等于”来筛选grade列中不是B值的数据条目。以下是具体代码和筛选结果,可以看到筛选结果中的grade列已不包含B值。
lc.loc[lc["grade"] != "B"].head()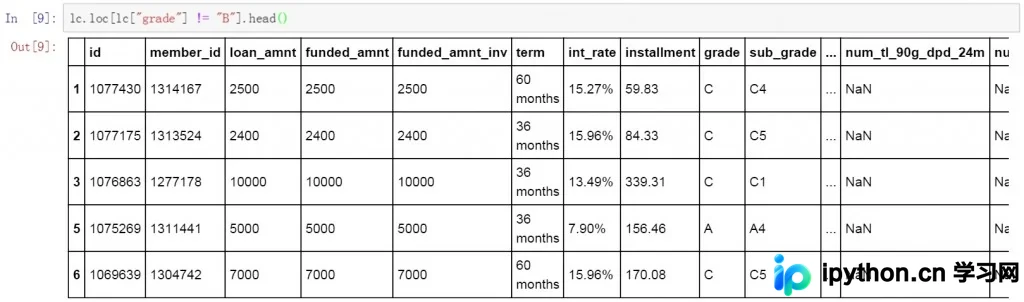
很多时候我们只关注数据表中某几列的数据,这时可以在前面筛选代码的基础上增加要显示的列名和显示顺序。下面是具体代码和筛选结果。代码部分与之前相比增加了要显示的列名[“member_id”, “loan_amnt”, “grade”]。其余部分均未改变。在筛选结果的数据表中可以看到,仅显示了我们在代码中列出的三列。
lc.loc[lc["grade"] == "B", ["member_id", "loan_amnt", "grade"]].head()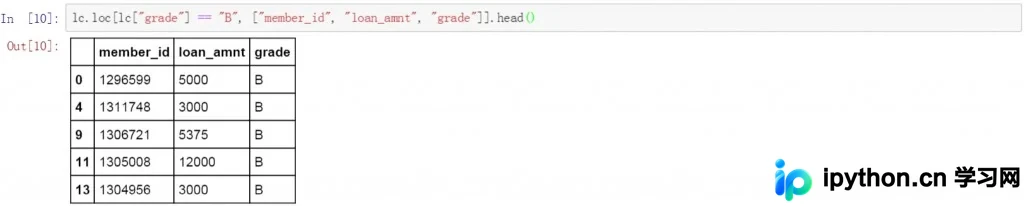
若要对筛选结果进行排序,可以联合使用.loc函数和.sort函数。下面的代码中首先对数据表的grade列进行筛选,选择所有值为B的数据,并限定了结果中要显示的三列的名称。最后对筛选出的结果按loan_amnt的金额进行升序排序。
lc.loc[lc["grade"] == "B", ["member_id", "loan_amnt", "grade"]].sort(["loan_amnt"])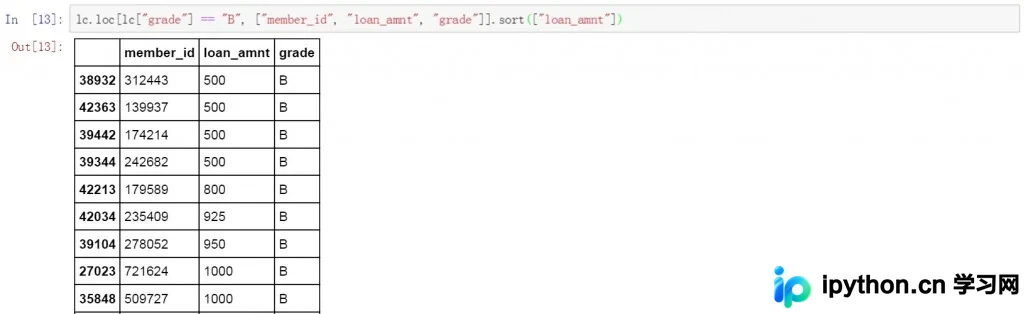
在代码后面增加ascending参数,并将值设置为False,即可实现对筛选结果的降序排列。以下为具体代码和筛选及排序结果。
lc.loc[lc["grade"] != "B", ["member_id", "loan_amnt", "grade"]].sort(["loan_amnt"],ascending=False)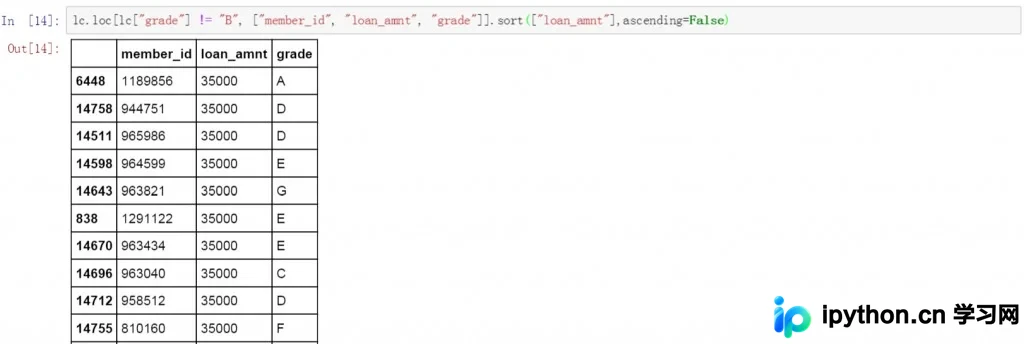
多列数据筛选并排序
Pandas的.loc参数还可以同时对多列数据进行筛选,并且支持不同筛选条件的逻辑组合。常用的筛选条件包括“等于”(==)、“不等于”(!)、 “大于”(>)、“小于”(<)、“大于等于”(>=)、“小于等于”(<=)等。逻辑组合包括“与”(&)和“或”(|)。下面我们将通过3条多列数据筛选代码逐一进行介绍。
第一条代码使用“与”逻辑,筛选出了grade等于B,并且loan_amnt金额大于5000的数据。并限定了显示的列名。从筛选结果中可以看出,grade列的值均为B,loan_amnt的金额均大于5000。
lc.loc[(lc["grade"] == "B") & (lc["loan_amnt"]>5000), ["member_id", "term" , "loan_amnt", "grade","sub_grade", "int_rate"]].head()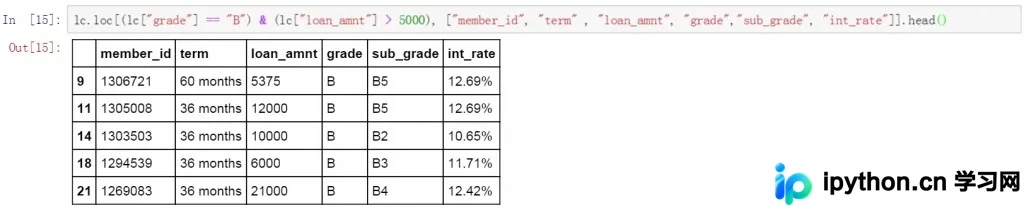
第二条代码也使用“与”逻辑,筛选出了grade不等于B,并且loan_status不等于Charged Off的数据,同时也限定了显示的列名。从筛选结果看,grade列不包含B值,并且loan_status列不包含Charged Off值。
lc.loc[(lc["grade"] != "B") & (lc["loan_status"] != "Charged Off"),["member_id", "term" , "loan_amnt", "grade", "sub_grade", "loan_status"]].head()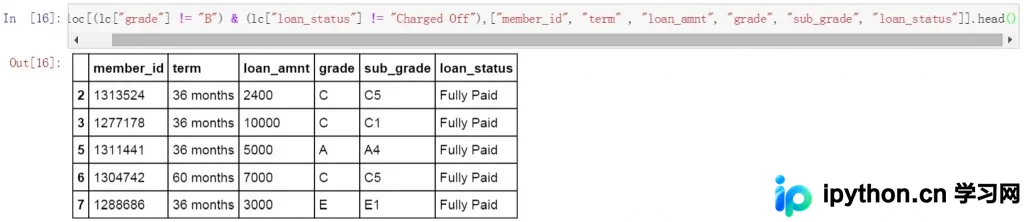
第三条代码使用了“或”逻辑,筛选出了grade列值为B,或loan_amnt列金额大于5000的数据,同时也限定了显示的列名。从筛选结果来看,grade列除了B值以外还保留了其他值,而这些值在loan_amnt列的金额均大于5000。换句话说,一条数据只要grade列或loan_amnt列任意之一符合筛选条件,这条数据就会被显示。
lc.loc[(lc["grade"] == "B") | (lc["loan_amnt"] > 5000), ["member_id", "term" , "loan_amnt", "grade","sub_grade", "int_rate"]].head()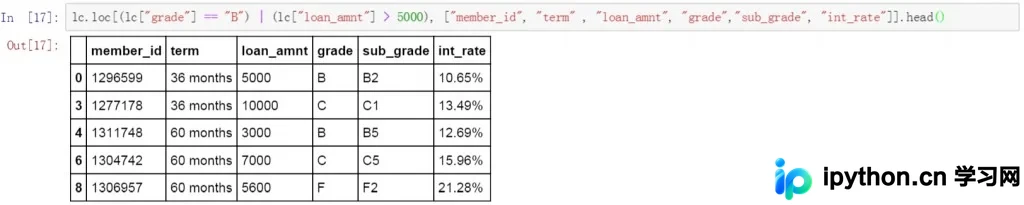
多列筛选也可以进行排序,方法与单列筛选后排序基本一样。下面的代码对多列筛选后的结果按loan_amnt列进行升序排序。由于筛选条件中限定了loan_amnt列的值要大于5000,因此排序的结果从5020开始。
lc.loc[(lc["grade"] == "B") & (lc["loan_amnt"] > 5000), ["member_id", "term" , "loan_amnt", "grade","sub_grade", "int_rate"]].sort(["loan_amnt"])
对多列筛选结果进行降序排序只需在前面升序排序代码的基础上增加ascending参数,并将值设定为False即可。下面是多列筛选后降序排序的代码和结果。
lc.loc[(lc["grade"] == "B") & (lc["loan_amnt"] > 5000), ["member_id", "term" , "loan_amnt", "grade","sub_grade", "int_rate"]].sort(["loan_amnt"],ascending=False)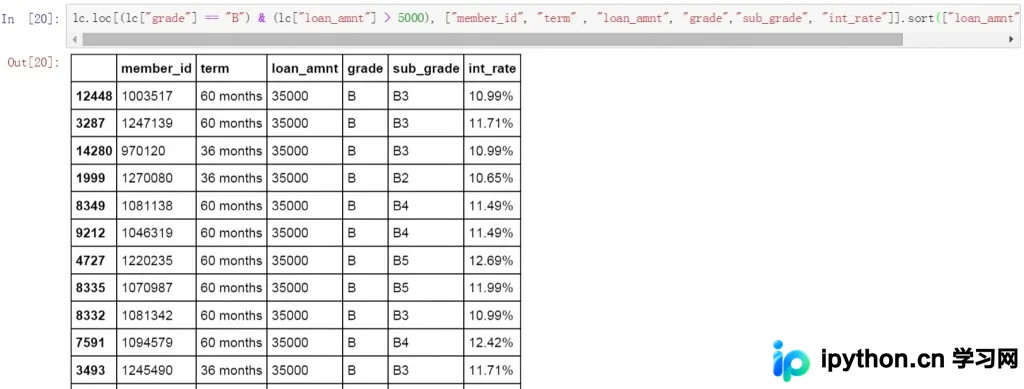
无论是“与”条件,还是“或”条件都可以在筛选后使用排序。下面代码是对使用了“或”逻辑条件的筛选结果进行降序排序的代码和结果。
lc.loc[(lc["grade"] == "B") | (lc["loan_amnt"] > 5000), ["member_id", "term" , "loan_amnt", "grade","sub_grade", "int_rate"]].sort(["loan_amnt"],ascending=False)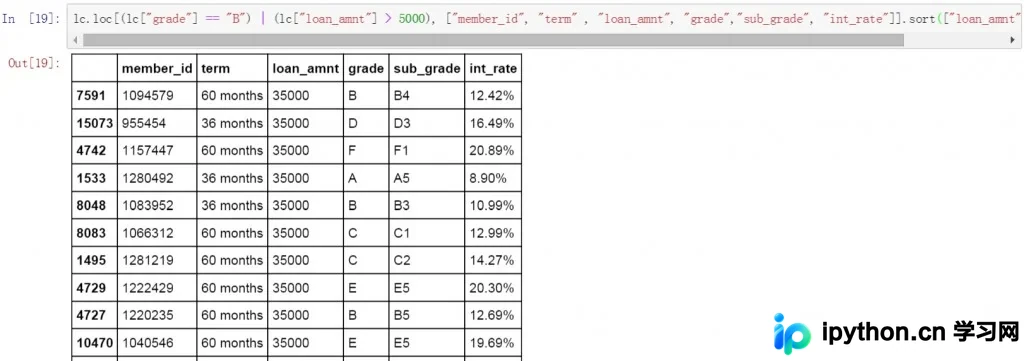
筛选后的聚合统计应用
Pandas中的排序和筛选基本介绍完毕。在实际的分析工作中,筛选只是分析过程中的一个步骤,很多时候我们还需要对筛选后的结果进行汇总,例如求和、计数或计算均值等。这对应于Excel中常用的sumifs和countifs函数。
按筛选条件求和(sumif, sumifs)
在单列筛选的代码后增加求和条件,就相当于Excel中sumif函数的功能。下面的代码在单列筛选的代码后增加了.loan_amnt.sum()的求和字段,表示对数据表中所有grade列值为B的loan_amnt金额求和。
lc.loc[lc["grade"] == "B",].loan_amnt.sum()
除了包含条件外,也可以对排除某一条件的数据求和。下面的代码与之前的正好相反,对数据表中所有grade列值不为B的loan_amnt金额求和。
lc.loc[lc["grade"] != "B",].loan_amnt.sum()
增加一个筛选条件就变成了Excel中sumifs函数的功能。下面的代码中分别使用了两个条件对数据表进行筛选,并对最后的loan_amnt金额进行求和。
lc.loc[(lc["grade"] == "B") & (lc["loan_amnt"] > 5000)].loan_amnt.sum()
按筛选条件计数(countif, countifs)
将前面的.sum()函数换为.count()函数,就变成了Excel中countif函数的功能。下面的代码对数据表中grade列值为B的loan_amnt笔数进行计数。
lc.loc[lc["grade"] == "B"].loan_amnt.count()
与前面代码相反,下面的代码对数据表中grade列值不为B的所有loan_amnt笔数进行计数。
lc.loc[lc["grade"] != "B"].loan_amnt.count()
增加筛选条件,就变成了Excel中countifs函数的功能。下面的代码对数据表中grade列值为B,并且loan_amnt金额大于5000的loan_amnt笔数进行计数。
lc.loc[(lc["grade"] == "B") & (lc["loan_amnt"] > 5000)].loan_amnt.count()
按筛选条件计算均值(averageif, averageifs)
有了sumifs和countifs,当然也少不了averageifs。在Pandas中.mean()是用来计算均值的函数,将.sum()和.count()替换为.mean(),就是pandas版的averageif和averageifs。下面的代码中计算了数据表中grade列值为B的loan_amnt金额均值,相当于Excel中averageif函数的功能。
lc.loc[lc["grade"] == "B"].loan_amnt.mean()
与前面的代码正好相反,下面的代码计算了数据表中所有grade列值不为B的loan_amnt金额均值。
lc.loc[lc["grade"] != "B"].loan_amnt.mean()
增加一个筛选条件变成了Excel中的averageifs,不过这里似乎有些不同。Excel中的sumifs、countifs和averageifs的计算逻辑是满足所有指定条件时,才对这些单元格进行求和或计数。而在下面的代码中我们使用了或条件,即只要满足两个条件中的任意一个都会进行计算。
lc.loc[(lc["grade"] == "B") | (lc["loan_amnt"] > 5000)].loan_amnt.mean()
按筛选条件获取最大值和最小值
最后两个是Excel中没有的函数功能,即对筛选后的数据表计算最大值和最小值。方法很简单,将之前的sum()和count()换成max()和min()函数即可。下面是具体代码和结果。
这条代码是计算数据表中grade列值为B的loan_amnt最大金额。
lc.loc[lc["grade"] == "B"].loan_amnt.max()
这条代码是计算数据表中grade列值不为B的loan_amnt最小金额。
lc.loc[lc["grade"] != "B"].loan_amnt.min()
以上这些也同样支持多条筛选后的计算,在此就不逐一列出了。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









