

Python Pandas 多列分组统计与结果转换详解

发布时间:2026-10-13| 4人浏览过
本文介绍如何利用Python Pandas库对数据集中多列元素进行分组统计。通过groupby()指定多列参数,结合size()计算出现频次,并将MultiIndex Series转换为包含自定义列名的DataFrame结构,实现高效的数据聚合分析。
单列统计与多列统计场景引入
首先明确本文的应用场景:假设存在一个DataFrame对象df,目标是统计其中某一列各元素的出现频次。此前在《如何画直方图》一文中已提及,利用value_counts()函数即可达成此目的,此处不再赘述。
接下来探讨另一种场景:若需统计数据集中两列元素共同出现的频次,具体示例如下。
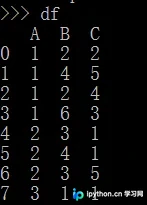
在df数据集中,若需统计A、B两列元素的组合出现情况,预期结果应呈现如下表格形式。
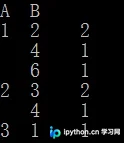
观察上述结果表的最后一列可知,在A、B两列的组合中,值为(1, 2)的组合出现了2次,(1, 4)出现1次,(1, 6)出现1次,(2, 3)出现2次,(2, 4)出现1次,(3, 1)出现1次。
Pandas多列分组统计实现
实现上述统计的具体代码逻辑如下。
import pandas as pd
df=pd.DataFrame([[1,2,2],[1,4,5],[1,2,4],[1,6,3],[2,3,1],[2,4,1],[2,3,5],[3,1,1]],columns=['A','B','C'])
gp=df.groupby(by=['A','B'])
gp.size()
因此,若需统计更多列的组合频次,只需在groupby()函数的by参数中追加相应的列名即可,例如统计三列的情况。
gp=df.groupby(by=['A','B','C'])通过gp.size()获取的结果是一个MultiIndex Series对象。
从Series到DataFrame的结构转换
随后,需将该Series转换为DataFrame结构以便进一步处理。
newdf=gp.size()
newdf.reset_index(name='times')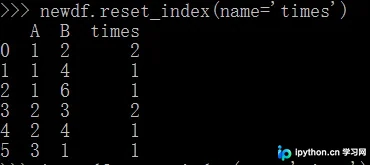
在转换过程中,可通过name参数为统计结果的列指定新名称,例如此处命名为“times”。
此时,newdf已转换为标准的DataFrame类型。
以上内容即为本文的全部讲解,希望对读者的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









