Python时间序列缺失值处理:日期填充实战指南
本文详细讲解在Python中利用Pandas处理时间序列数据时遇到的日期缺失问题。通过示例代码展示如何构建连续日期序列,并将原始数据映射至完整时间轴,实现缺失日期的自动填充与插值替换。适合需要进行时间序列分析且遇到数据预处理瓶颈的开发者参考。
2026-10-13
6

本文详细讲解在Python中利用Pandas处理时间序列数据时遇到的日期缺失问题。通过示例代码展示如何构建连续日期序列,并将原始数据映射至完整时间轴,实现缺失日期的自动填充与插值替换。适合需要进行时间序列分析且遇到数据预处理瓶颈的开发者参考。
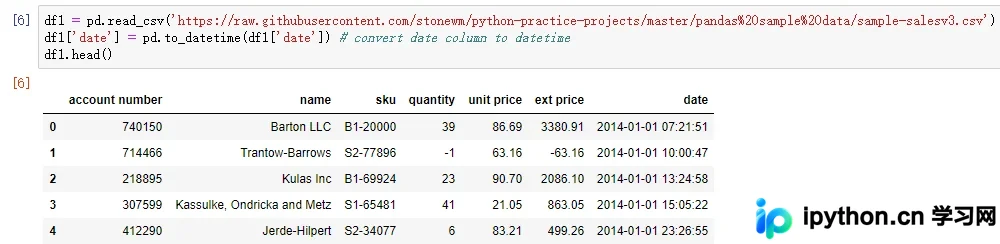
本文详解 pandas 中日期类型数据的处理流程,涵盖 Timestamp 与 datetime 的转换、read_csv 中 parse_dates 的使用,以及利用 dt 属性提取年月日信息。重点介绍通过 strftime 和 to_period 方法生成格式化周期字段,并结合 pivot_table 实现按月份、季度及年度的 SKU 销售金额统计,提供完整的代码示例与数据透视表生成步骤。
本文详解如何使用Python和Pandas库构建基于Item的简易推荐系统。通过加载MovieLens数据集,利用pivot_table生成用户-电影评分矩阵,并计算电影间的Pearson相关系数。文章涵盖数据清洗、阈值设定以过滤低评分数量电影,以及通过计算相似度进行电影推荐的具体代码实现与结果分析。
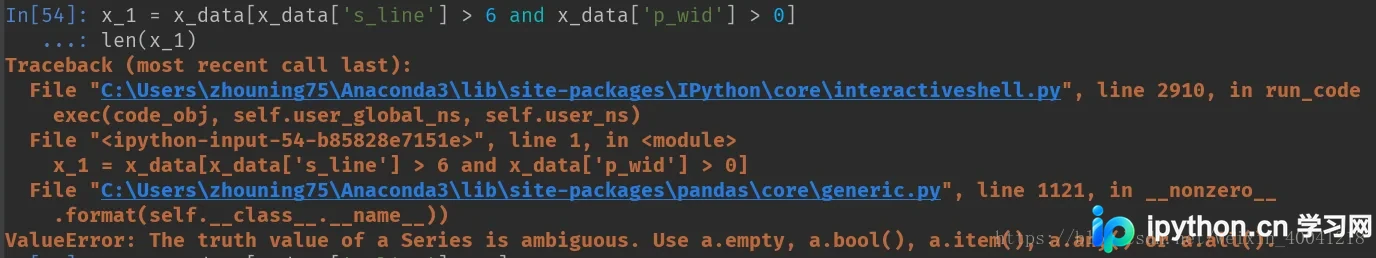
本文详解Python中(&, |)与(and, or)两组运算符的区别。数值变量下,前者执行位运算,后者依据非零值返回结果;逻辑变量下两者行为一致。重点指出在Pandas DataFrame多条件筛选时,必须使用&和|进行元素级逻辑运算,若误用and/or会引发ValueError。
本文总结了在Python Pandas中获取DataFrame列名的四种常用方法。包括使用列表推导式遍历、通过columns字段获取numpy数组、直接使用list关键字转换以及调用tolist()方法。每种方法均附带代码示例与结果说明,帮助开发者快速掌握不同场景下的列名提取技巧。
本文详解Python Pandas库中利用iloc、loc及icol选取特定列与行的方法。通过对比标签索引与位置索引的区别,解析切片操作后返回Series与DataFrame类型的差异,并演示多列数值计算的注意事项,帮助开发者避免常见类型错误。
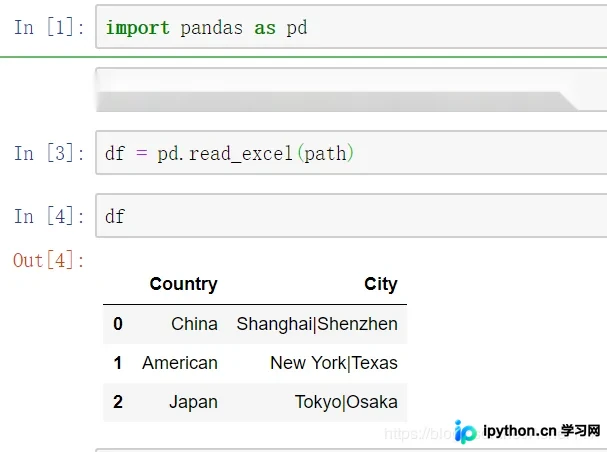
本文详解在Python Pandas中如何处理DataFrame的结构变换。重点讲解如何利用lambda函数将包含分隔符的单列拆分为多列,以及通过stack轴变换和join操作实现一行数据根据分隔符扩展为多行。内容涵盖两种常用拆分策略及其适用场景,帮助开发者高效完成数据预处理任务。
本文系统整理 Python pandas 库的核心用法,涵盖数据导入、信息查看、清洗(空值处理、格式转换)、预处理(合并、排序、条件判断)、提取与筛选、汇总统计(groupby、采样、相关性)及输出保存等全流程操作,提供实用代码示例。
本文详细介绍如何使用 pandas 的 drop 函数删除 DataFrame 中的指定行或列。通过设置 axis 参数区分操作对象,并重点讲解 inplace 参数在原地修改数据时的应用,同时提及不同 pandas 版本中参数用法的差异及注意事项。
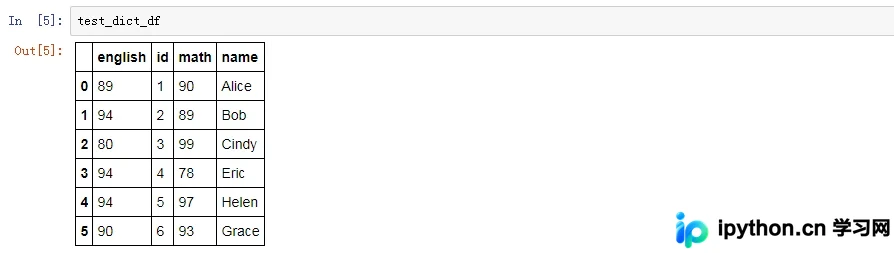
本文深入解析pandas库中drop_duplicates函数的核心参数subset、keep和inplace。通过具体代码示例,演示如何指定列进行去重、控制保留策略以及原地修改数据。同时指出直接赋值副本可能引发的SettingWithCopyWarning警告,并提供最佳实践建议,帮助开发者高效处理DataFrame重复行问题。
本文详细介绍Python中读写CSV文件的多种方法,包括使用csv模块和pandas库。重点讲解如何在现有CSV文件中增加新的列(如label和is_cc)并写入数据,同时提供解决writerows产生多余空行的技巧。内容涵盖基础代码实现、数据框操作及常见错误排查,适合需要处理结构化数据的开发者参考。
本文介绍如何利用Python的Pandas库高效处理超过140MB、170万行的CSV文件。对比MySQL导入卡顿和R语言加载缓慢的问题,展示Pandas在快速读取、列操作、分组聚合及生成透视表方面的优势,并提供完整的代码示例与处理流程。