

详解将Pandas中的DataFrame类型转换成Numpy中array类型的三种方法
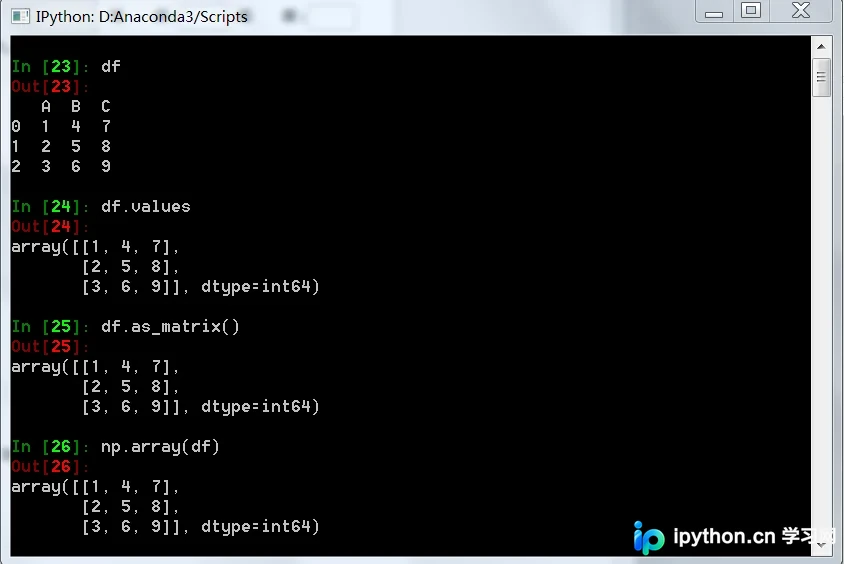
本文介绍了在Python数据分析中,将Pandas DataFrame转换为Numpy array的三种常用方法。通过导入必要的模块并创建示例数据,详细演示了使用values属性、as_matrix()函数以及np.array()函数的具体操作。这三种方法均能实现类型转换,适用于不同的数据处理场景。
2026-10-13
9

本文介绍了在Python数据分析中,将Pandas DataFrame转换为Numpy array的三种常用方法。通过导入必要的模块并创建示例数据,详细演示了使用values属性、as_matrix()函数以及np.array()函数的具体操作。这三种方法均能实现类型转换,适用于不同的数据处理场景。
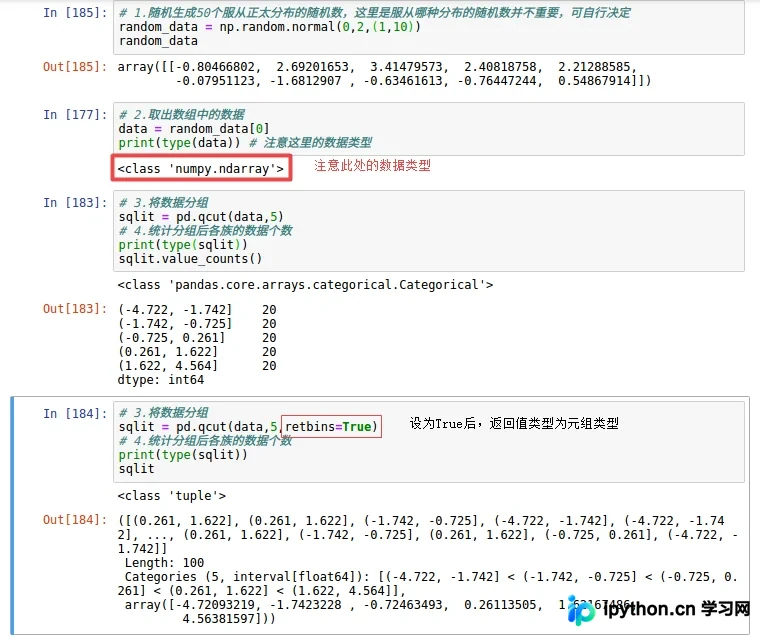
本文详细介绍pandas库中qcut()函数的用法,包括如何按分位数对数据进行分组、自定义标签及处理边界情况。同时对比qcut与cut的核心区别:qcut按组数自动计算区间,cut需指定具体区间边界。
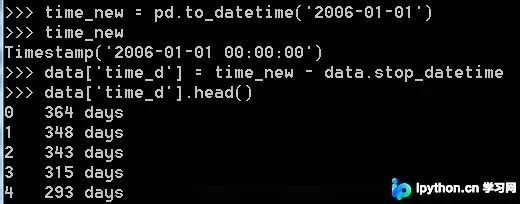
本文介绍如何使用Python Pandas库进行时间数据的转换、计算时间差以及提取年月日信息。通过pd.to_datetime函数将字符串转换为日期时间格式,利用dt属性提取年、月、日,并计算两个时间点之间的差异。此外,还展示了如何基于时间序列数据进行分组统计和绘图分析,帮助读者掌握Pandas在时间数据处理中的核心技巧。
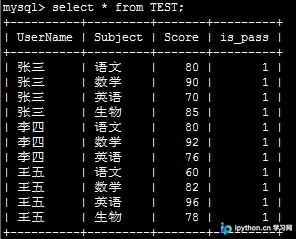
本文详细解析Pandas中DataFrame的行转列操作,重点对比pivot与unstack两种方法。通过示例展示如何利用pivot快速重塑二维表格,并深入探讨基于层次化索引的unstack实现原理。文章包含完整代码示例及MySQL数据交互场景,帮助开发者掌握数据重塑技巧。
本文深入解析pandas中的Series数据类型,涵盖由列表、NumPy数组及字典创建Series的多种方法。详细阐述Series的索引机制、与数组的区别,以及shape、index、values等核心属性。同时介绍非空值过滤、name属性设置及isnull/notnull等常用操作,帮助开发者高效掌握Series数据结构。
本文详细介绍 pandas 中层次化索引(MultiIndex)的创建、数据选取、排序及重塑方法。涵盖 Series 和 DataFrame 的多级索引构建,演示 swaplevel、sortlevel 及 set_index/reset_index 等核心函数的具体用法,帮助开发者高效处理复杂数据结构。
本文介绍在Python中利用pyecharts和pandas库绘制平行坐标图的两种方法。通过Iris数据集示例,对比两种工具在颜色分类和坐标轴独立性方面的表现,指出当前实现中存在的局限性,并提供相关代码参考。
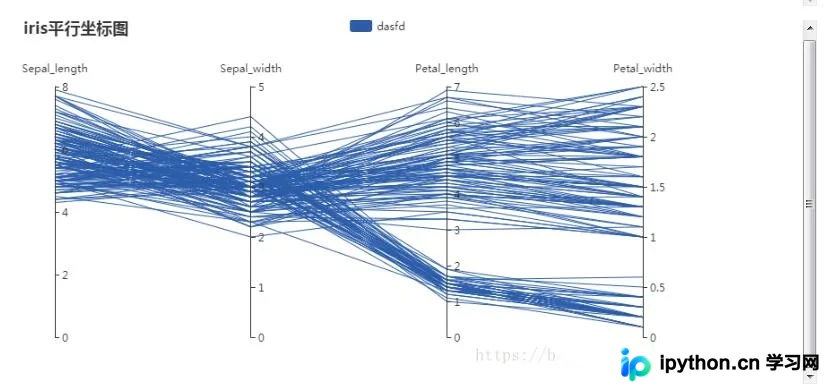
本文介绍利用pandas库中的drop_duplicates方法提取重复数据的技巧。通过分别执行keep=False和keep='first'两种去重操作,获取完全去重与保留首条记录的差异结果,进而通过合并与再次去重找出所有重复项。
本文通过具体代码示例,演示如何利用pandas库对销售数据进行区间划分(分箱)并计算各区间频率。主要涉及pd.cut函数的区间设置、value_counts统计频数,以及通过DataFrame操作计算频率百分比与累计频率,最终结合matplotlib生成条形图可视化结果。
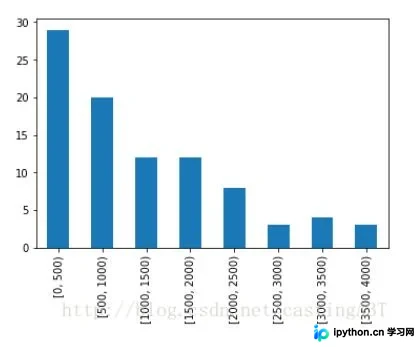
本文详细介绍Pandas中用于数据分析的累积计算(cum系列)与滚动计算(rolling系列)函数。cum系列作为DataFrame或Series的方法,用于生成前n项的累计和、积、最大值等;rolling系列则通过指定窗口大小k,对数据进行滑动窗口统计,如计算滚动均值、方差等。文章提供了具体的代码示例和输出结果,帮助开发者掌握这两种常用统计技巧。
本文介绍Python中Pandas库的核心数据结构Series和DataFrame。Series是一维带标签数组,支持列表和字典创建;DataFrame是二维表格型数据,支持嵌套列表和字典实例化。文章通过代码示例演示了如何创建对象、设置自定义索引及列名,帮助初学者快速掌握Pandas基础用法。
本文详解Python Pandas库中处理时间序列的核心函数。重点解析pd.date_range()生成时间索引的参数配置,包括start、end、freq等;介绍pd.to_datetime()将字符串转换为时间戳的方法;并演示如何利用DateOffset进行灵活的时间加减运算,涵盖天、月、年及组合偏移量的实际应用。