

Python实现基于信息增益的决策树算法详解
本文介绍了一种使用Python实现的基于信息增益的决策树归纳方法。通过加载属性、训练数据和类别描述文件,构建决策树节点并进行分类测试。代码展示了如何计算信息增益以选择最优分裂属性,并评估分类器的准确率。适合对机器学习和决策树算法感兴趣的开发者参考。
2026-10-13
6

本文介绍了一种使用Python实现的基于信息增益的决策树归纳方法。通过加载属性、训练数据和类别描述文件,构建决策树节点并进行分类测试。代码展示了如何计算信息增益以选择最优分裂属性,并评估分类器的准确率。适合对机器学习和决策树算法感兴趣的开发者参考。
本文详细介绍如何在Python中利用scikit-learn库封装K近邻(KNN)算法。内容涵盖环境准备、核心代码实现及预测流程,重点解析无需显式训练过程但需拟合数据的特性,并提供完整的分类器封装与测试代码示例,帮助开发者快速掌握KNN在机器学习中的应用。
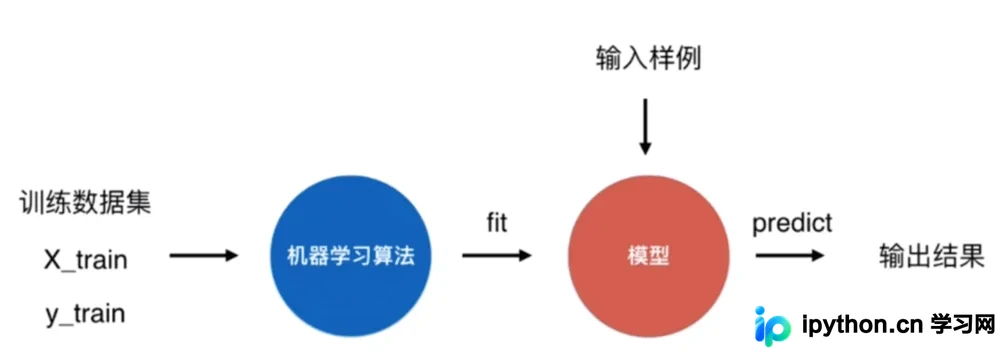
本文介绍如何使用Python的sklearn库中的train_test_split函数,将数据集按比例随机划分为训练集和测试集。文章详细解析了该函数的参数用法、返回值含义,并对比了直接传入特征标签与传入含标签数据框的不同处理方式,最后提供了一个自定义划分函数的实现示例,帮助开发者掌握数据预处理的核心技巧。
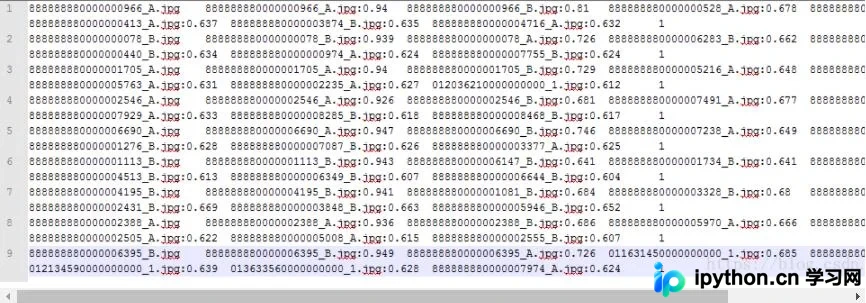
本文介绍利用Python脚本批量处理人脸测试数据的方法。通过读取文本文件,提取每行Top 7图片对应的评分数据,并将第二高评分与0.7阈值比较。超过阈值标记为正样本1,否则为0,最终保存为可直接用于机器学习模型训练的格式文件。
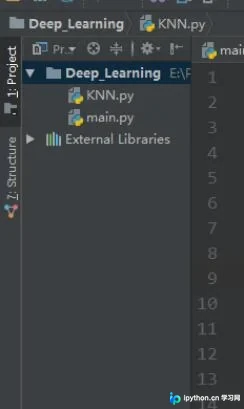
本文介绍如何在PyCharm中高效使用调试功能。通过创建包含算法模块的KNN.py及主程序main.py,重点讲解在main.py中利用__name__ == '__main__'构建测试入口,并在KNN.py中设置断点。启动Debug模式后,程序将自动进入断点,支持单步执行以观察具体运行步骤,从而快速定位并解决代码问题。
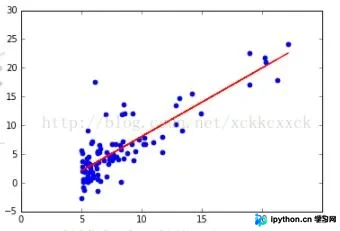
本文介绍如何利用Python的sklearn库实现单变量线性回归。通过读取数据文件,使用LinearRegression进行模型训练,并展示预测与可视化结果。重点解析fit、predict及score方法的应用,适合机器学习初学者参考。
本文详细介绍在 Python 中导入 CSV 文件的三种常用方法。首先通过标准库 csv 结合 NumPy 数组处理基础数据;其次利用 NumPy 的 loadtxt 函数处理无表头且类型统一的数据;最后重点推荐 Pandas 库的 read_csv 函数,因其返回 DataFrame 结构,便于后续数据清洗与机器学习建模,是实际开发中的首选方案。
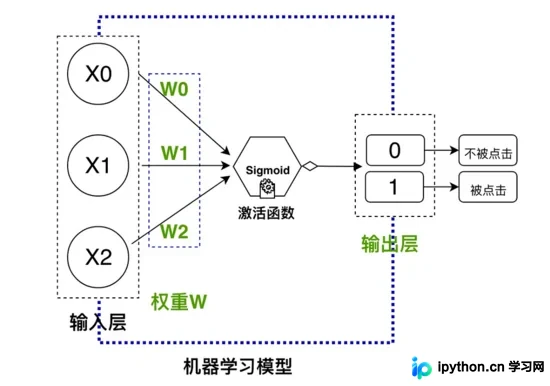
本文从零开始,仅使用Python基础库NumPy构建一个极简的前馈神经网络(即单层逻辑回归),用于解决微博点击率预估问题。通过解析数据预处理、Sigmoid激活函数、前向传播及反向传播权重更新等核心步骤,帮助初学者深入理解监督学习中分类模型的训练原理与代码实现。
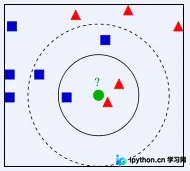
本文深入解析Python中KNN(K近邻)分类算法的核心原理,包括距离计算、K值选择及K-D Tree与Ball-Tree优化策略。通过身高体重数据集的完整代码示例,展示如何使用scikit-learn实现分类,并详细解读准确率、混淆矩阵及决策边界可视化结果,帮助开发者掌握该基础且强大的分类模型。
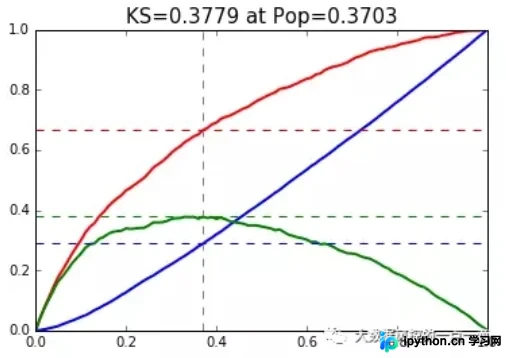
本文详细介绍如何使用Python绘制KS曲线以评估模型区分能力。通过提供完整的PlotKS函数代码,展示如何根据预测分数和标签计算累计分布,并生成包含KS值的可视化图表。该方法适用于信用评分及二分类模型的性能分析,帮助开发者直观理解模型表现。
本文详解Python中离散变量One-Hot编码的两种主流实现方式。通过对比pandas的get_dummies与sklearn的LabelEncoder结合OneHotEncoder,解析字符串与数值型变量的处理差异。文章包含具体代码示例,展示从数据导入、特征查看到编码生成的完整流程,帮助开发者根据数据类型选择合适方案。
本文详解Python中sklearn库的One-Hot编码技术。阐述将离散特征映射至欧式空间以优化距离计算的原理,并通过具体代码示例解析OneHotEncoder的使用,包括fit与transform方法的输出结果及维度分析,帮助开发者掌握特征预处理技巧。