

Python实现神经网络感知器算法详解
本文介绍了如何使用Python代码实现神经网络中的感知器算法。通过具体的代码示例和运行结果,详细解析了感知器的工作原理及实现步骤,帮助读者深入理解机器学习基础算法。
2026-10-13
6

本文介绍了如何使用Python代码实现神经网络中的感知器算法。通过具体的代码示例和运行结果,详细解析了感知器的工作原理及实现步骤,帮助读者深入理解机器学习基础算法。
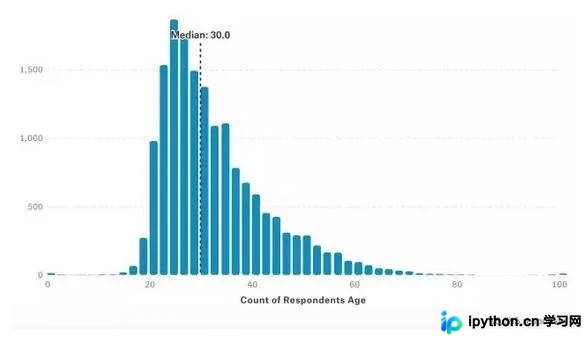
Kaggle发布2017年机器学习调查报告,覆盖16000+受访者。数据显示Python为最主流编程语言,R语言在统计学领域保持高忠诚度。全球从业者平均年龄30岁,中国从业者中位数仅25岁。报告还揭示了脏数据处理、算法理解及资金管理等主要职业挑战,并指出同时使用Python和R的用户更倾向推荐Python。
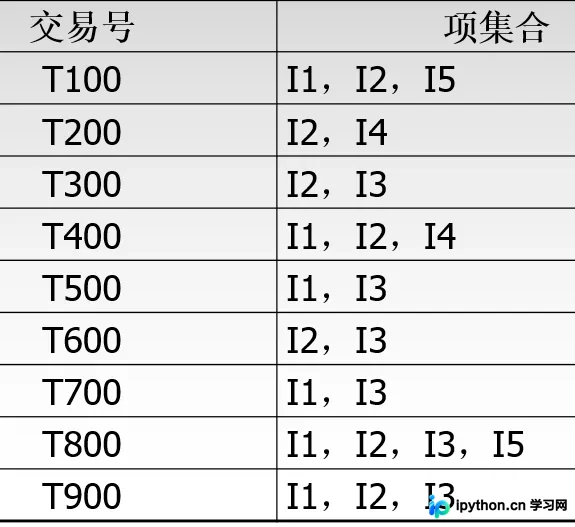
本文深入解析Apriori算法原理及其在Python中的具体实现。文章详细阐述了通过逐层搜索生成频繁项集的过程,包括连接与剪枝两个核心步骤,并结合交易数据实例演示了C1至L1、L2至C3的迭代逻辑。最后提供了完整的Python代码示例,展示如何利用NumPy和itertools库计算支持度并筛选频繁项集,帮助读者掌握关联规则挖掘的核心技术。
本文系统梳理了Python在数据获取、处理、计算及挖掘领域的核心工具。涵盖Scrapy、Beautiful Soup等爬虫框架,NLTK、Jieba等NLP库,NumPy、SciPy等科学计算基础,以及scikit-learn、Theano等机器学习与深度学习框架,为开发者提供一站式选型参考。
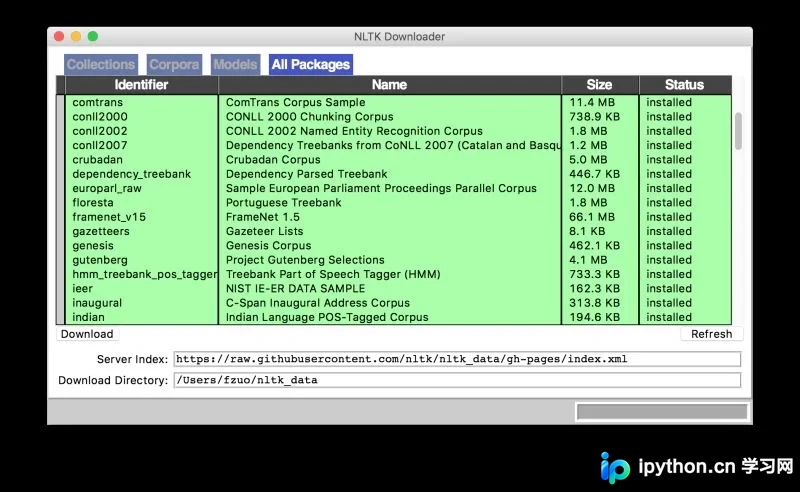
本文详解Python中NLTK库的基础应用,涵盖环境配置、分句与分词操作。重点解析WordPunctTokenizer与regexp_tokenize的使用,并针对NLTK 3.1+版本中compile_regexp_to_noncapturing废弃导致的兼容性问题,提供修正后的正则分词代码方案,帮助开发者高效进行文本预处理。
本文深入探讨Python在人工智能领域的核心地位,对比Lisp、Prolog、C/C++及Java等语言的优劣,重点分析Python在文档、跨平台、易用性及开源生态方面的优势。同时列举AIMA、scikit-learn、NLTK等主流AI库,并通过员工情绪分析案例展示Python在物联网与AI结合场景下的实际应用价值。
本文深入解析基于概率论的朴素贝叶斯分类算法。从贝叶斯定理与条件概率基础入手,阐述核心决策理论,并详细演示在Python中构建词向量、计算特征概率及训练分类器的完整流程。通过社区留言过滤案例,展示如何处理标称型数据,帮助读者掌握这一高效的多类别分类方法。
本文介绍使用Python3和numpy库实现基于反向传播算法的人工神经网络。通过正弦函数拟合任务,展示如何构建训练集、调整学习速率及隐藏层参数,并验证模型效果。代码包含完整的网络定义与训练逻辑,适合深度学习入门参考。
OpenCV 是由 Intel 发起、Willow Garage 支持的跨平台开源计算机视觉库,基于 BSD 许可。它提供轻量级高效的 C/C++ 核心及 Python 等语言接口,涵盖图像处理和机器视觉算法。本文介绍其历史、架构、免费特性及在安防、医疗等领域的应用,并附相关学习资源。
本文基于Python scikit-learn库,通过波士顿房价数据集演示线性回归算法的完整应用流程。内容涵盖数据导入、特征工程、模型构建及预测评估,详细解析如何加载内置数据、探索特征分布、拟合线性回归模型并计算均方误差,为初学者提供从理论到代码落地的清晰指引。
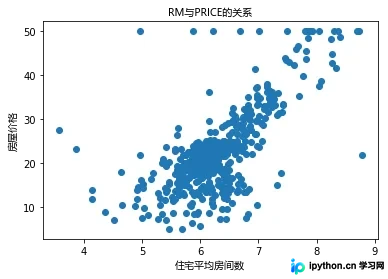
本文介绍如何利用Python的numpy库灵活定义神经网络结构。通过设置dtype=object,可动态管理不同层级的节点数、权重及偏置。文中提供了三层及五层网络的定义示例,并展示了基于斯坦福教程的完整实现代码,涵盖初始化、拟合及预测流程,适用于希望深入理解神经网络底层逻辑的开发者。
本文介绍Python中处理非数值类别数据的三种方法:使用LabelEncoder快速转换、通过字典映射手动指定数值,以及利用get_dummies生成虚拟变量。内容涵盖具体代码实现与适用场景,帮助开发者高效完成数据预处理。