

Python批量抽取文本文件评分数据并生成训练样本

发布时间:2026-10-13| 5人浏览过
本文介绍利用Python脚本批量处理人脸测试数据的方法。通过读取文本文件,提取每行Top 7图片对应的评分数据,并将第二高评分与0.7阈值比较。超过阈值标记为正样本1,否则为0,最终保存为可直接用于机器学习模型训练的格式文件。
对于刚接触Python的新手而言,编写脚本处理数据时往往需要频繁查阅各种语法细节,过程充满挑战。这段经历值得记录与分享。
原始数据的格式结构如下图所示:
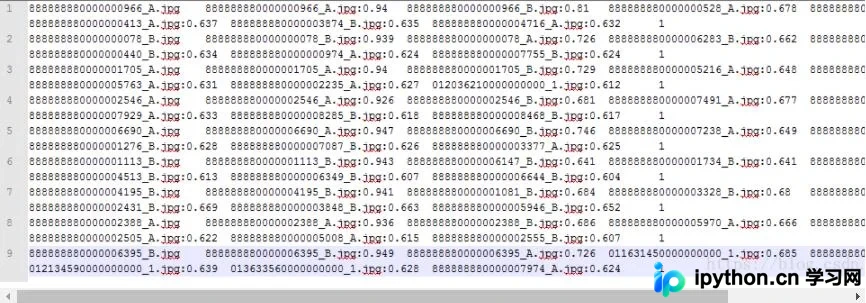
该数据集为人脸测试数据,每行记录包含一个测试图片编号,随后跟随Top 7相似图片的编号及其对应的相似度评分。任务目标是从每行中提取这7个评分数据,并重点判断第二个评分值是否达到预设阈值0.7。若评分高于或等于0.7,则判定此次测试成功,标记为正样本(值为1);否则标记为负样本(值为0)。最终将这些处理后的结果保存至新的文本文件,作为机器学习模型的训练样本。
经过Python脚本处理后,生成的文件格式示例如下:
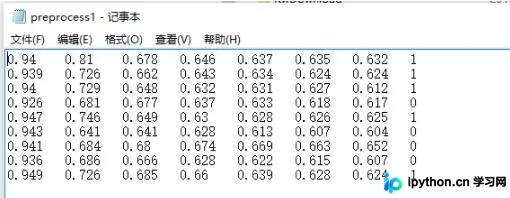
实现该功能的具体Python代码如下,其中包含详细的注释说明,适合初学者参考:
# -*- coding: cp936 -*-
import re
import linecache
filename = 'face_test_data.txt'

with open(filename, 'r') as f:
 line = f.readline()
 while line:
  eachline = line.split()###按行读取文本文件
  #print eachline 返回一个列表,以空格作为元素拆分标识
  #print line 返回的是一整行数据,相当于一个字符串元素
  count = len(eachline)#返回列表长度,即列表元素数目
  n = 0
  element = []#初始化空列表用于存储所需评分数据
  while n < count:
   elem_index = eachline[n:n+1] #类型为列表
   #print elem_index, len(elem_index[0])
   #print elem_index 返回类型为列表
   if len(elem_index[0]) > 24:
    element.append(elem_index[0][25:])
   #element = [qiege(elem_index[n]) for elem_index in eachline]
   n=n+1
  #print element[1] #概率数值列表

  if element[1] >= '0.7':
   element.append(1)
   #print '1'
  else:
   element.append(0)
   #print '0'

  #生成每行末尾有\t文件
  '''
  file = open('preprocess.txt', 'a')
  for i in range(len(element)):
   file.write(str(element[i])+'\t')
  file.write('\n')
  file.close()
  '''
  #生成每行末尾无\t文件,可直接用于np.loadtxt()读取文本生成矩阵数据
  file = open('_preprocess.txt', 'a')
  for i in range(len(element)-1):
   file.write(str(element[i])+'\t')
  file.write(str(element[-1])+'\n')
  #file.write('\n')
  file.close()

  line = f.readline()
以上即为Python批量抽取文本文件内容并生成训练样本的完整实例,希望能为读者提供有益参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









