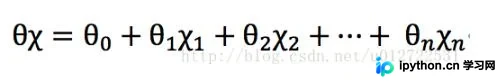8种常用的Python工具:从开发到数据科学的完整指南
本文介绍了8种最常用的Python工具,涵盖开发、自动化测试、数据科学与机器学习领域。包括内置的IDLE、机器学习的Scikit-learn、深度学习的Theano、自动化的Selenium与Test Complete,以及数据处理的Beautiful Soup、Pandas和线性规划工具PuLP。这些工具能显著提升开发效率与数据处理能力。
2026-10-14
6

本文介绍了8种最常用的Python工具,涵盖开发、自动化测试、数据科学与机器学习领域。包括内置的IDLE、机器学习的Scikit-learn、深度学习的Theano、自动化的Selenium与Test Complete,以及数据处理的Beautiful Soup、Pandas和线性规划工具PuLP。这些工具能显著提升开发效率与数据处理能力。
学习Python对电脑配置要求因方向而异。基础语法和Web开发普通办公电脑即可;大数据开发需大内存(至少8G)以支持虚拟机集群;AI与深度学习需高性能GPU(如1080Ti或更高)及强劲CPU。建议根据学习阶段选择合适硬件,并预留升级空间。
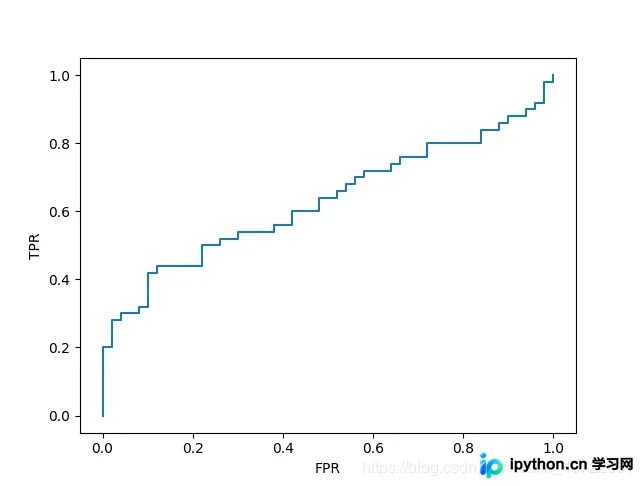
本文详细解析如何使用Python绘制ROC曲线。以鸢尾花数据集为例,通过回归拟合获取概率值,对测试数据进行排序,并基于TPR和FPR公式计算真阳性率与假阳性率。文章涵盖从数据预处理、模型预测到最终绘图的全过程,帮助读者理解分类模型的性能评估方法。
本文详细解析Python sklearn库中model.predict()与model.predict_proba()函数的核心区别。通过LogisticRegression示例代码,展示predict返回具体分类标签,而predict_proba返回各类别的概率分布。文章深入探讨了多分类场景下的概率输出逻辑,并解释了predict_proba结果如何依据self.classes_进行排序,帮助开发者准确理解模型输出格式。
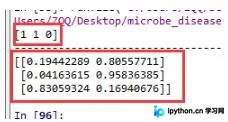
本文详解sklearn中predict与predict_proba的区别:前者返回预测标签,后者返回各类别概率数组。重点指出当训练集缺失某些类别时,predict_proba列数会减少,导致predict结果与最大概率索引不一致。建议使用train_test_split的stratify参数保持数据分布一致,避免此类隐蔽Bug。
本文详解在深度学习训练中如何使用Keras进行数据切分,包括通过validation_split自动切分验证集和结合Sklearn手动指定验证集两种方法。同时深入解析K折交叉验证原理,展示利用StratifiedKFold进行分层抽样的完整代码示例,并厘清训练集、验证集与测试集的核心区别,帮助开发者更准确地评估模型泛化能力。
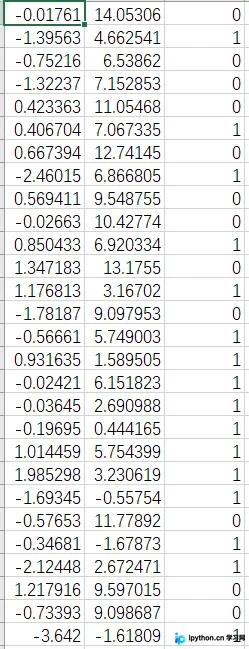
本文通过Python代码演示如何利用sklearn库实现线性与非线性逻辑回归。文章首先介绍线性逻辑回归在简单数据集上的建模、拟合及评估过程,随后深入讲解非线性逻辑回归中通过多项式特征扩展决策边界的方法。对比两者在代价函数与预估函数复杂度上的异同,并展示高准确率的分类结果,帮助读者掌握sklearn在分类任务中的核心应用。
本文介绍Python读取HDFS上Parquet格式数据的多种方案,包括hdfs3、hdfs和pyhdfs库的使用及HA配置。同时提供PySpark中利用coalesce函数合并小文件、优化存储效率的实用代码示例。
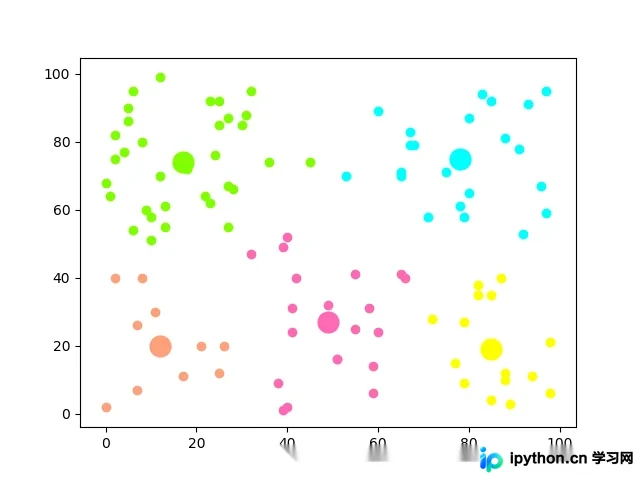
本文详细解析 k-means 聚类算法的核心思想,涵盖从随机初始化聚类中心到迭代更新均值的完整流程。通过 Python 代码展示如何利用 numpy 和 matplotlib 实现聚类过程及结果可视化,帮助开发者理解算法逻辑并快速上手应用。
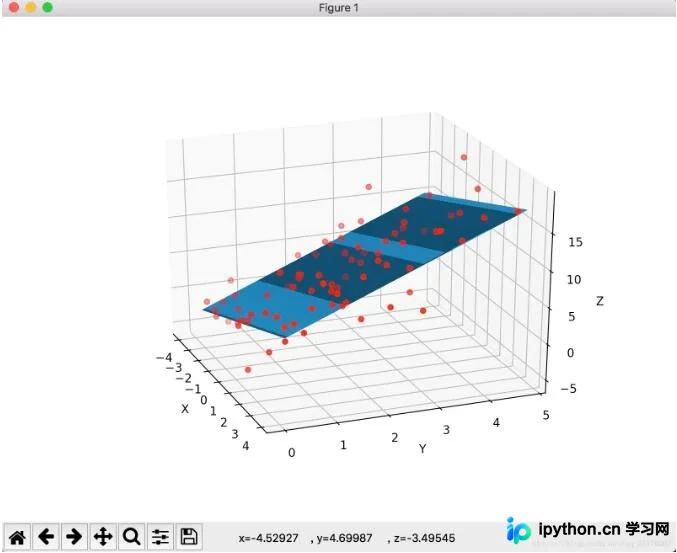
本文介绍如何利用Python3的Axes3D库绘制三维线性回归模型。通过生成两个不相关的特征数据,使用最小二乘法求解参数,并绘制网格曲面与散点图,直观展示机器学习算法的建模过程。
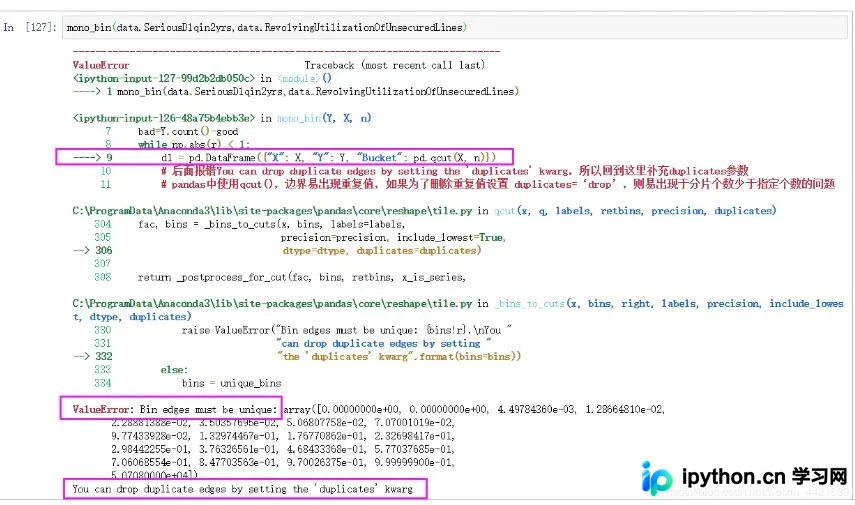
本文详细解析pandas.cut与pandas.qcut两个函数的参数与区别,涵盖等宽与等深分箱原理。针对信用风控建模中常见的qcut边界重复报错,提供设置duplicates='drop'的解决方案,并展示变量离散化及WOE计算的实际代码示例。
本文基于吴恩达机器学习课程,使用Python实现了Logistic分类算法。详细阐述了如何通过Sigmoid函数将线性回归输出映射至0-1区间,并定义了代价函数。通过梯度下降法迭代优化参数theta,最终给出完整的Python实现代码及运行结果,帮助读者理解二分类问题的数学原理与编程实践。