Python基于LightGBM进行时间序列预测:LazyProphet实战解析
本文介绍如何使用Python中的LazyProphet库结合LightGBM进行高效的时间序列预测。通过特征工程如傅里叶基函数和滞后值,该模型在M4数据集上超越了传统树模型基准,且无需复杂调参即可实现快速建模与预测,适合高频大数据场景。
2026-10-16
6

本文介绍如何使用Python中的LazyProphet库结合LightGBM进行高效的时间序列预测。通过特征工程如傅里叶基函数和滞后值,该模型在M4数据集上超越了传统树模型基准,且无需复杂调参即可实现快速建模与预测,适合高频大数据场景。
本文深入解析最小二乘法的两种核心推导路径:基于代价函数偏导数的代数解法,以及基于向量到子空间距离的几何解释。通过Python与MATLAB代码对比,验证了自定义实现与内置函数polyfit、regress在多项式拟合及多元线性回归中的一致性,展示了从理论到工程应用的完整闭环。
本文详解Python中异常值的定义及两种主流检测方法:基于正态分布的3σ原则和基于四分位距的箱型图法。通过Pandas库对啤酒数据集进行实战演练,展示如何定位并处理如abv字段中的极端离群值,提供完整的代码实现与索引定位技巧,帮助开发者掌握数据清洗核心技能。
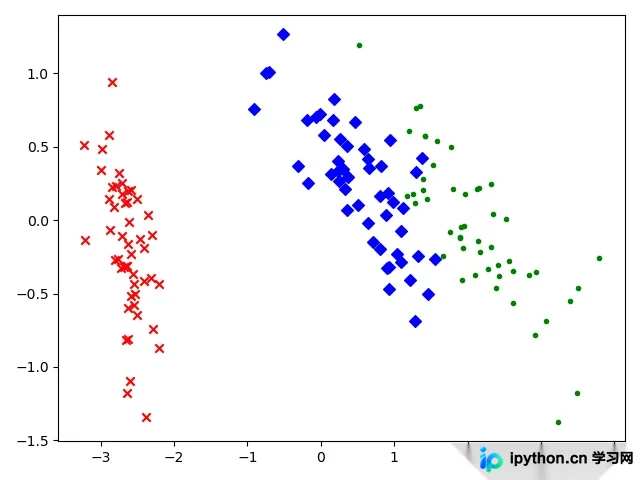
本文详细介绍基于Python的K-Means聚类算法实现。作为典型的无监督学习算法,K-Means通过计算对象间距离来划分紧凑且独立的簇。文章提供了完整的Python代码示例,涵盖算法初始化、迭代优化及可视化预测过程,帮助开发者快速掌握该核心聚类技术。
本文详细介绍Python中PCA降维的两种实现方式。首先解析PCA将高维数据投影到低维空间以保留最大信息量的原理及标准步骤,随后通过矩阵运算手动实现PCA,并对比使用sklearn库中PCA算法的调用方法。文章涵盖代码解析、可视化结果分析及重构误差说明,帮助开发者掌握特征降维技术。
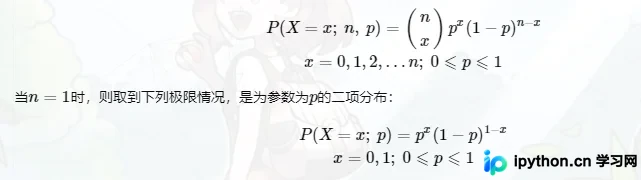
本文深入探讨Python中从概率分布采样的方法,重点介绍二项、伯努利、多项、均匀及狄利克雷分布。通过具体代码示例,解析各分布的参数设置、函数原型及在实际机器学习场景中的应用,如样本分配与权重生成,帮助开发者掌握核心采样技巧。
本文深入解析Python中的随机采样机制,涵盖random模块与numpy库的核心函数。详细对比random.choice、random.choices(支持权重与有放回)及random.sample(无放回)的使用场景,并介绍基于Random实例的采样方法。同时解析numpy.random.choice的参数配置,包括权重、大小及替换选项,助你在机器学习数据预处理中精准控制采样逻辑。
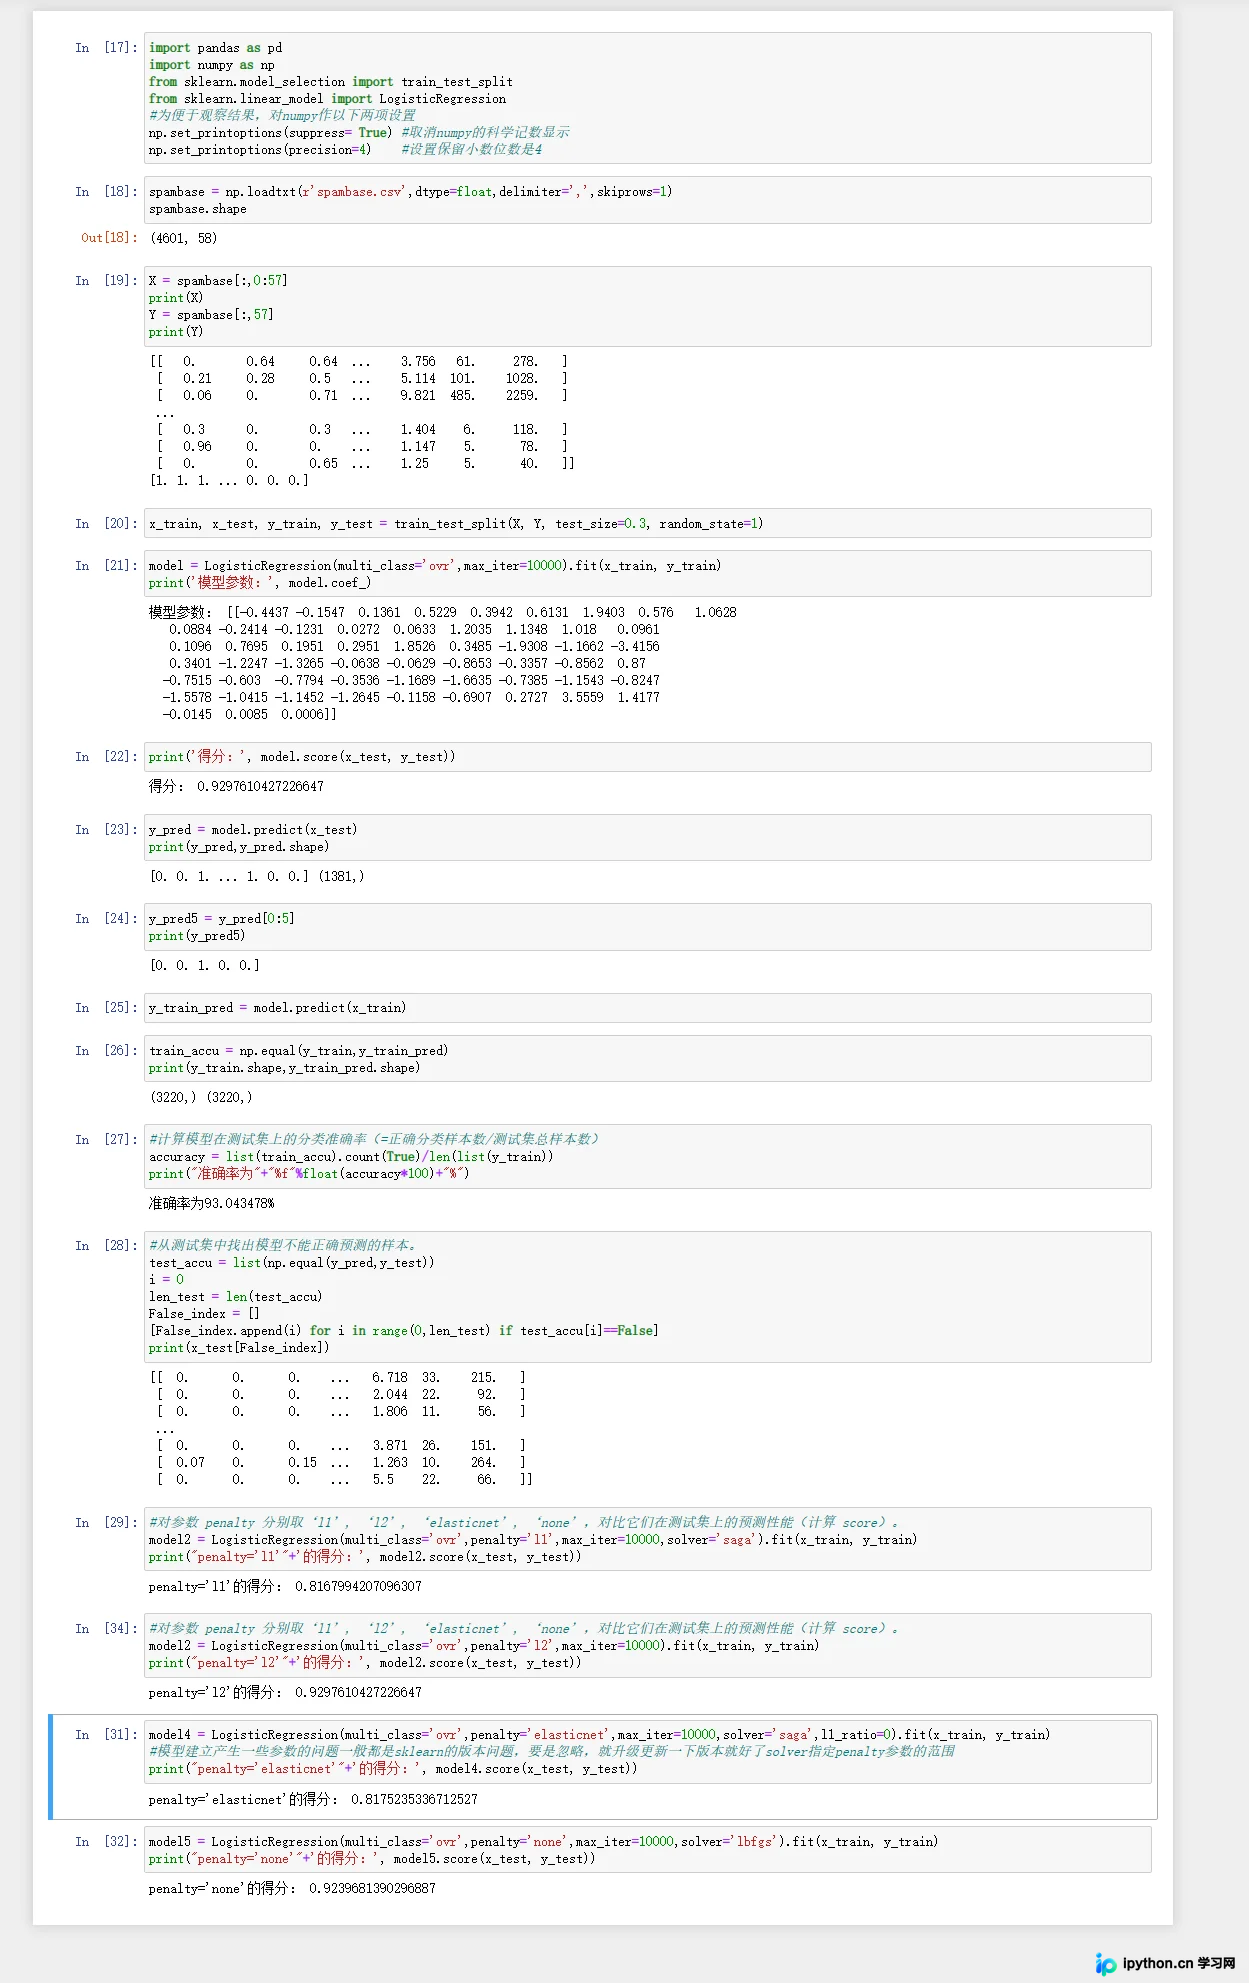
本文详细介绍如何使用Python和逻辑回归算法对垃圾邮件数据集进行分类。内容涵盖数据预处理、训练集与测试集划分、模型构建及参数调优。通过对比l1、l2、elasticnet和none等不同惩罚项对模型性能的影响,并计算分类准确率及错误样本,帮助读者掌握逻辑回归在文本分类中的实际应用。
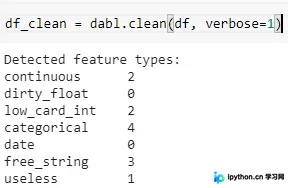
dabl是Python开源数据分析基线库,通过几行代码自动完成数据预处理、特征可视化及基线模型训练。本文介绍其核心功能,包括自动识别数据类型、执行探索性数据分析(EDA)及返回最佳预测模型,旨在简化机器学习开发流程。
本文深入解析Python机器学习中的随机梯度下降法(SGD)。对比全批量梯度下降法,阐述SGD在计算效率与稳定性上的权衡。通过美国问答社区数据预测案例,展示使用NumPy和Pandas实现SGD的完整代码流程,包括数据预处理、参数初始化及模型评估,帮助开发者掌握优化算法的实际应用。
本文详解Python中K近邻算法(KNN)的核心原理、优缺点及API调用方法。通过预测酒店入住位置的完整案例,演示从数据清洗、时间特征工程、标准化到模型训练与评估的全流程,帮助开发者掌握KNN在小规模数据集上的实际应用。
本文介绍在Python中使用Pandas库对两个表格进行内容模糊匹配的方法。方法一通过全连接后筛选,逻辑简单但内存消耗大;方法二利用字典遍历,适合大数据集。文章提供了具体的代码实现、步骤解析及结果展示,帮助开发者高效处理文本匹配任务。