

Python实现PCA降维:手动矩阵运算与sklearn调用详解

本文详细介绍Python中PCA降维的两种实现方式。首先解析PCA将高维数据投影到低维空间以保留最大信息量的原理及标准步骤,随后通过矩阵运算手动实现PCA,并对比使用sklearn库中PCA算法的调用方法。文章涵盖代码解析、可视化结果分析及重构误差说明,帮助开发者掌握特征降维技术。
前言
PCA(主成分分析)降维通常应用于数据分析与机器学习领域。其核心作用是在尽可能保留原始数据最大信息量的前提下,将高维数据映射到低维空间。通过提取对数据影响最大的主成分分量,PCA有助于简化数据结构,为后续的数据分析与建模操作奠定基础。
在机器学习任务中,进行预测时往往需要进行特征构建,包括不同特征之间的相乘、相加等组合操作,从而扩充特征集。数据处理完成后,每个样本可能包含大量特征。若将所有特征直接输入模型,可能导致预测效果不佳。高维数据集中,部分特征具有预测能力,而许多特征仅包含噪音或彼此高度相关,这些因素会降低模型精度并延长训练时间。降低数据集维度可在一定程度上缓解上述问题,此时PCA降维便成为有效手段。
假设原始数据集包含500个特征,通过PCA降维至400个特征后,可使用这400个新特征替代原始500个特征输入模型,从而提升预测性能。需要注意的是,降维得到的400个特征是原始高维数据在低维空间平面上的投影,能够反映原特征的大部分信息,而非从原有500个特征中直接筛选出的子集。
PCA降维的一般执行步骤如下:
1. 对原始数据进行标准化处理(通常包括去均值;若特征量级差异较大,还需除以标准差进行缩放)。
2. 计算标准化后数据集的协方差矩阵。
3. 计算协方差矩阵的特征值与特征向量。
4. 保留特征值最大的前k个特征(k即为降维后的目标维度)。
5. 提取这k个特征值对应的特征向量。
6. 将标准化后的数据集乘以这k个特征向量,得到降维后的结果。
实现PCA降维主要有两种方法:
首先说明代码中使用的数据集背景:
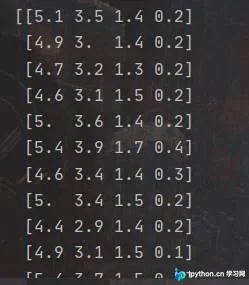
以下两个代码示例均使用sklearn库自带的iris(鸢尾花)数据集。该数据集包含150个样本,每个样本具有四个属性特征(花萼长度、花萼宽度、花瓣长度、花瓣宽度)以及一个类别标签(分别用0、1、2表示山鸢尾、变色鸢尾和维吉尼亚鸢尾)。
data = load_iris()
y = data.target
x = data.data
变量y表示数据集中的类别标签,x表示属性数据。由于鸢尾花分为三类,降维后需根据y的值对这三类数据点分别进行绘图展示。
第一种方法依据上述PCA步骤,通过矩阵运算直接计算,最终获得降维结果:
import numpy as np
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt


def pca(dataMat, topNfeat):
    meanVals = np.mean(dataMat, axis=0)
    meanRemoved = dataMat - meanVals  # 标准化(去均值)
    covMat = np.cov(meanRemoved, rowvar=False)
    eigVals, eigVets = np.linalg.eig(np.mat(covMat))  # 计算矩阵的特征值和特征向量
    eigValInd = np.argsort(eigVals)  # 将特征值从小到大排序,返回的是特征值对应的数组里的下标
    eigValInd = eigValInd[:-(topNfeat + 1):-1]  # 保留最大的前K个特征值
    redEigVects = eigVets[:, eigValInd]  # 对应的特征向量
    lowDDatMat = meanRemoved * redEigVects  # 将数据转换到低维新空间
    # reconMat = (lowDDatMat * redEigVects.T) + meanVals  # 还原原始数据
    return lowDDatMat


def plotPCA(lowMat):
    reconArr = np.array(lowMat)
    red_x, red_y = [], []
    blue_x, blue_y = [], []
    green_x, green_y = [], []
    for i in range(len(reconArr)):
        if y[i] == 0:
            red_x.append(reconArr[i][0])
            red_y.append(reconArr[i][1])
        elif y[i] == 1:
            blue_x.append(reconArr[i][0])
            blue_y.append(reconArr[i][1])
        else:
            green_x.append(reconArr[i][0])
            green_y.append(reconArr[i][1])
    plt.scatter(red_x, red_y, c='r', marker='x')
    plt.scatter(blue_x, blue_y, c='b', marker='D')
    plt.scatter(green_x, green_y, c='g', marker='.')
    plt.show()


if __name__ == '__main__':
    data = load_iris()
    y = data.target
    x = data.data
    matx = np.mat(x)
    lowDMat = pca(matx, 2)
    plotPCA(lowDMat)
第二种方法则是调用sklearn库中的PCA算法来实现:
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA  # 加载PCA算法包
from sklearn.datasets import load_iris
import numpy as np

data = load_iris()
y = data.target
x = data.data
pca = PCA(n_components=2)  # 加载PCA算法,设置降维后主成分数目为2
reduced_x = pca.fit_transform(x)  # 对样本进行降维
# reduced_x = np.dot(reduced_x, pca.components_) + pca.mean_  # 还原数据

red_x, red_y = [], []
blue_x, blue_y = [], []
green_x, green_y = [], []
# print(reduced_x)
for i in range(len(reduced_x)):
    if y[i] == 0:
        red_x.append(reduced_x[i][0])
        red_y.append(reduced_x[i][1])
    elif y[i] == 1:
        blue_x.append(reduced_x[i][0])
        blue_y.append(reduced_x[i][1])
    else:
        green_x.append(reduced_x[i][0])
        green_y.append(reduced_x[i][1])
plt.scatter(red_x, red_y, c='r', marker='x')
plt.scatter(blue_x, blue_y, c='b', marker='D')
plt.scatter(green_x, green_y, c='g', marker='.')
plt.show()
在第二个代码示例中,需特别说明fit_transform()函数。该函数结合了fit()和transform()两个函数的功能,相当于先执行fit()再执行transform()。在sklearn库中,这两个函数频繁出现:fit()用于计算传入数据集的固有属性(如方差、均值等),类似于训练过程;transform()则对训练后的数据集执行相应操作(如归一化、降维等)。不同模块中这两个函数的具体实现有所差异,例如在PCA模块中,fit()主要执行去均值操作,而transform()执行降维操作。
运行上述两种代码后,生成的图像如下所示(图一对应第一种代码,图二对应第二种代码):
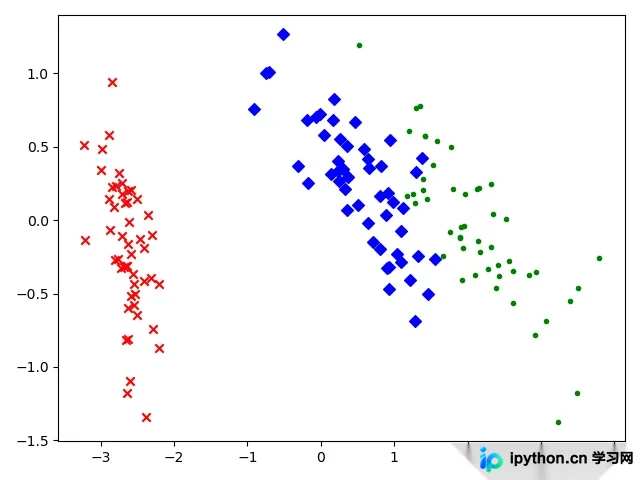
图一
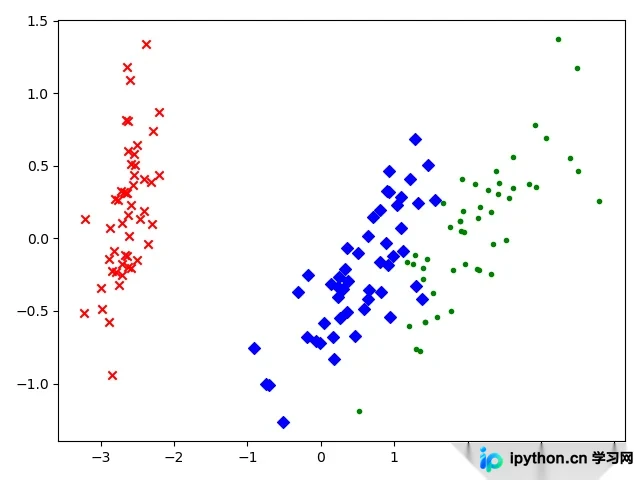
图二
观察可见,第一种代码生成的图像与第二种代码生成的图像关于y=0直线对称。具体原因尚不明确(后续如有时间将探究其成因),但这并不影响降维的最终结果。
降维前的部分数据如下:
降维后的部分数据如下:
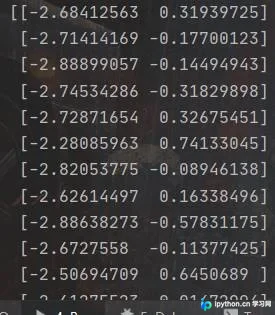
因此,利用降维后的二维数据集即可表示降维前四维数据集的大部分信息。
降维后的数据可通过逆操作进行还原,具体原理不再赘述。相关操作代码已在代码注释中给出,但重建后的数据与原始数据之间会存在一定误差(如下所示)。
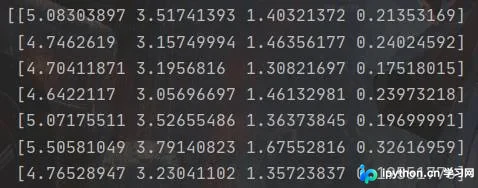
产生误差的原因可理解为:原始数据处于四维空间,PCA降维至二维空间时,仅保留了投影方差最大的两个轴向,而舍弃了另外两个相对不重要的特征轴,从而导致部分信息丢失,进而产生重构误差。
总结
本文介绍了Python中PCA降维的两种实现方法。如需了解更多Python PCA降维相关内容,请搜索本站往期文章或继续浏览后续文章。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









