

Python机器学习K近邻算法(KNN)原理与实战详解

本文详解Python中K近邻算法(KNN)的核心原理、优缺点及API调用方法。通过预测酒店入住位置的完整案例,演示从数据清洗、时间特征工程、标准化到模型训练与评估的全流程,帮助开发者掌握KNN在小规模数据集上的实际应用。
一、k-近邻算法原理及API
1.k-近邻算法原理
K近邻算法的核心逻辑在于:若一个样本在特征空间中与其最邻近的k个样本中,大多数归属于某一特定类别,则该样本也大概率属于该类别。这意味着,具有相似特征的样本,其在特征空间中的数值表现应当是相近的。
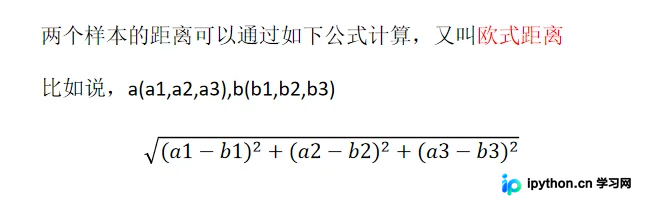
计算样本间距离是算法的基础步骤,常用的距离度量方式包括欧氏距离、曼哈顿距离等。
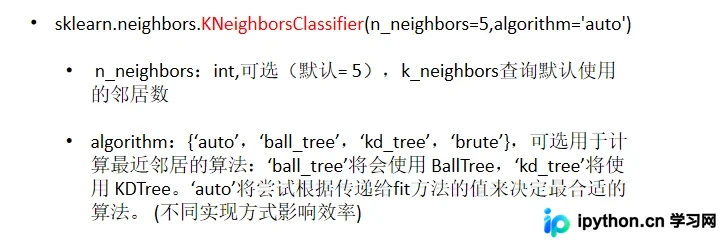
2.k-近邻算法API
3.k-近邻算法特点
当k值设置过小(如k=1)时,模型对噪声数据或异常点极为敏感,容易导致过拟合。
当k值设置过大时,分类决策会受到邻近样本中各类别数量的波动影响,可能导致边界模糊,降低分类精度。
该算法的主要优点包括:原理简单直观,易于理解和实现;无需进行参数估计或复杂的模型训练过程(即无迭代训练步骤)。
其主要缺点在于:属于典型的“懒惰学习”算法,在预测阶段需要计算与所有训练样本的距离,导致测试时的计算量大且内存占用高。
综上所述,使用KNN算法时必须合理指定k值,否则无法保证分类精度。此外,由于计算复杂度随样本数量线性增长,当数据量极大时算法耗时显著增加,因此该算法更适用于小规模数据集的场景。
二、k-近邻算法案例分析案例信息概述
本案例以预测客人入住位置(假设为酒店)为例。预处理后的数据特征包括:酒店编号(place_id)、入住登记ID(row_id)、客人横坐标(x)、客人纵坐标(y)、时间戳(time)以及客人定位准确度(accuracy)。
我们的目标是预测客人将入住哪个编号的酒店,这属于典型的分类问题。基于KNN算法,我们通常假设客人会选择距离最近的酒店,但实际入住行为还受入住时间和定位准确度等其他因素影响。
因此,在数据预处理的第一步,需全面考虑所有可能影响客人入住决策的因素,例如客人的地理坐标、具体入住时间以及定位准确度等。
接下来对特征进行筛选和处理,将关键特征加入列表,剔除无关特征或筛选部分数据。处理完成后,将目标变量单独提取为y_train,利用x_train和y_train对算法进行训练。
第一部分:处理数据
1.数据量缩小
假设已导入data数据,鉴于原始数据量过于庞大,为了提升演示效率,需要对数据进行采样缩小。
代码:
data.query('x>0.1 & x<0.2 & y>0.5 & y<0.6')通过筛选x坐标范围和y坐标范围来缩小数据集合。
2.处理时间
原始数据中的时间字段为时间戳格式,需使用pd.to_date_time函数进行转换。
代码:
time = pd.to_date_time(data['time'], unit='s')转换后的时间格式示例如下:1970-01-01 18:09:40。
3.进一步处理时间
将转换后的时间提取出来,转换为可任意提取年、月、日、时、分、秒的字典格式。
代码:
time_value = pd.DatetimeIndex(time)4.提取并构造时间特征
将提取出的时间特征以新的特征名直接添加到原数据表中,可根据需要添加多个时间维度特征。
代码:
data['day'] = time_value.day5.删除无用特征
使用drop方法,设置axis=1表示删除整列。任何被认为无用的特征均可通过此方法移除。
代码:data = data.drop(['row'], axis=1)
6.签到数量少于3次的地点,删除
首先对数据进行分组,以地点(place_id)为分组依据,统计其他特征基于该地点的数量。
代码:
place_count = data.groupby('place_id').count()此时返回的数据表中,索引为地点place_id,其他特征列的数据变为基于place_id进行的数量统计结果。
关于groupby().count()的解释,以一个简单的数据为例:
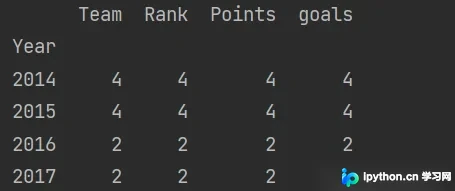
假设原特征有5个,分别为:year, team, rank, points, goals,现在按照year来分组并统计数量,那么第一行第一列的数据“4”,意思就是:在2014年,有4个team。
回到本例,row_id代表的是“登记事件的id”,也就是说每次有人登记入住一个place,那么place_id对应的就会有一个row_id数据出现。若同一个地方有三个人登记了,那么同一个place_id对应的row_id就会有三个。
因此,本例中按照groupby.count()处理之后,place_id和row_id对应的关系就是:在place_id中的a这个地方,row_id对应的数量为3。也就是相当于在a地点,有3人登记入住了。
接下来,将入住人数少于3的place_id删除:
place_count[place_count.row_id>3]
# 选择入住人数大于三人的数据

tf = place_count[place_count.row_id>3].reset_index() #将索引重置,place_id还放回到特征

data = data[data['place_id'].isin (tf.place_id)]
#对data中的数据进行筛选
7.提取目标值y
提取目标值后,需将原数据表中的目标值那一列删除,仅保留特征列。
y = data['place_id']
x = data.drop(['place_id'], axis=1)
8.数据分割
前面需要导入分割方法:from sklearn.model_selection import train_test_split。
代码:
x_train, x_test, y_train,
 y_test = train_test_split(x, y, test_size=0.25)
至此,数据处理完毕。数据处理过程中,我们需要考虑有哪些数据是需要舍弃的,有哪些是需要我们构造的,是否需要对特征进行筛选,条件如何设置等。最终,将我们需要的目标值提取出来,剩余的作为训练集。并调用分割方法,按一定的比例进行数据分割。(此处25%的数据作为测试集)
第二部分:特征工程
标准化
先导入标准化类:from sklearn.preprocessing import StandardScaler。
训练集和测试集在标准化时,所使用的均值与标准差均基于训练集计算。因此,对测试集进行标准化时,只需调用transform方法即可,避免数据泄露。
x_train = std.fit_transform(x_train)

x_test = transform(x_test)
第三部分:进行算法流程
1.算法执行
先导入算法:from sklearn.neighbors import KNeighborsClassifier。
使用该算法,将训练集数据输入,即可训练完毕,得到一个模型。
代码:
knn = KNeighborsClassifier(x_train, y_train)2.预测结果
使用predict方法,输入测试集数据即可得出预测的y值。
代码:
y_predict = knn.predict(x_test)3.检验效果
使用score方法,输入测试集数据以及测试集的目标值,即可得出模型分数。
代码:
score = knn.score(x_test, y_test)
以上就是python机器学习基础K近邻算法详解KNN的详细内容,更多关于python机器学习K近邻算法的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









