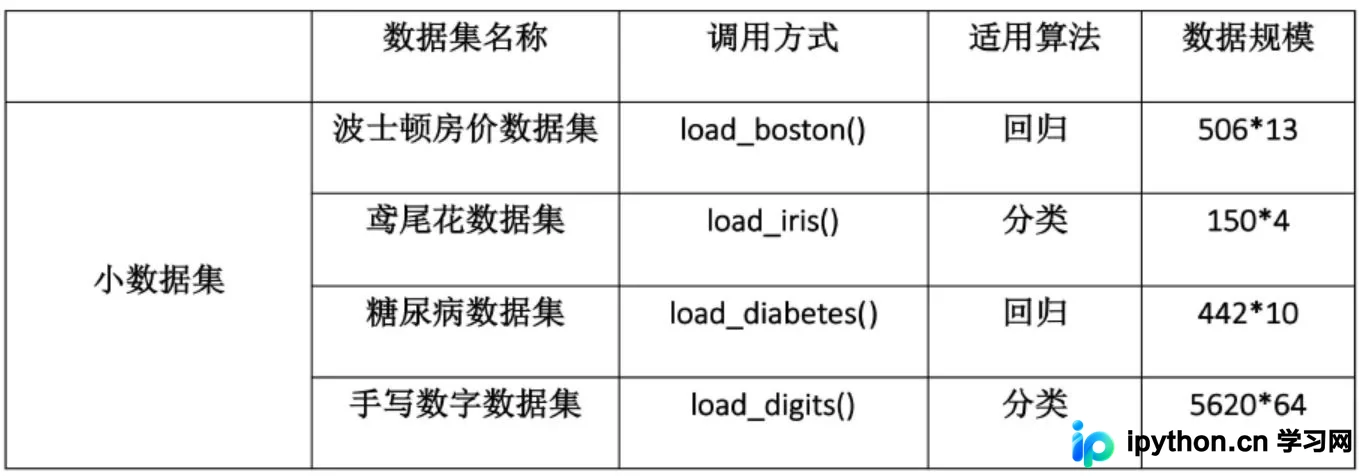
Python与AI分析时间序列数据
本文介绍如何使用Python进行时间序列数据分析。内容涵盖Pandas库的安装与使用,包括数据读取、切片、统计提取及重采样;同时详解隐马尔可夫模型(HMM)在序列预测中的应用,涵盖其数学定义与状态转换概率矩阵等核心概念。
2026-10-15
8

本文介绍如何使用Python进行时间序列数据分析。内容涵盖Pandas库的安装与使用,包括数据读取、切片、统计提取及重采样;同时详解隐马尔可夫模型(HMM)在序列预测中的应用,涵盖其数学定义与状态转换概率矩阵等核心概念。
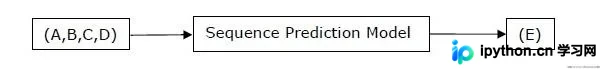
本文提供使用Python实现梯度下降算法和逻辑回归的完整代码。通过Iris数据集演示数据预处理、Sigmoid函数定义及随机梯度下降优化过程,并展示模型预测与结果保存方法,供开发者参考学习。
本文介绍基于 Python 的朴素贝叶斯分类算法实现。核心在于求解贝叶斯方程,通过假设特征独立简化计算。尽管现实特征常相关导致准确率牺牲,该算法仍具实用价值。文中提供完整 Scratch 代码示例,涵盖模型训练、预测及准确率评估流程。
本文深入分析人工智能专业本科生与研究生在就业市场中的真实竞争力差异。通过拆解算法岗、开发岗等不同职业路径的门槛,揭示学历对起薪、晋升及核心研发机会的影响,帮助读者理性判断是否必须考研。
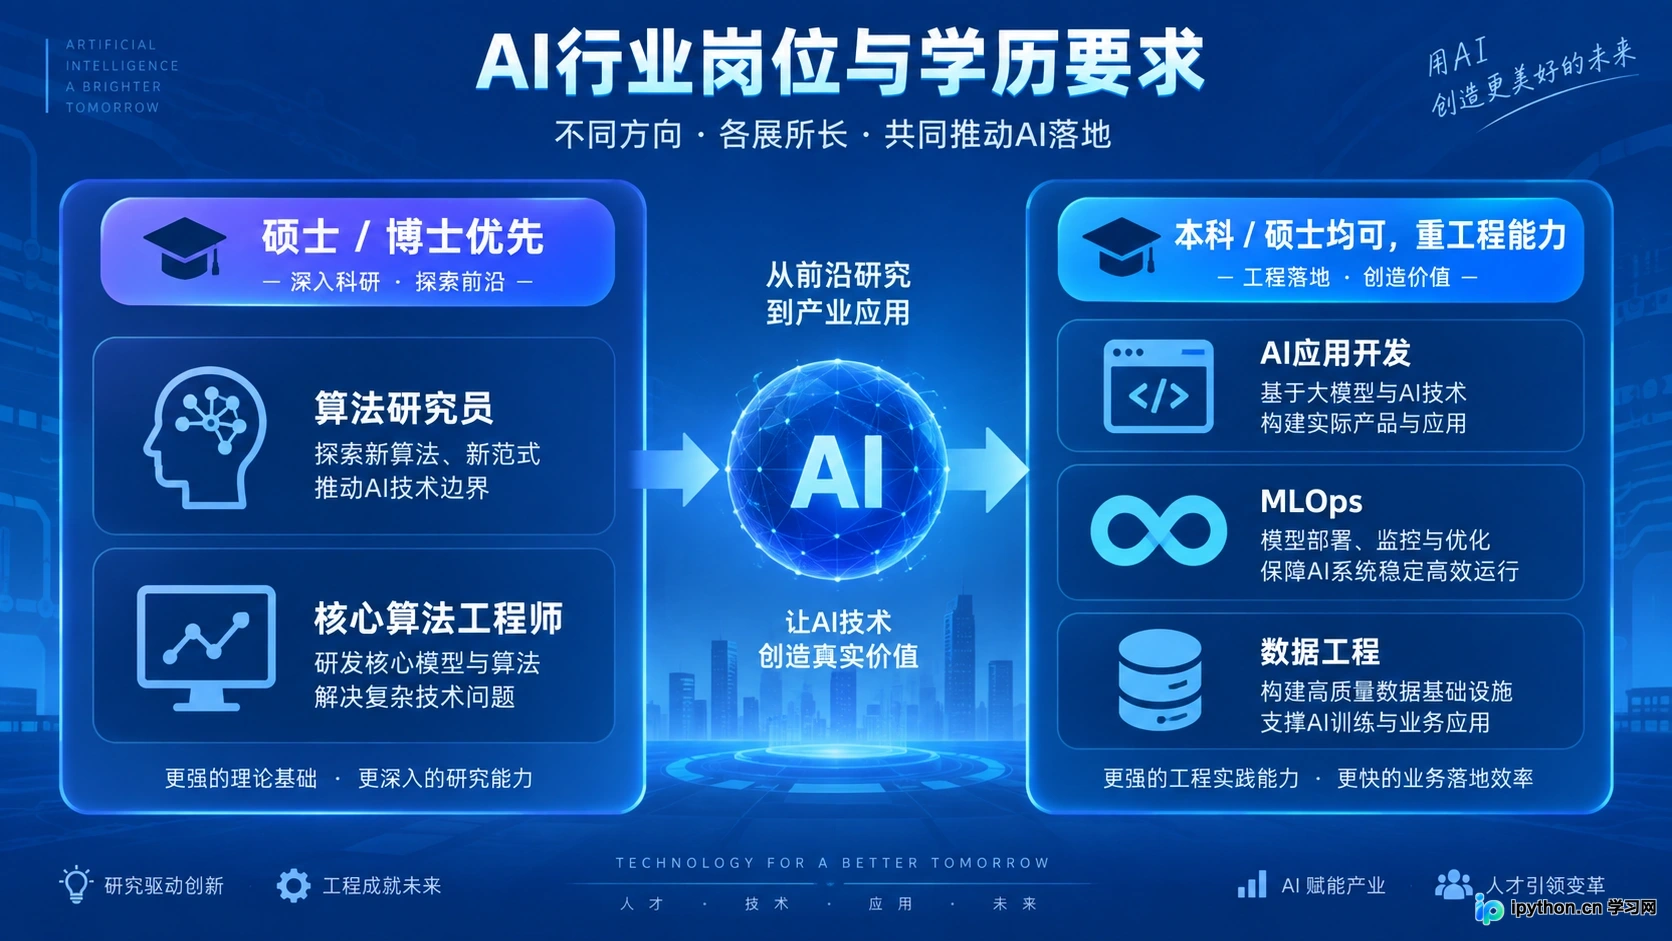
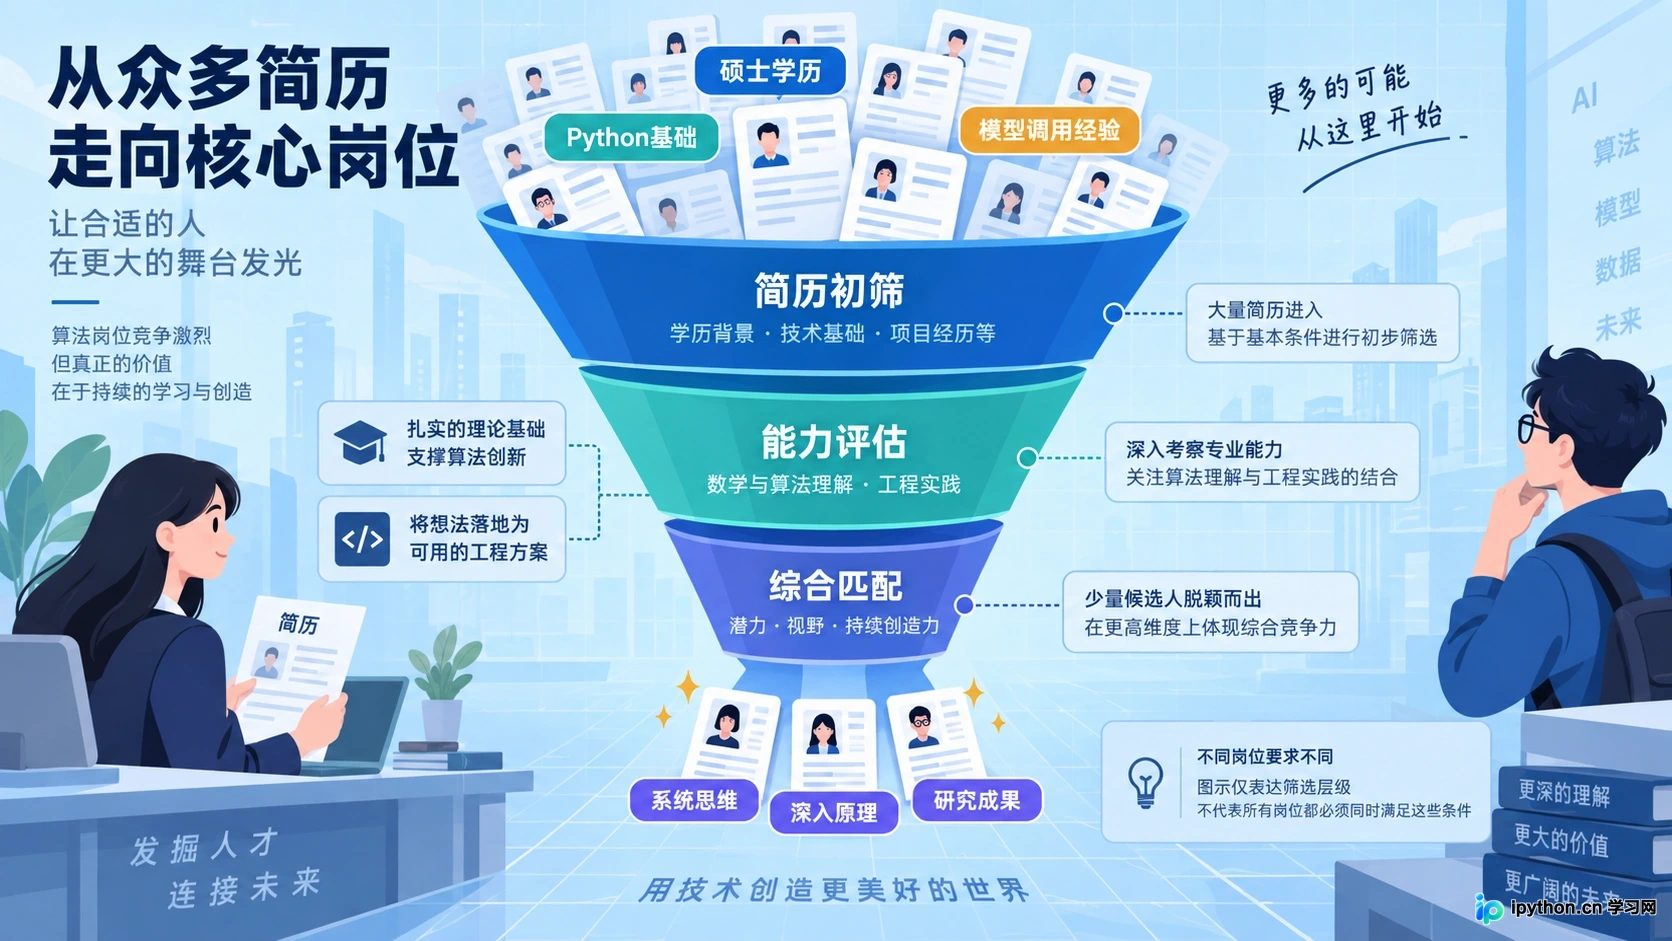
人工智能专业并非全面饱和,而是呈现结构性失衡。初级算法岗位竞争激烈,但具备工程落地能力、跨学科背景及垂直行业经验的复合型人才依然稀缺。本文通过分析招聘市场现状,指出从“调参侠”向“AI工程师”转型的必要性,为从业者提供破局思路。
本文介绍了五个使用Python进行数据清理的实用脚本,涵盖从PDF提取表格、合并多个CSV文件、删除重复行、拆分列以及合并不同数据集等常见场景。通过Pandas库实现自动化处理,显著提升机器学习前的数据准备效率,适用于Tableau等可视化工具及各类模型训练前的数据预处理环节。
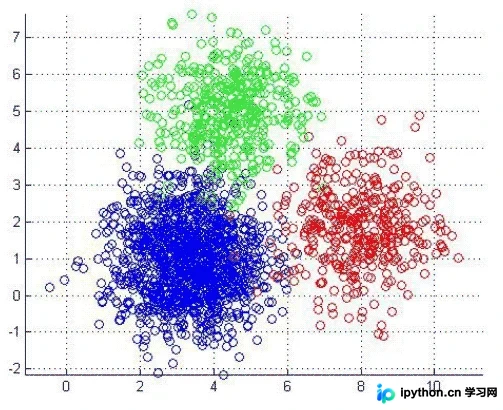
本文详细介绍Python中层次聚类算法的原理与实现。涵盖自下而上与自上而下两种策略,解析完全链接、单链接、平均链接及质心链接等距离度量方法。结合SciPy库代码示例,演示如何使用Ward法生成树状图,并指导通过树状图确定最优聚类数量。
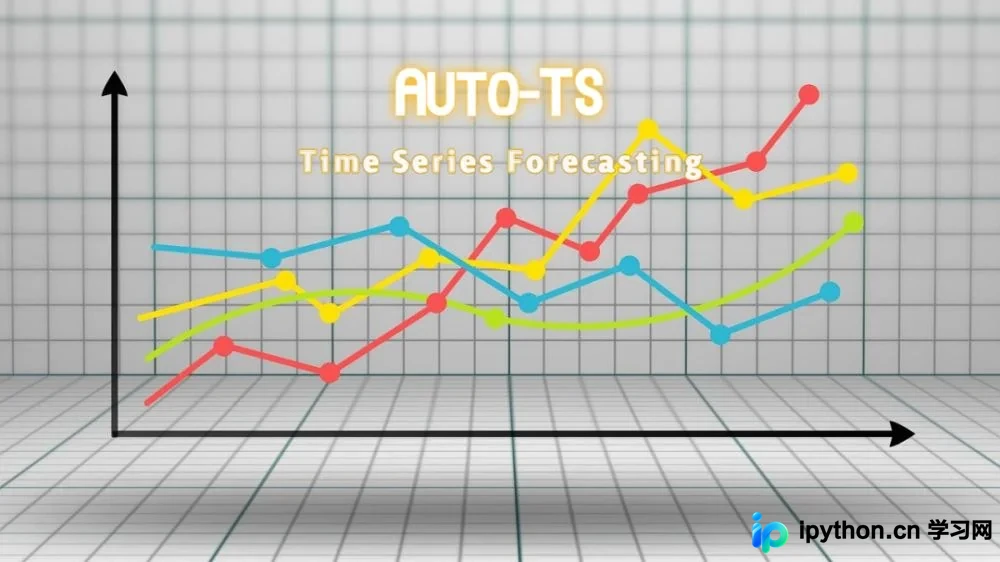
AutoTS是一个开源Python库,旨在通过一行代码自动化训练ARIMA、SARIMAX、FB Prophet和VAR等多个时间序列模型。它利用遗传规划优化和交叉验证技术,自动处理数据预处理、异常值删除及最佳NaN值学习,从而快速生成最强时序基线模型,适合初学者及需要快速评估多种算法的场景。
本文介绍如何在Python中利用mlxtend库实现Apriori关联规则算法。通过导入TransactionEncoder和apriori模块,演示数据预处理、频繁项集挖掘及关联规则生成的完整流程。重点讲解min_support、min_threshold及lift参数的配置方法,并结合具体水果数据集展示代码实现与结果分析。
本文详细介绍pandas中scatter_matrix函数的用法,涵盖frame、alpha、figsize、diagonal等关键参数。通过sklearn的iris样本进行实战演示,展示如何配置颜色、标记及直方图选项,生成特征间关系的矩阵散点图,帮助开发者快速掌握多维数据的可视化技巧。
本文详细介绍Python中NumPy库的基础操作,涵盖数组与矩阵的创建方法、元素级与矩阵级运算规则、常用统计函数以及高效的索引与切片技巧。适合机器学习初学者掌握数据处理核心技能,通过具体代码示例解析广播机制、累加累乘及多维数组访问方式。
本文详细介绍Python中两大核心库NumPy与Scikit-learn的基础应用。涵盖NumPy数组创建、内存优势及常用数值计算方法,并系统讲解Sklearn的监督与无监督学习模块、数据变换工具及标准API调用流程,助力快速上手机器学习实践。