3个用于数据科学的顶级Python库
本文介绍了数据科学领域最核心的三个Python库:NumPy、Pandas和Matplotlib。NumPy提供高效的多维数组计算能力;Pandas通过DataFrame处理结构化数据;Matplotlib则负责生成各类可视化图表。文章包含具体的代码示例,展示了如何创建数据框并绘制条形图,帮助开发者快速上手Python数据分析。
2026-10-12
7

本文介绍了数据科学领域最核心的三个Python库:NumPy、Pandas和Matplotlib。NumPy提供高效的多维数组计算能力;Pandas通过DataFrame处理结构化数据;Matplotlib则负责生成各类可视化图表。文章包含具体的代码示例,展示了如何创建数据框并绘制条形图,帮助开发者快速上手Python数据分析。
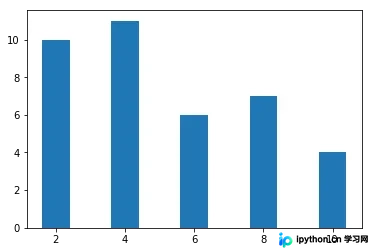
本文介绍如何使用 TensorFlow 实现一个简单的逻辑回归模型。通过定义占位符、变量、损失函数及优化器,演示了从数据生成到模型训练的全过程。代码包含权重初始化、Sigmoid 激活函数应用及 Adam 优化器配置,并附带训练误差曲线可视化,帮助理解逻辑回归在分类任务中的基本实现原理。
本文深入解析人工智能专业的核心课程体系,重点剖析线性代数、概率论等数学基础的实际应用价值,并客观评估编程与算法的学习难度。通过拆解从理论推导到工程落地的完整路径,帮助读者厘清AI专业的真实门槛,判断自身是否适合投身这一领域。
本文探讨普通二本院校人工智能专业学生的职业发展路径。分析院校层次在求职初期的筛选作用,对比学历背景与个人能力在长期发展中的权重,提供从基础夯实到项目实战的具体建议,帮助非顶尖院校学生打破就业壁垒。
本文深入剖析人工智能训练师与数据标注员在职责、技能要求及职业路径上的本质差异。通过具体工作场景对比,揭示从“数据加工”到“模型优化”的跃迁逻辑,帮助从业者明确职业定位,避免陷入低水平重复劳动的误区,为向高阶AI岗位转型提供清晰指引。
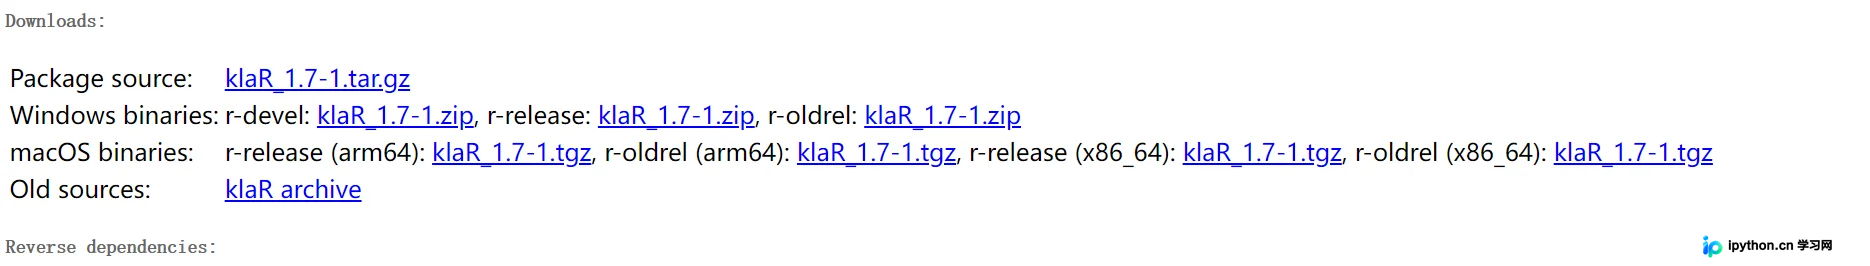
在R语言进行机器学习开发时,常因版本兼容性问题需要手动升级或降级特定包。以解决klaR包报错为例,详细介绍如何通过CRAN Archive安装历史版本,包括卸载旧包、指定tar.gz源码路径及重新安装的全过程,确保模型训练环境稳定。
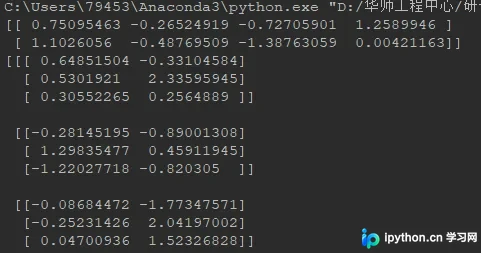
本文深入解析Python numpy库中np.random.seed()函数的核心机制与使用场景。通过对比实验,验证随机数种子对后续随机数生成的持续性影响,并探讨不同参数值如何确定随机序列的起始位置。文章指出种子参数仅作用于其定义后的下一次随机数生成,帮助开发者在机器学习和深度学习实验中实现结果的可复现性。
本文介绍如何使用Python实现多元线性回归,重点讲解梯度下降算法。通过定义代价函数与偏导数计算,迭代更新参数theta0、theta1和theta2。示例展示从数据读取、模型训练到可视化拟合平面的完整流程,1000次迭代后损失值显著降低,适用于机器学习入门与模型部署参考。
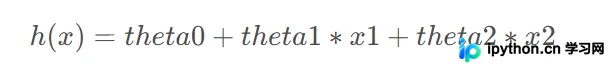
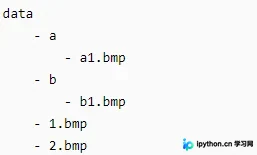
本文详解Python中遍历读取目录的两种常用方法:os.listdir与os.walk。os.listdir仅获取当前层级文件列表,而os.walk可递归遍历所有子目录。文章通过具体代码示例对比两者返回值差异,并提供了支持多后缀过滤、递归/非递归选项的完整封装函数,帮助开发者高效处理机器学习或深度学习中的文件读取需求。
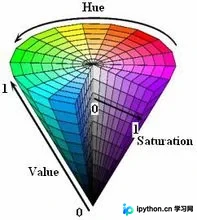
本文介绍如何利用Python和OpenCV进行HSV颜色分割,以交通信号灯检测为例。详细解析HSV模型中H、S、V参数的含义及取值范围,并通过createTrackbar函数实现阈值动态调整,最终生成掩码以提取感兴趣区域,提升识别准确率。
本文基于Python展示传统机器学习在行人检测中的应用流程。通过skimage库提取HOG特征向量,分别训练决策树、随机森林和SVM模型。文章详细记录了数据预处理、特征提取、模型训练及性能对比(精确率、召回率、F1值)的全过程,并展示了SVM在测试中的最佳表现,旨在提供完整的机器学习检测实践参考。
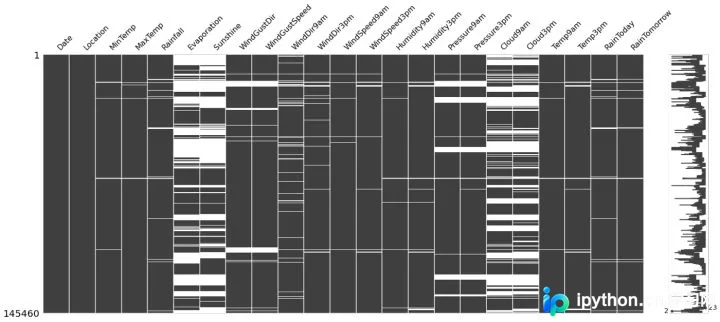
本文详细介绍利用Python进行数据清洗的核心步骤。涵盖缺失值的分析与填补策略、基于IQR的异常值识别与裁剪、字符型数据不一致性的手动修正,以及无效数据的逻辑校验。重点强调在预处理前必须拆分数据集以规避数据泄漏,并推荐使用sklearn Pipeline简化流程,确保模型评估的独立性。